MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework
MetaGPT: Meta Programming for a Multi-Agent Collaborative Framework — L2 #
1. TL;DR #
将人类软件公司的 SOP 编码进 prompt 序列,把复杂任务拆给 5 个专职 agent(PM/架构师/项目经理/工程师/QA),用共享消息池 + 发布-订阅传递结构化文档(而非自由对话),再加可执行反馈自纠错。HumanEval/MBPP Pass@1 达 85.9%/87.7%(SoTA),SoftwareDev 可执行性 3.75、人工修订成本降到 0.83。
2. Q1 / Q2 / Q3 #
Q1 — 痛点 #
朴素地把多个 LLM 串成对话式多智能体,会因级联幻觉(cascading hallucination)导致逻辑不一致:每一轮自由对话都像"传声筒游戏"逐渐扭曲原始信息,还会陷入"重复指令"或"消息无限循环"。此前的角色扮演框架(CAMEL、ChatDev)只能解决简单对话任务,无法系统性地把抽象需求拆解为可执行的复杂软件工程。
Q2 — 方法 #
把领域内经过人类长期协作沉淀的 Standardized Operating Procedures(SOP) 编码为 prompt 序列,让每个 agent 承担明确角色并产出结构化中间制品(PRD、数据结构、接口定义、序列流程图),而非自由聊天。角色间通过全局共享消息池 + 基于角色 profile 的发布-订阅传递这些文档;工程师用可执行反馈(executable feedback)循环:写码→跑单元测试→报错则对照 PRD/设计/历史记忆调试,最多重试 3 次。
核心技术壁垒:让 SOP 落地为一组可被 LLM 稳定消费的结构化 schema 交接契约——每个角色的输出被约束成下游角色能直接解析的规范文档(File List、Data Structure、Interface Definition、Sequence Flow),从而把"传声筒式"信息损耗压到最低。这不是简单加角色,而是设计一套让抽象需求逐级具体化、且每级都可校验的中间表示。详见 §7。
Q3 — 结果 #
HumanEval/MBPP 单次尝试 Pass@1 达 85.9%/87.7%,超过所有基线(含 GPT-4 原生);在自建 SoftwareDev 上可执行性 3.75(满分 4)、人工修订成本 0.83(ChatDev 为 2.5),100% 任务完成率。可执行反馈单独带来 +4.2%/+5.4% Pass@1 提升。
3. 架构 / 方法图 — the agent loop #
MetaGPT 的每一轮 SOP 交接遵循固定的"观察消息池 → 依赖满足则触发 → React 式行动 → 产出结构化文档 → 发布回池"状态机:
上图是把 L1 §3.1 的五角色流水线与 §3.3 的可执行反馈循环合成的单轮状态视图:关键在于每条边传递的都是结构化制品,且工程师节点内含一个自纠错子循环(其余节点单次通过)。
论文自身的架构图对应两层:Figure 1 给出 MetaGPT 角色到真实软件团队角色的映射;Figure 2 给出通信协议(左:共享消息池 + 发布订阅)与可执行反馈(右:写码→运行→查错→调试)。
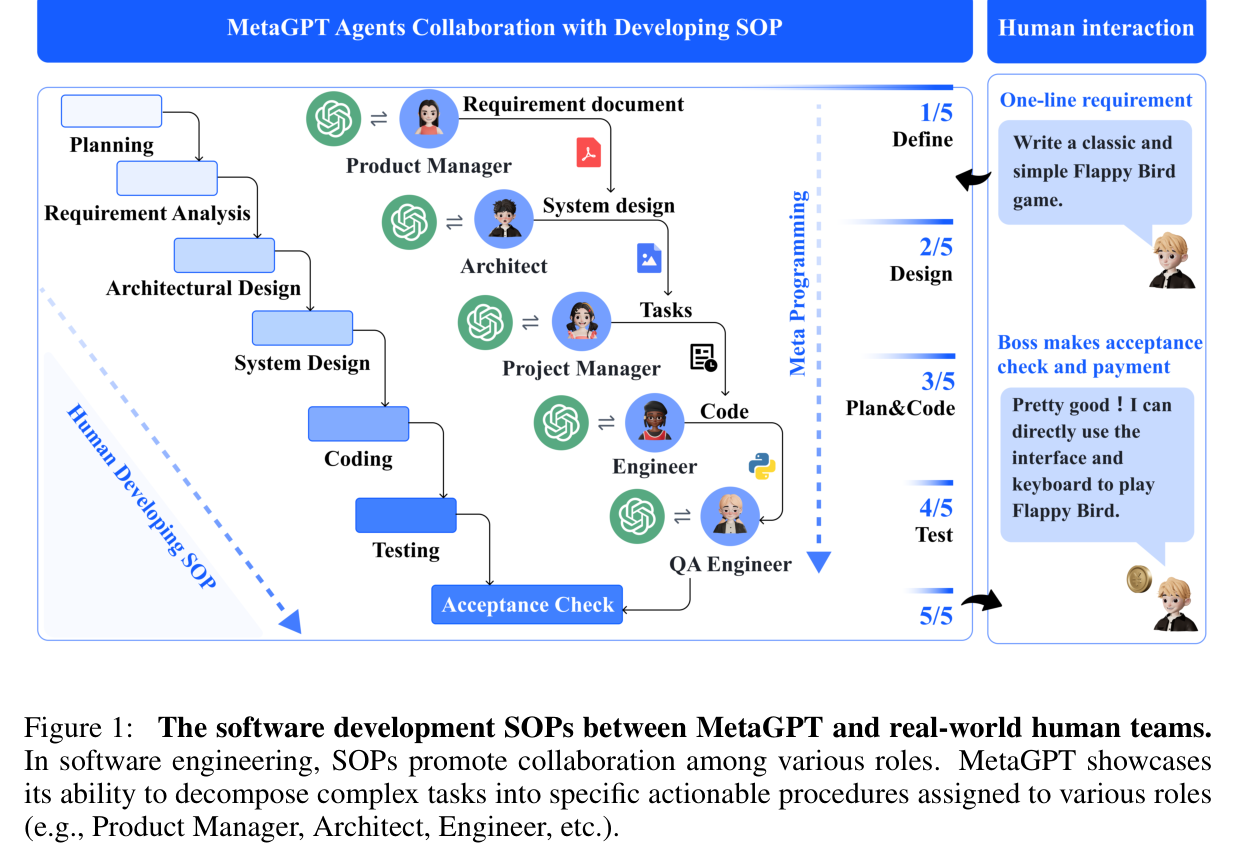
Paper's Figure 1, verbatim (caption: "The software development SOPs between MetaGPT and real-world human teams... MetaGPT showcases its ability to decompose complex tasks into specific actionable procedures assigned to various roles (e.g., Product Manager, Architect, Engineer, etc.)."). 该图确立了核心类比:MetaGPT 不是发明新协作模式,而是把成熟人类 SOP 一一对应到 agent 角色,读者应注意每个角色的输入/输出制品都对齐了真实团队的交接物。
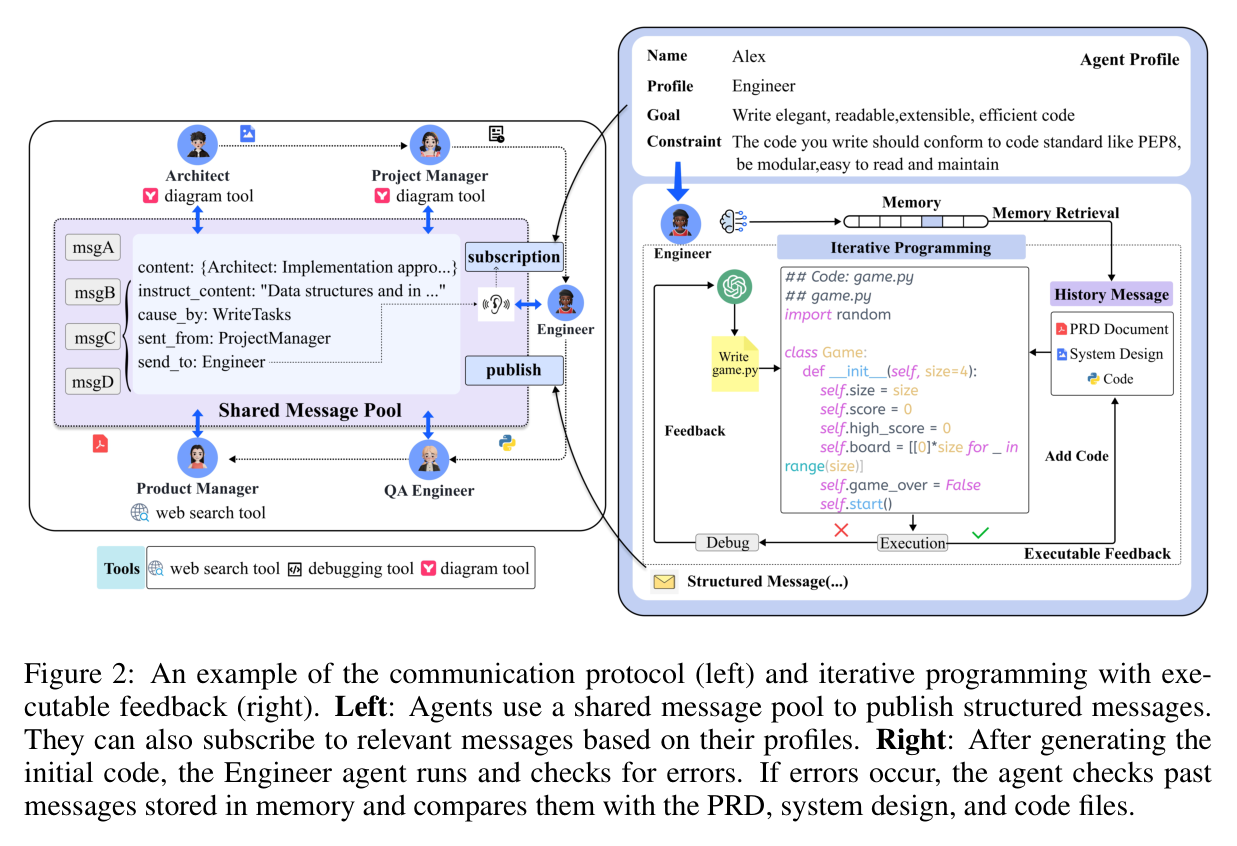
Paper's Figure 2, verbatim (caption: "An example of the communication protocol (left) and iterative programming with executable feedback (right). Left: Agents use a shared message pool to publish structured messages... Right: After generating the initial code, the Engineer agent runs and checks for errors..."). 左半是记忆/通信模型:短期上下文由共享消息池承载,agent 按 profile 订阅只取相关消息,避免信息过载;右半是错误恢复路径——测试失败时 agent 回退到"对照 PRD/设计/历史记忆重新调试"而非从零重来。
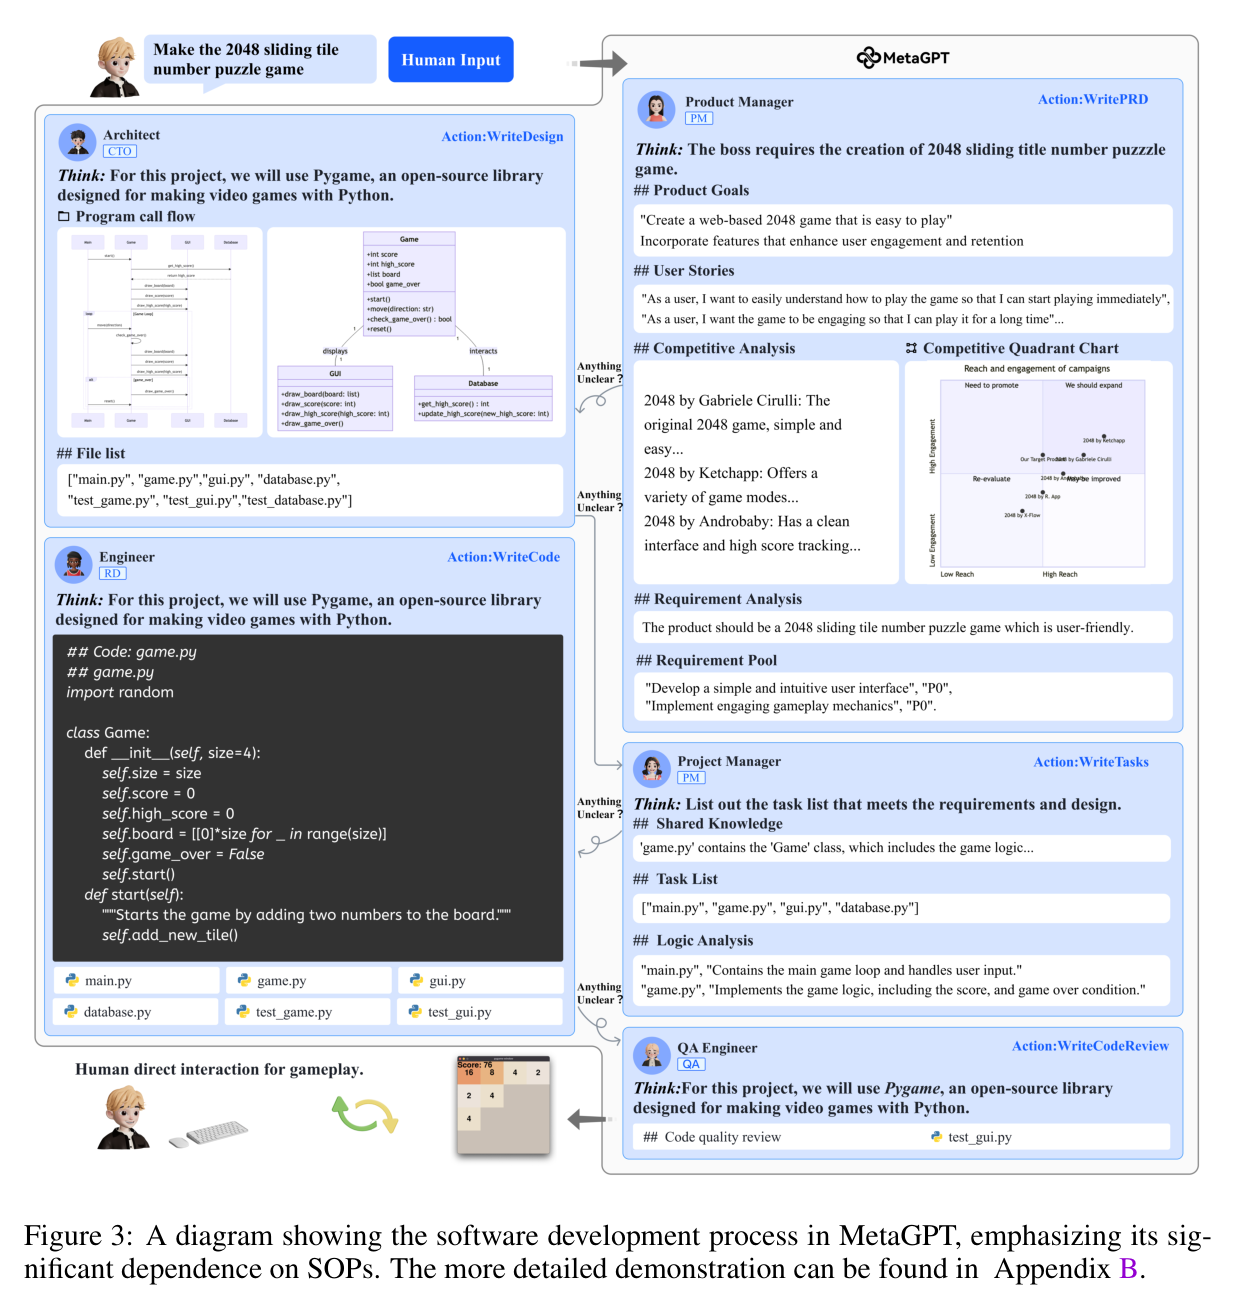
Paper's Figure 3, verbatim (caption: "A diagram showing the software development process in MetaGPT, emphasizing its significant dependence on SOPs..."). 此图展开完整 SOP 数据流,读者应注意架构师同时产出接口设计与序列流程图两类制品,且下游订阅关系是定向的(架构师主要订阅 PM 的 PRD,而非 QA 的输出)。
规划与推理:规划风格为预定顺序工作流(predetermined workflow)而非树搜索——SOP 把任务拓扑固定为 PM→架构师→项目经理→工程师→QA 的线性流水线;分解是自顶向下(需求→子任务→类/函数);预算体现在工程师的调试子循环上限(max 3 retries);回溯仅存在于工程师节点内(基于历史执行/调试记忆),跨角色不回溯。所有 agent 遵循 ReAct 式(think-then-act)行为。
4. 作者证明 #
无形式化作者证明 — 仅实证。 论文唯一的形式化对象是评测指标(无偏 Pass@k 估计量),而非方法本身的收敛/成功率保证。可被 bound 却未 bound 的量:多角色流水线的端到端成功率、级联幻觉的传播概率上界——论文只以实证 sweep 呈现单调性。
符号表(唯一公式 Pass@k):
| 符号 | 含义 |
|---|---|
| $n$ | 每个问题生成的样本总数 |
| $c$ | $n$ 个样本中正确的个数 |
| $k$ | 考虑的 top-k 样本数 |
| $\binom{\cdot}{\cdot}$ | 二项式系数 |
| $\mathbb{E}_{\text{Problems}}$ | 在基准问题集上取期望 |
方程物理意义:
$$\operatorname{Pass}@k = \mathbb{E}_{\text{Problems}}\left[1 - \frac{\binom{n-c}{k}}{\binom{n}{k}}\right]$$
其中 $\frac{\binom{n-c}{k}}{\binom{n}{k}}$ 是从 $n$ 个样本随机抽 $k$ 个全错的概率,故 $1-(\cdot)$ 是至少有一个正确的概率;在问题集上取期望即无偏 Pass@k,避免直接在 $k$ 个样本上估计的高方差。
6 项最小检查:
- 量纲:$\binom{n-c}{k}/\binom{n}{k}$ 为无量纲概率,$\operatorname{Pass}@k \in [0,1]$。✓
- 边界 $c=0$(无正确样本):分子 $\binom{n}{k}$=分母,比值为 1,Pass@k=0。✓ 物理合理。
- 边界 $c\ge k$ 且极端 $c=n$:分子 $\binom{0}{k}=0$,Pass@k=1。✓
- 单调性:$c$ 增大 → 全错概率减小 → Pass@k 增大。✓ 与"正确样本越多越易命中"一致。
- 一致性($k=1$):退化为 $\mathbb{E}[c/n]$,即平均正确率。✓
- 与实证一致:执行反馈把 Pass@1 提升 4.2%/5.4%(Figure 4),符合"更多可执行正确样本 → 更高 Pass@1"。✓
- 发布-订阅是定向的:agent 只在收齐其全部前置依赖后才激活行动(§3.2),且按角色 profile 过滤消息(架构师订阅 PRD、忽略 QA 输出),这是避免信息过载的关键,而非把消息池当广播。
- 可执行反馈的重试上限为 3(§3.3):工程师复用自身历史执行/调试记忆迭代,而非无限循环;这个硬上限是把"自纠错"与"无限消息循环"失败模式区隔开的隐性设计。
Success-rate sweep(实证):论文沿 (角色数, backbone 模型, 指令详略) 三轴 sweep。角色轴(Table 3):Engineer 单角色 → 4 角色,可执行性 1.0→4.0、人工修订 10→2.5,基本单调改善(但 3 角色配置里"加架构师"executability 2.5 > "加项目经理"2.0,非严格单调)。backbone 轴(Table 5):GPT-4 executability 3.8 > GPT-3.5 2.8 > Deepseek Coder 33B 1.4,强单调依赖后端能力。指令轴(Table 6):详细 prompt 4.0 略优于高层 prompt 3.8。
Latency budget:SoftwareDev 单任务约 503–541 秒(Table 1),GPT-4 后端约 553s,论文未宣称"交互式延迟",定位为离线批量软件生成。
Failure mode 分类:论文识别的失败类围绕代码幻觉(函数未完整实现、缺依赖、隐藏 bug)与跨文件依赖处理错误;主导失败类是"跨文件依赖 + 未捕获运行时错误"——可执行反馈机制正是针对这一类(把评审替换为真实运行+测试)。
5. 实验与数据 #
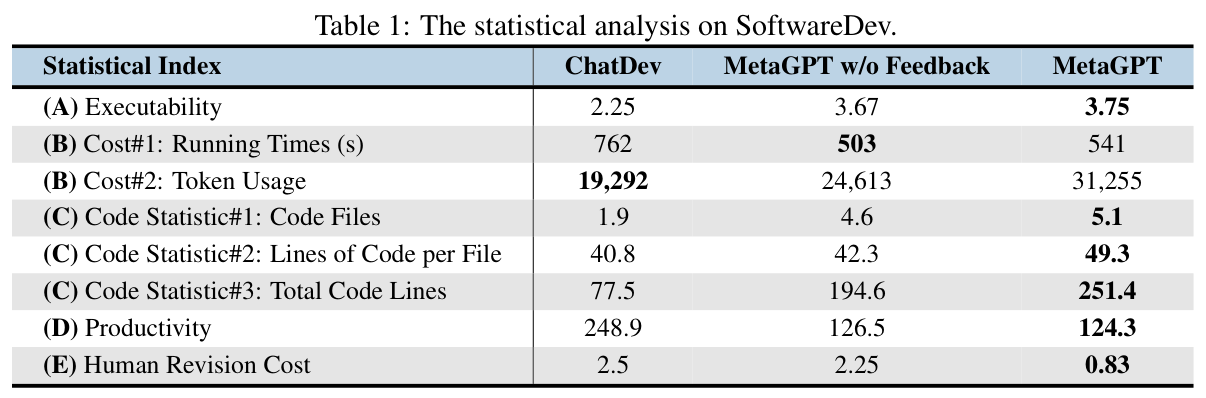
Paper's Table 1, verbatim (caption: "The statistical analysis on SoftwareDev"). 载重表:MetaGPT 可执行性 3.75 vs ChatDev 2.25,人工修订 0.83 vs 2.5。注意 MetaGPT 用了更多 token(31,255 vs 19,292)却更省 token/行(124.3 vs 248.9)——它靠生成远多代码(251.4 行 vs 77.5)赢得生产率,而非节流。
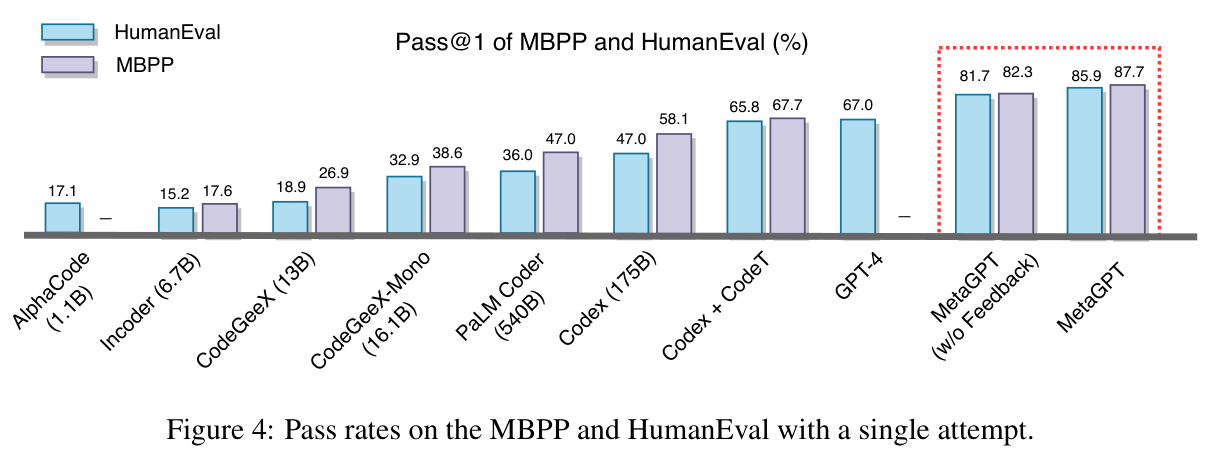
Paper's Figure 4, verbatim (caption: "Pass rates on the MBPP and HumanEval with a single attempt"). 该柱状图是主结果:MetaGPT 在两个公开基准上均超过所有基线与 GPT-4 原生;图中 "MetaGPT" 与 "MetaGPT + executable feedback" 的差值即 +4.2%/+5.4% 的反馈增益,读者应注意增益在 MBPP 上更大。
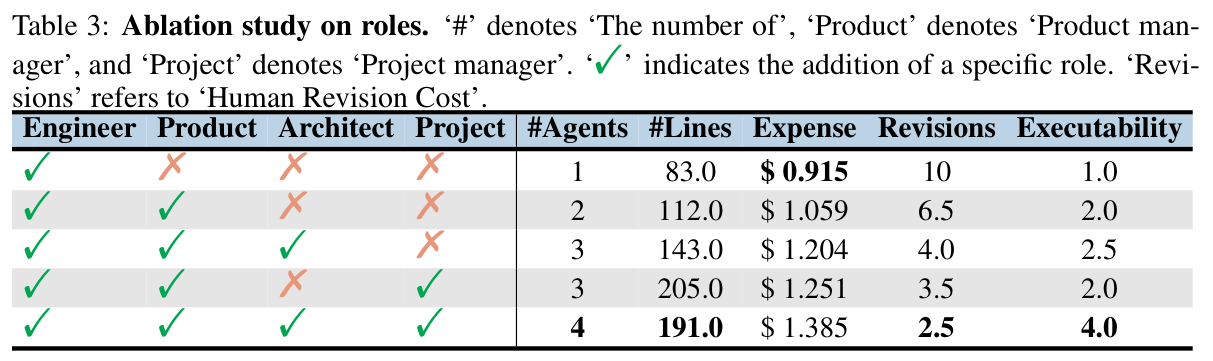
Paper's Table 3, verbatim (caption: "Ablation study on roles..."). 角色消融:从 1 角色到 4 角色,人工修订 10→2.5、可执行性 1.0→4.0。关键反直觉点:3 角色下"加项目经理"产出更多行(205 vs 143)却可执行性更低(2.0 vs 2.5),说明"更多代码/更多角色"并非单调提质,需完整 4 角色才达 executability 4.0。
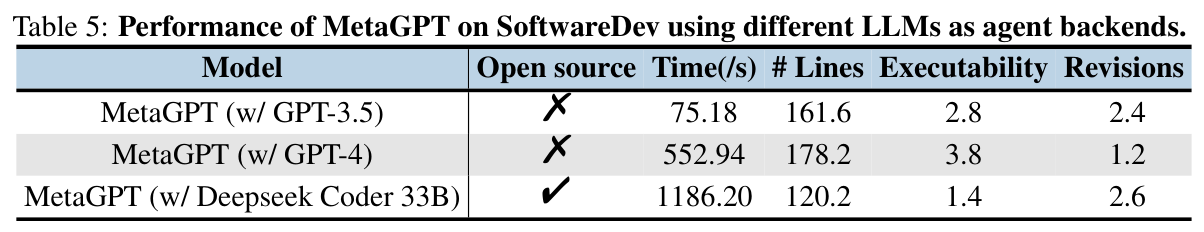
Paper's Table 5, verbatim (caption: "Performance of MetaGPT on SoftwareDev using different LLMs as agent backends"). 后端敏感性:开源 Deepseek Coder 33B 可执行性崩到 1.4(低于 GPT-3.5 的 2.8)且耗时 1186s——SOP 结构无法拯救较弱的 backbone,方法强依赖 GPT-4 级能力。
6. 论证链 #
| # | 论证步骤(paper-internal) | 依据 |
|---|---|---|
| 1 | 人类用 SOP 分解复杂任务、规定角色职责与中间产物标准,可保证一致准确执行 | §1 SOP motivation(Belbin/Agile/Peopleware) |
| 2 | 故将 SOP 编码进 prompt 序列,要求 agent 产出结构化文档而非自由对话,可减少歧义与级联幻觉 | §1 para 3,§3.2 telephone-game 论证 |
| 3 | 结构化制品需高效传递,引入共享消息池 + 发布-订阅,避免一对一通信的拓扑复杂与信息过载 | §3.2 publish-subscribe |
| 4 | 生成代码仍有运行时错误,故加可执行反馈循环(跑测试→调试,≤3 次),提升可执行性并降人工修订 | §3.3;Table 1(3.67→3.75,2.25→0.83) |
| 5 | 综合上述设计,在 HumanEval/MBPP 达 SoTA Pass@1,SoftwareDev 全面优于 ChatDev | §4.2,Figure 4,Table 1 |
7. 实现 cross-reference #
核心技术壁垒(§2 Q2 呼应):最难复制的不是"多角色"这一表层设计,而是把每个角色输出约束成下游可稳定解析的结构化 schema(PRD 的 User Stories/Requirement Pool、架构师的 File List/Data Structure/Interface Definition/Sequence Flow)。正是这套逐级具体化、每级可校验的中间表示,把自由对话的"传声筒"损耗替换为文档化交接,才使复杂需求能可靠地落到类/函数级实现。缺了这层 schema 契约,单纯加角色只会放大级联幻觉。
关键实现细节(易被忽略的 tricks):
实现引用:开源实现见 https://github.com/geekan/MetaGPT (L1 §0 Abstract、§1 para 6 均给出项目地址)。L1 未记录具体 file:line;方法级实现对应 §3.1(角色/profile 初始化)、§3.2(消息池+订阅接口)、§3.3(executable feedback action)。[实现未公开] 到 file:line 粒度。