TokenSim: Enabling Hardware and Software Exploration for Large Language Model Inference Systems
TokenSim — 深度解析(L2) #
1. TL;DR #
一个基于 SimPy 离散事件引擎的 LLM 推理系统模拟器:把可插拔的算子级 compute
backend(如 GenZ)与用户可自定义的两级调度器 + 细粒度内存管理器拼在一起,从
真实数据集采样动态请求负载,输出延迟分布与内存时序,对真实 vLLM 部署误差 <1%,
并首次支持 prefill/decode 分离(disaggregation)模拟。
2. Q1 / Q2 / Q3 #
Q1 — 痛点(这篇要解决什么) #
已有 LLM 推理模拟器(GenZ、LLMCompass)把输入限制为单请求或单 batch,只报告
单条 test case 的延迟与内存占用。但真实 serving 面对成百上千并发请求:用户满意度
绑定在尾延迟分布上,内存占用随请求进出动态变化。缺乏 continuous batching /
动态负载支持的模拟器,对真实工作负载给出的指标严重失真(§IV-A 就是用来证明这一点的)。
Vidur 用 random-forest 回归估算算子时间引入额外误差且每次运行前需 ~400s 预训练;
LLMServingSim 慢于实时且难以适配新模型/硬件。没有任何模拟器支持 prefill/decode 分离。
Q2 — 方法(怎么做的) #
TokenSim 用离散事件仿真把推理系统拆成四个可替换模块:
(i) 从数据集 + 参数生成动态请求流的 workload generator;
(ii) 两级调度器(global scheduler 分派请求到 worker,每个 worker 的 local scheduler
在 iteration 之间决定请求去留),二者均为用户自定义函数;
(iii) 任意粒度(block / token / byte)的内存管理器,跨节点组成一个大内存池,并含
一个通信模型按带宽算 KV cache 传输时延;
(iv) 可插拔的 compute simulator(如 GenZ)负责一次 iteration 的算力时间。
核心技术壁垒(THE single hardest-to-replicate insight):不是任何单一模块,而是
"breakpoint(算子级钩子)+ 两级调度器"这套抽象——它让 disaggregation 这类跨
worker 的 KV cache 迁移只需两行代码即可表达(在模型配置末尾挂 breakpoint:local
scheduler 把带新 token 的请求交回 global scheduler,global scheduler 再派给 decode
设备)。把"调度策略"与"硬件时间模型"彻底解耦、并让前者在算子级别可编程,是让同一个
模拟器覆盖 continuous batching / disaggregation / memory pool 三类异构优化而无需改内核
的关键,也是最难复刻的设计取舍。
Q3 — 结果(验证到什么程度) #
- 对真实 vLLM v0.6.2(LLaMA2-7B / A100 / 2000 条 ShareGPT 请求,多档 QPS):throughput
- 对 SOTA 模拟器:精度高于 Vidur 与 LLMServingSim(Table II),且无需 Vidur 的 ~400s
- 首次验证 disaggregated prefill/decode 模拟(对标 DistServe,2×A100,Fig 7)。
- 用它跑出 7 条对系统优化的反直觉洞见(§5 展开)。
几何平均误差 $0.109\%$;P50 / P99 / max 请求延迟误差 $0.6\%$ / $0.254\%$ / $0.337\%$,
整体 <1%。延迟 CDF 与真实硬件高度重合(Fig 5)。
预训练,运行更轻量灵活。
⚠️ 存疑:Table II 标称"latency percentage difference",但数值(2.7~13)随请求数单调增长
且各模拟器与"Local 真实硬件"高度接近——更像是总耗时(秒)而非百分比误差,与 §III-C
的 <1% 声明无法调和。这是论文自身未澄清的一处内部矛盾。
3. 架构 / 方法图 #
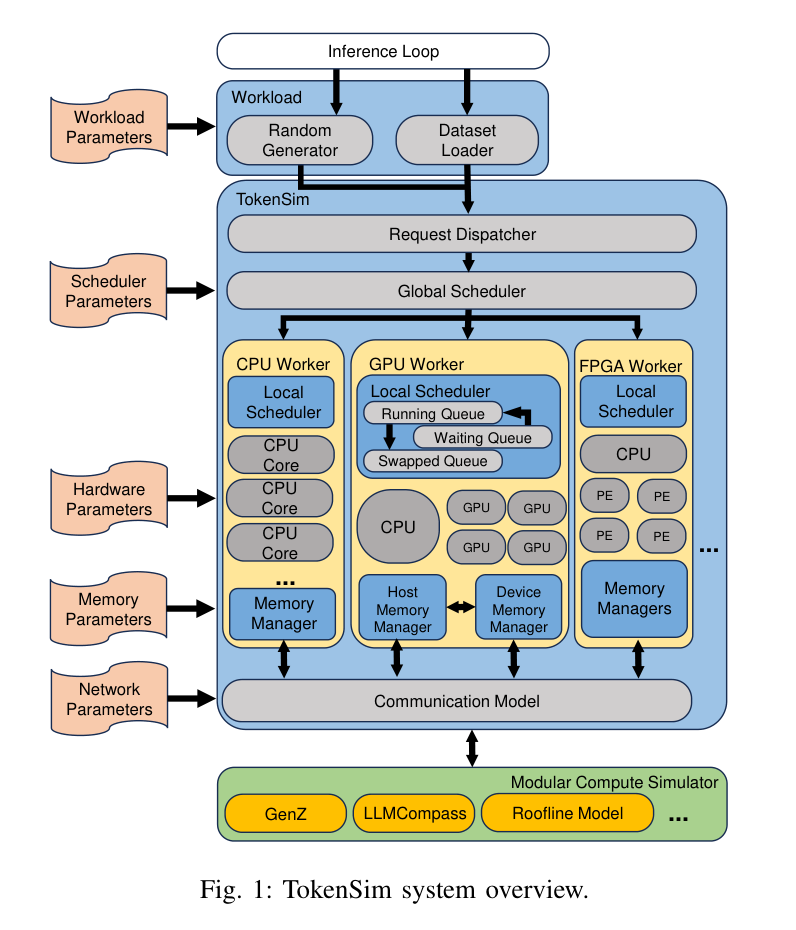
Paper's Figure 1(caption: "TokenSim system overview.")。 系统运行在一个跟踪全体
worker 仿真时间的 inference loop 中:workload 从数据集+参数生成 → dispatcher 交给
global scheduler → 按用户设定分派到各 worker。每个 worker 并发运行,由 **local
scheduler(多种算法)驱动,并与监控设备内存利用率的 memory manager** 协作。一旦
scheduler 为某次 iteration 组好 batch,就把信息送给 compute simulator(如 GenZ) 求
iteration 时间;发生跨设备数据搬运时,communication model 依网络参数连接 memory
manager 计算传输时延。读者应注意:compute backend 是可换的插槽,这正是它能覆盖多种硬件
配置的原因。
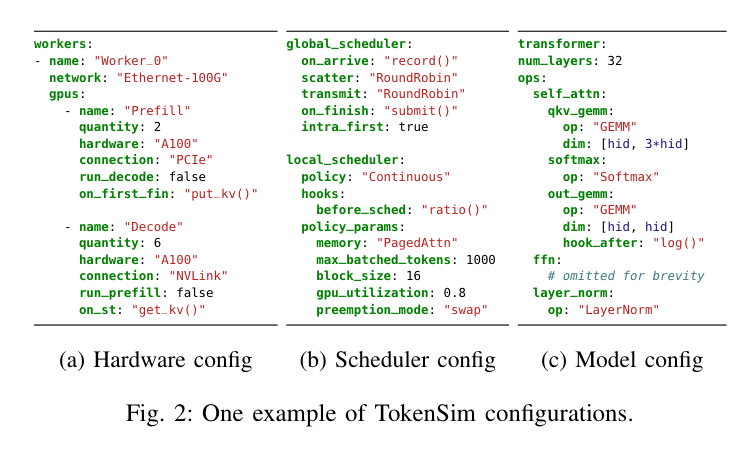
Paper's Figure 2(caption: "One example of TokenSim configurations.")。 配置文件是用户
表达 global/local scheduler、模型结构与 breakpoint 的地方——把调度策略当配置而非内核代码,
是这套模拟器"可扩展"的落点。
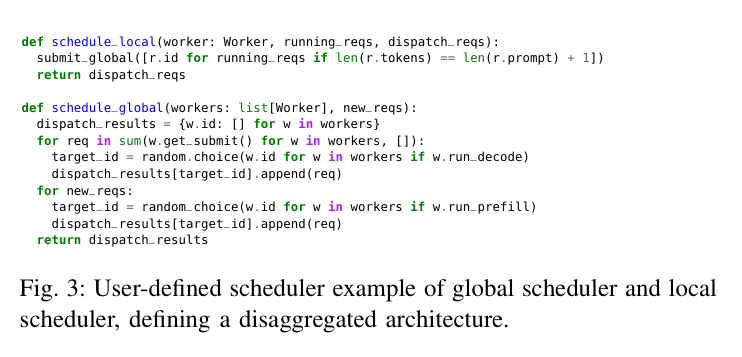
*Paper's Figure 3(caption: "User-defined scheduler example ... defining a disaggregated
architecture.")。* 展示 global + local scheduler 两个用户函数如何配合:global scheduler
可访问当前 worker 数、硬件类型、并发请求数,且可有状态(记录每 worker 已派请求数以做
load-aware 调度);local scheduler 访问当前任务队列与内存利用率。disaggregation 正是靠在
模型配置末尾挂 breakpoint、两行代码把请求在 prefill/decode worker 间转交实现的。
请求生命周期(framework 视角补充:sequenceDiagram) #
原文没有单独的时序图,这里用 Mermaid 补上调度决策与 KV 迁移的先后关系(结构信息,
raster 图未覆盖):
Scheduler 作为一等公民:queueing discipline 由用户函数决定(可实现 FCFS / load-aware
/ SLO-aware),batching 决策发生在每次 iteration 之间(continuous batching 语义)。
内存管理器与调度器分离:分配单元可为 block / token / byte,KV cache 传输走独立的
communication model。跨节点通信:由 memory bandwidth 参数化,支持顺序与并发(预加载
buffer)两种 overlap 模式。
4. 作者证明 #
无形式化作者证明 — 仅实证。
这是一篇模拟器系统论文,没有吞吐/延迟闭式模型,也没有 notation table、单调性或凸性证明。
其"正确性"完全由实测对齐支撑:对 vLLM、Vidur、LLMServingSim、DistServe 的误差实验。
框架论文常见的 performance model(λ, μ, B, T_M, N_p 等)在此缺席。
一个形式化模型若存在,本可澄清的几处(记为"模型本应回答但论文未回答"):
- §V 的 $2\times 312$ 算力阈值——decode 能力上限的来源无推导、无单位、无硬件语境;一个
- §IV-E memory cache 在 $\leq 32$ token 输出下收益递减、~64 token 达峰的阈值机制未给模型;
- §IV-C1 "prefill/decode 最优比主要取决于 output length"——若有排队论/吞吐模型,可判定
- 离散事件引擎:SimPy 4.1.1(ref [21])——active component(worker/device)注册进
- compute backend 插槽:GenZ(ref [10])作为默认 iteration-time 后端,接口设计为可换
- breakpoint 机制(关键实现细节 1):在模型配置文件末尾追加算子级 hook;默认
- 通信模型(关键实现细节 2):输入 = cache 位置(host/device) + 数据大小 + 带宽,输出 =
- 内存管理粒度:block / token / byte 三种可选,跨节点内存组成统一内存池(§III-B)。
- serving stage:编排/仿真层——不真正跑 kernel,而是给 prefill-only / decode-only /
- hardware affinity:结论层面,decode 亲和高带宽/高容量(PIM 如 G6-Aim 划算),prefill
- ecosystem integration:不是插进 vLLM/SGLang 的执行器,而是独立模拟器,以 GenZ 类
- migration path:跑 vLLM 的团队采用它不是替换 runtime,而是把它当**离线 what-if 探索
roofline 式模型(compute vs. HBM BW 的 min 关系)本可给出这个拐点的物理意义(312 恰为
A100 fp16 TFLOPS,疑似 2 张 prefill 卡的累计算力,但论文未点明)。
一个"检索 800ns/block 固定开销 vs. 重算节省"的收支模型本可解释 32 这个转折点。
最优是内点还是边界解,以及 input length 的二阶作用为何被降级为"primarily"的次要项。
首序核对(first-order sanity,非拟合):论文自报的 disaggregation 案例数字可被内部一致性
粗核——预算 5 张 A100 时,1×A100(prefill) + 7×G6-Aim(decode) 吞吐 $29.1$ vs.
2×A100(prefill)+... 的 $24.7$,与 Finding 4"预算受限时 PIM 划算、但受 slot 数限制不能全替
A100"一致;8 设备的 slot 上限(PCIe 槽位)是这些结论的硬约束,可自洽核验。
六项最低核对以"无形式化作者证明"替代——本条已列出模型缺席下的 3 处论证空缺 + 1 处首序核对。
5. 实验与数据 #
5.1 精度验证(对真实 vLLM) #
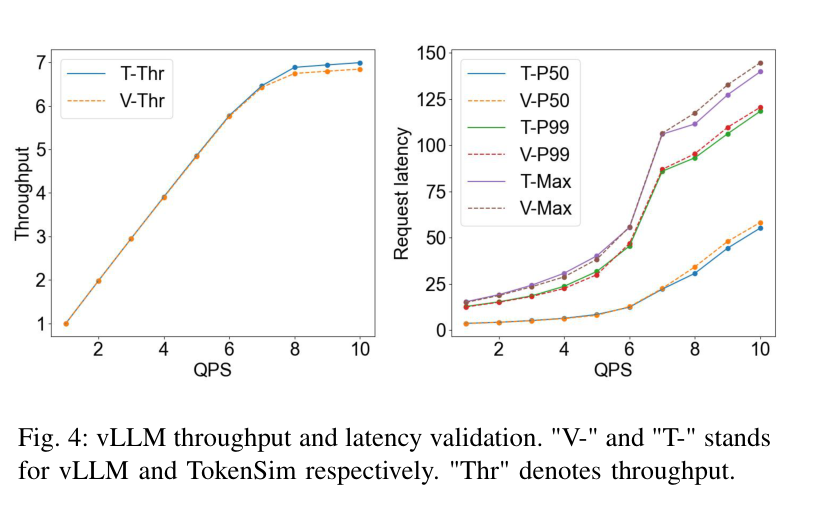
Paper's Figure 4("V-"=vLLM,"T-"=TokenSim,"Thr"=throughput)。 在多档 QPS 下 TokenSim
的吞吐/延迟曲线贴合 vLLM 实测。几何平均误差:throughput $0.109\%$;P50/P99/max 延迟
$0.6\%$/$0.254\%$/$0.337\%$。注意 throughput 匹配显著优于 P50 延迟匹配——尾部行为更难拟合。
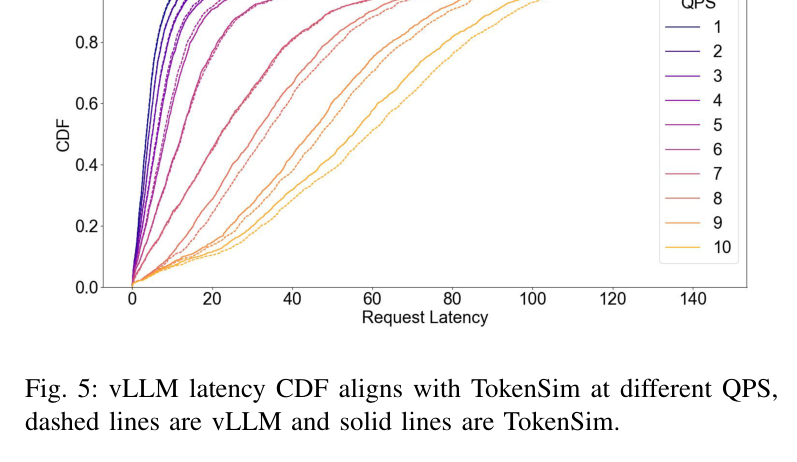
Paper's Figure 5。 不同 QPS 下 CDF 曲线几乎重合,支撑 <1% 的整体精度声明。这是"动态负载
下延迟分布"这一被旧模拟器忽视指标的直接证据。
5.2 对 SOTA 模拟器(精度 + 运行时) #
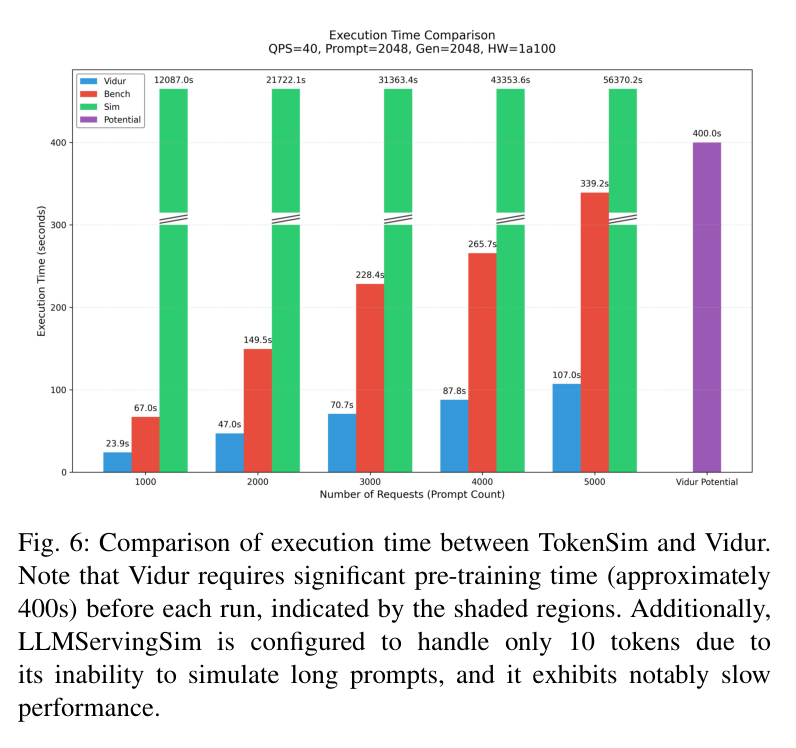
Paper's Figure 6。 Vidur 每次运行前需 ~400s 预训练(阴影区);LLMServingSim 仅能处理
10 token 且慢于实时。TokenSim 单次运行虽略长于 Vidur 的已训练运行,但省掉预训练——在
需要反复调参、随机化失效的配置验证阶段,总期望时间占优。
TABLE II — 各模拟器相对真实硬件的延迟差(请求数 100–500):
| Request num | 100 | 200 | 300 | 400 | 500 |
|---|---|---|---|---|---|
| Local (real) | 2.756 | 5.246 | 7.819 | 10.371 | 12.981 |
| Vidur | 2.371 | 4.698 | 7.246 | 9.935 | 12.122 |
| TokenSim | 2.592 | 5.089 | 7.587 | 10.095 | 12.593 |
| LLMServingSim | 2.556 | 5.056 | 7.557 | 10.056 | 12.556 |
论文归因于其 block 粒度内存仿真——避免了 MLP 仿真的粗粒度近似。⚠️ 但 TokenSim 每档都
比 Vidur 更远离 Local 真值(2.592 vs 2.371 …),"更高精度"的表述与本表数值方向相反;且
数值量级(2~13)与 §III-C 的 <1% 无法调和,疑为总耗时(秒)误标为百分比。
5.3 首个 disaggregated PD 模拟验证 #
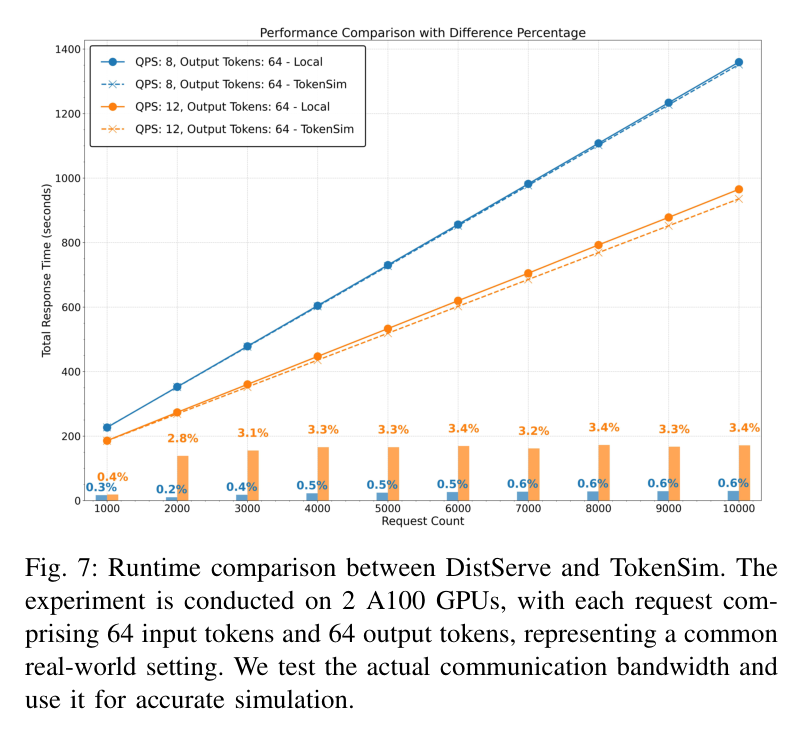
Paper's Figure 7。 对标 DistServe,实测 GPU 间带宽后用于配置 TokenSim,请求 1000–10000,
QPS=8。误差来源:KV cache 总线传输在大请求量下的波动累积;DistServe 底层 SwiftTransformer
runtime 未被建模(低请求量时该误差更明显)。
5.4 六大系统优化案例(load-bearing figures) #
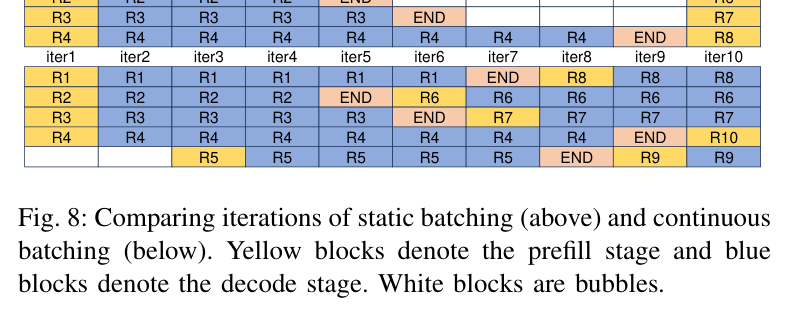
Paper's Figure 8(黄=prefill,蓝=decode,白=bubble)。 静态 batching 中短请求必须等长请求
完成 → 系统气泡;continuous batching 在批处理途中插入新请求填满气泡。这解释了为何必须
仿真 continuous batching 才能准确预测行为(Finding 1)。
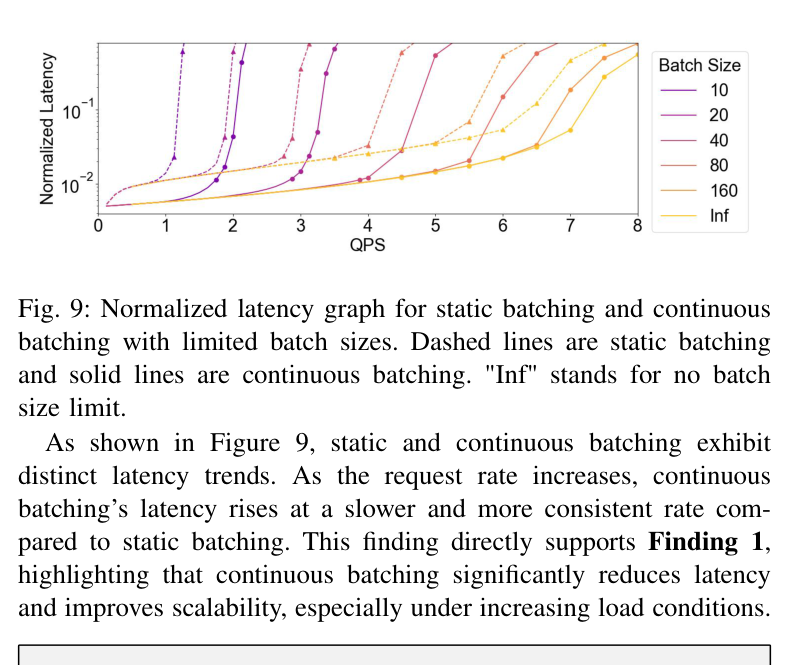
Paper's Figure 9(虚线=静态,实线=continuous,'Inf'=无 batch 上限)。 请求率上升时
continuous batching 延迟增速更慢更平稳,尤其高负载下——Finding 1 的量化证据。
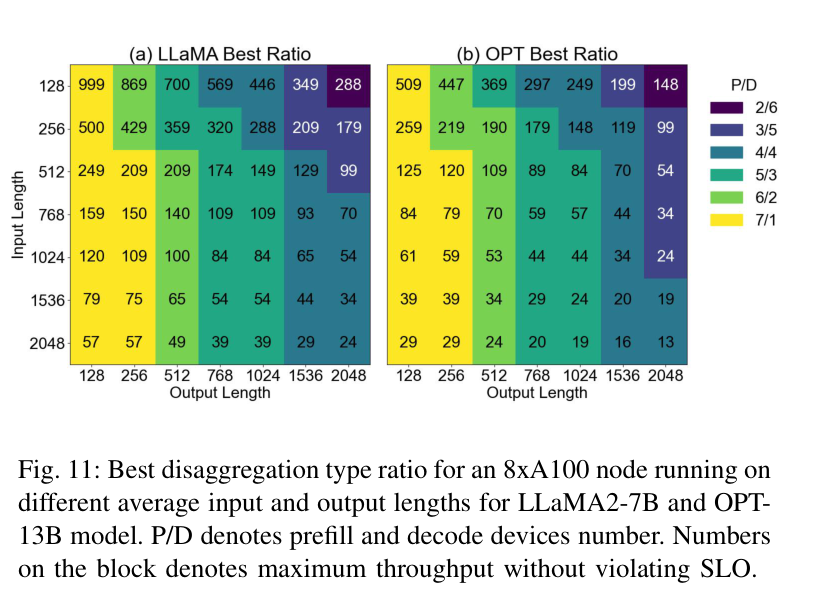
Paper's Figure 11(P/D=prefill/decode 设备数,块上数字=不违反 SLO 的最大吞吐)。 输出越长
越需要更多 prefill 节点;输出增长时较短输入允许更多 prefill 节点转作 decode——Finding 3:
最优 P/D 比主要由 output length 决定。
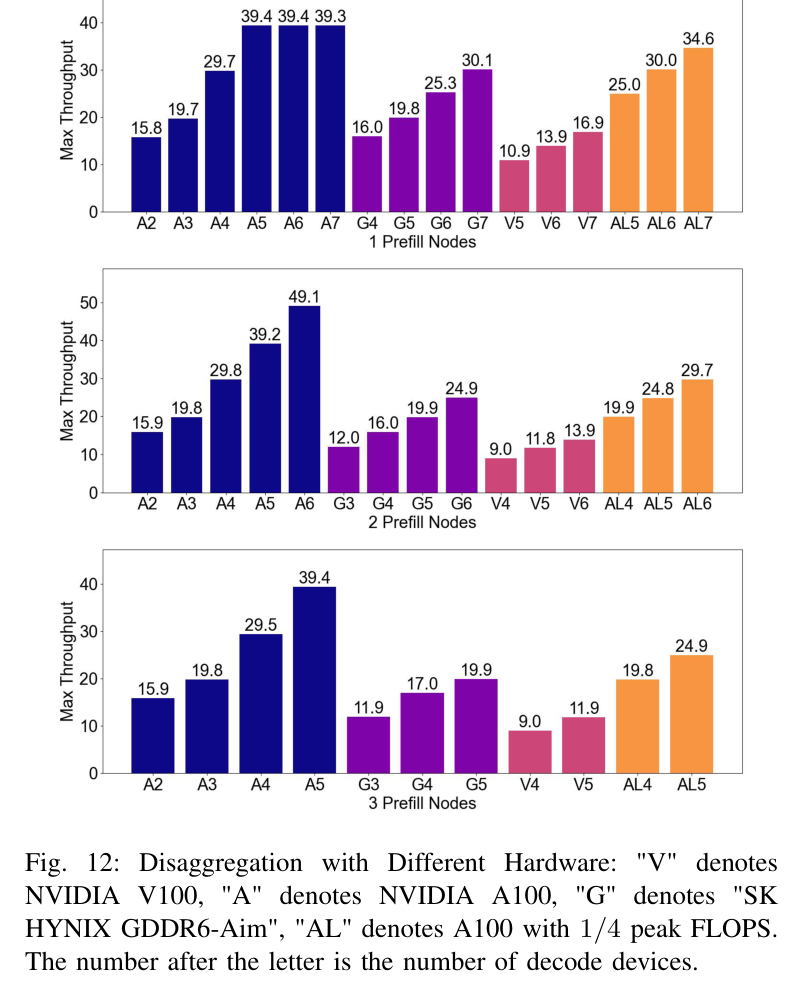
Paper's Figure 12(V=V100,A=A100,G=G6-Aim PIM,AL=1/4 算力 A100,字母后数字=decode 设备数)。
预算 5 张 A100 时,1×A100 + 7×G6-Aim 吞吐 $29.1$,省近一张 A100 成本却接近同吞吐;用 2 张
A100 作 prefill 反而降到 $24.7$——Finding 4:预算受限时 PIM 是划算的 decode 替代,但受
节点 slot 数限制不能全替 A100。
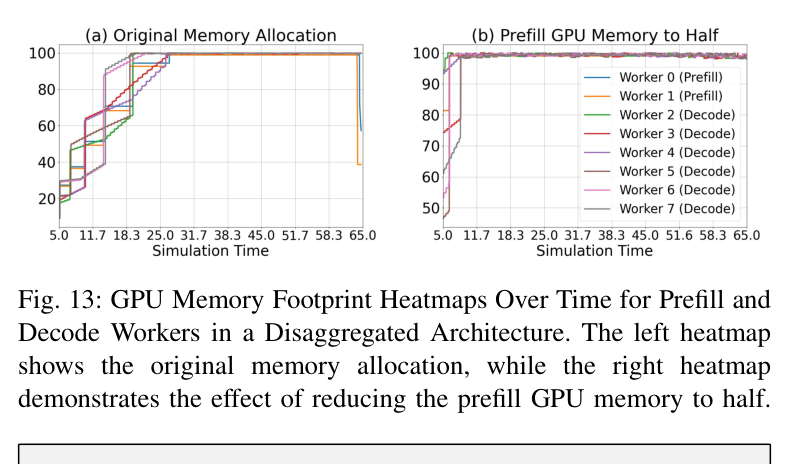
Paper's Figure 13。 prefill 阶段持续内存占用显著低于 decode(decode 需持续持有 KV cache 做
自回归)。把 prefill GPU 内存减半后吞吐几乎不变——Finding 5:prefill 内存分配可下调。
Paper's Figure 15(Ori=原 A100,T=算力,C=容量,B=带宽;C2 倍容量,-C2 半容量)。 容量
$\frac{1}{4}$–$4\times$、带宽 $\frac{1}{8}$–$4\times$ 对 prefill 吞吐几乎无影响;算力显著影响,
但累计算力达 $2\times312$ 后触及 decode 能力上限不再提升——Finding 7:disaggregated 下
prefill 更吃算力而非容量/带宽,说明 A100 的容量与带宽对 prefill 是过剩的。
Fig 10(限制 GPU 内存利用率 → mTPOT/TTFT SLO 下吞吐,Finding 2)与 Fig 14(multi-turn memory cache 的 P99 延迟,Finding 6)见 §6 论证链,未内嵌以控制篇幅。
Workload characterization — 赢在哪、输在哪(framework 必填) #
| Workload regime | TokenSim 揭示的赢家 | 对照 | 为什么 |
|---|---|---|---|
| 短提示、低并发 | continuous≈static 差距小 | static batching | 气泡少,动态调度收益有限(Fig 9 低 QPS 段) |
| 长提示、高并发 | continuous batching | static batching | 气泡多、尾延迟被动态填充压平(Finding 1) |
| 内存紧张 + SLO | 限制 max mem ratio | 最大化 batch | 预留内存减少抢占,改善尾延迟(Finding 2)——最大化 batch 反而输 |
| 长输出 disaggregation | 多 prefill 节点 | 固定 P/D 比 | 输出越长 decode 越吃紧,需更多 prefill 转 decode(Finding 3) |
| 预算受限 decode | PIM(G6-Aim) | 全 A100 | 半价近似吞吐,但受 slot 数限制(Finding 4);预算充裕时 A100 反超 |
| 多轮短输出 | memory cache | 无缓存 | ~64 token 输出处等效翻倍请求率;≤32 token 收益递减(Finding 6) |
6. 论证链(paper-internal,≥3 步) #
| # | 主张 | 论文内依据 | 推进到 |
|---|---|---|---|
| 1 | 旧模拟器对动态负载失真 | 单请求/单 batch 输入,无 continuous batching(§I, §II-C);Fig 8 展示静态 batching 的气泡 | 需要一个支持动态请求流 + 算子级可编程调度的模拟器 |
| 2 | 离散事件 + 两级调度 + 细粒度内存 = 可覆盖三类优化 | SimPy 引擎(§III);breakpoint 两行代码表达 disaggregation(§III-A);block/token/byte 内存管理(§III-B) | 得到一个模块可替换、策略可配置的架构(Fig 1) |
| 3 | 该架构精度足够可信 | vLLM 误差 <1%(§III-C, Fig 4/5);对 Vidur/LLMServingSim 更省预训练(§III-D, Fig 6);首验 DistServe 分离(Fig 7) | 可用它做"若无真机则难做"的优化探索 |
| 4 | continuous batching 在高负载下降延迟 | Fig 9 归一化延迟增速更平(§IV-A) | Finding 1;进而问内存限制如何交互 |
| 5 | 最大化 batch 非普适最优 | 抢占伤尾延迟;限制 max mem ratio 在 mTPOT/TTFT SLO 下提升吞吐(Fig 10, §IV-B) | Finding 2;进而问分离架构的设备配比 |
| 6 | 最优 P/D 比由 output length 主导 | Fig 11 在 8×A100 上扫描 input/output 长度(§IV-C1) | Finding 3;进而问 decode 能否换更便宜硬件 |
| 7 | PIM 是预算受限下的 decode 替代 | Fig 12:1A+7G6-Aim=29.1 优于 2A 方案 24.7,受 slot 限制(§IV-C2) | Finding 4;进而看两阶段内存足迹 |
| 8 | prefill 内存足迹低、可下调 | Fig 13 热力图;减半后吞吐几乎不变(§IV-D) | Finding 5;进而看 multi-turn 缓存 |
| 9 | memory cache 对短输出多轮最有效 | Fig 14:~64 token 等效翻倍请求率,≤32 token 递减(§IV-E) | Finding 6;进而做 prefill 硬件参数敏感性 |
| 10 | prefill 吃算力不吃容量/带宽 | Fig 15:容量/带宽大范围变化无影响,算力主导且有 $2\times312$ 上限(§V) | Finding 7;总结 A100 容量/带宽对 prefill 过剩 |
7. 实现 cross-reference #
代码公开:https://github.com/pku-lemonade/TokenSim(论文 §0 Para 2)。L1 未抓取具体
file:line,故以下为架构级指引而非行号引用;需精确定位时应回到该 repo 核对。
environment,仿真时间由事件推进;可在无 GPU 的个人电脑上跑。
(§III Para 3 "supports diverse compute simulators")。[实现未公开具体接口签名]
breakpoint 在每 token 生成后触发调度器。disaggregation 只需两条 hook:local scheduler
把带新 token 的请求交回 global scheduler、global scheduler 派往 decode 设备(§III-A
Para 3–4)。这是"两行代码实现分离"这一卖点的落地点,易被忽略。
传输时间;靠 SimPy 事件驱动支持 sequential 与 concurrent(预加载 buffer)两种 overlap,
调大 buffer 可逼近 ideal multi-preloading(§III-B Para 4–5)。多轮缓存实验中检索时延取
固定 800 ns/block(ref [18],§IV-E),无敏感性分析——移植时需自行参数化。
核心技术壁垒(§7 专段):最难复刻的不是任一模块,而是让"调度策略"以**算子级
breakpoint + 两级 scheduler**的形式与"硬件时间模型(compute backend)"完全解耦的抽象层。
正因调度是用户函数而非内核逻辑,同一引擎才能在不改内核的前提下表达 continuous batching、
prefill/decode 分离、以及 multi-round memory pool 三类结构迥异的优化;复刻者即便照抄
SimPy loop,也要重新发明这套"配置即策略、breakpoint 即迁移点"的接口契约,才能达到相同的
可扩展性与 <1% 的对齐精度。
8. Deployment context(实践上下文) #
both / 分离编排各档配置估性能;对低到高并发均可(案例用到 50,000 并发请求采样)。
亲和高算力(容量/带宽过剩);工具本身无 GPU 亦可运行(SimPy 纯 CPU)。
compute backend 为可换插槽;把真实系统(vLLM v0.6.2 / DistServe)当对照真值来校准。
器**——改配置文件里的 scheduler/内存策略/硬件参数,无需真机即可预演分离比、PIM 替代、
prefill 内存下调等决策;成本是重写 compute backend 适配自家硬件的算子时间模型。
§12 软→硬反向启示:TokenSim 是纯软件模拟框架(不做 megakernel / cache-scope 控制 / chiplet 亲和),不触发硬件反向启示条款。其结论对硬件的间接暗示(decode 适配 PIM、 prefill 算力主导)属于被模拟系统的性质,而非模拟器自身的硬件诉求。