A Data-driven ML Approach for Maximizing Performance in LLM-Adapter Serving
A Data-driven ML Approach for Maximizing Performance in LLM-Adapter Serving — L2 #
1. TL;DR #
单 GPU 上服务成百上千个 LoRA adapter 时,"并发 adapter 数 $N$ + vLLM 静态 slot 数 $G$" 存在一个吞吐最优点。本文用离线 Digital Twin(吞吐误差 ≤5.1%、90× 加速)批量造 87198 条样本,训出可解释树模型,在真实系统上预测 $N$ 误差 ≤1.0%、$G$ 误差 ≤7.2%,推理 ≤0.15 ms。
2. Q1 / Q2 / Q3 #
Q1 — 痛点:adapter 数量是一个双向都会亏的旋钮 #
系统边界先钉死:单节点单 GPU(H100 64GB)、vLLM 在线服务(continuous batching + chunked prefill + FCFS)、纯 decode/prefill 混合的推理侧、无 TP/PP/EP/DP 任何并行轴(论文 §5 明确把 multi-device 列为未来工作)。框架自己拥有的只有两个配置量:
- concurrent adapters $N$:被服务的 adapter 总数,可以超过显存容量,靠 CPU↔GPU 换入换出(LRU)支撑;
- parallel adapters / adapter slots $G$:vLLM 在 server 启动时静态指定的、同时驻留 GPU 的 adapter 上限。
痛点有两层。第一层是 $N$ 太大会饥饿:请求聚合本来能提高吞吐,但一旦 adapter 权重 + 请求 KV 超出显存,系统来不及消化到达速率,吞吐从"随 $N$ 线性上升"翻转成"增速放缓甚至下降"。第二层反直觉:即使显存装得下,把 $G$ 调小反而可能更快——adapter 权重挤占的是 KV cache 空间,少装几个 adapter 换来更大 batch。反过来 $G$ 太小又让驻留 adapter 吃不满显存。所以最优点在两个方向上都不是端点。
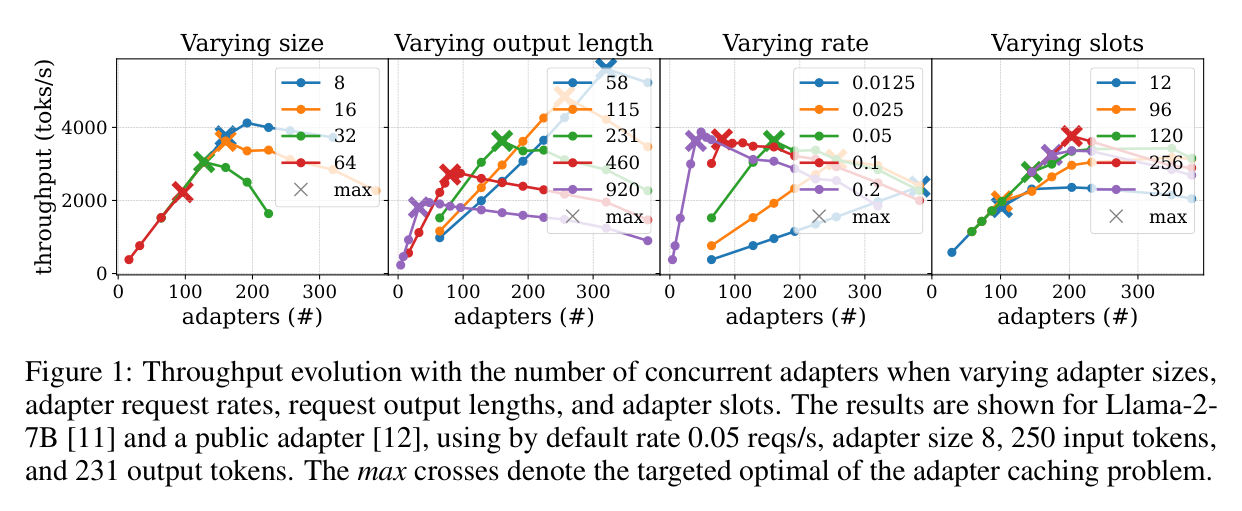
Paper's Figure 1, verbatim(caption: "Throughput evolution with the number of concurrent adapters when varying adapter sizes, adapter request rates, request output lengths, and adapter slots... The max crosses denote the targeted optimal of the adapter caching problem.")
四条曲线族都是"先涨后平/后跌",叉号是目标最优点。读者要注意的是拐点位置在四个面板里横跳:改 rank、改输出长度、改到达率、改 slot 数,最优 $N$ 从几十到三百多都有。这就是为什么作者不写启发式而去拟合一个模型——拐点是 (size, rate, length) 的联合函数,且最右面板证明 $G$ 本身也是一条独立的调优轴。
问题被正式命名为 adapter caching problem:给定异构的 adapter size / rate / 请求长度,求使单 GPU 吞吐最大且不触发饥饿的 $(N, G)$ 联合配置。"不饥饿"的操作化定义是一个硬阈值:吞吐必须 > 0.9 × 总入流 token rate,在满足该约束的点里取吞吐最大者。这一条 90% 门限定义了全文所有 ground truth 标签。
Q2 — 方法:用 Digital Twin 造数据,用可解释模型做决策 #
两个组件拼成"data-driven ML approach":
(a) 推理侧 ML 模型。输入不是完整 workload trace,而是把 adapter 的两类属性各压成 4 个序统计量:$\min/\max/\mathrm{mean}/\mathrm{std}$ of size 与 $\min/\max/\mathrm{mean}/\mathrm{std}$ of rate,共 8 维特征。请求长度不进特征——它被固定为 clean ShareGPT 的异构分布。输出是两个独立单输出回归器(一个预测 $N$,一个预测 $G$),而不是联合二输出模型。模型族刻意选轻量可解释的六种:LinearRegression / BayesianRidge / PLSRegression / RFRegressor / RuleFitRegressor / FIGSRegressor。
(b) Digital Twin (DT)。ground truth 需要对每个 workload 组合扫 $N \times G$ 网格,真机 benchmark 代价不可承受,于是造一个离线 emulator:不做 GPU 仿真,而是复刻 vLLM 的 continuous-batching 主循环,用 4+1 个拟合的 latency/memory estimator 推进模拟时钟。DT 只要 adapter rate、size、slot 数,以及输入/输出长度的均值与标准差(不需要完整长度分布)就能跑。
核心技术壁垒:真正难复制的不是 ML 模型(8 维特征 + 随机森林是标准工序),而是 DT 的 latency 分解粒度恰好选在了"能拟合、又能撑住排序"的那一层——尤其是 scheduler latency 项 $K_1 R_{running} + K_2 R_{waiting} + K_3 R_{waiting}(G/N)$。把 scheduler 时间当成一等公民建模,并且用 $R_{waiting} \cdot (G/N)$ 这个交互项去编码"等待队列里有多少请求的 adapter 当前不在 GPU 上",是全文最不可直接迁移的一手经验:它由 vLLM 具体调度实现的形状决定,作者自己承认"currently limited to vLLM"。第二重壁垒是 adapter 开销项的建模选择——用并行 adapter 数 $A_{running}$ 而不是 rank 之和/最大值,这与 CaraServe 的公开模型直接冲突,是靠 Appendix A.2 的实测把前人公式否掉后换上的。
Q3 — 结果 #
- DT 保真度:吞吐 SMAPE 4.2%(Llama)/ 5.1%(Qwen),ITL 9.1–9.6%,TTFT 17.4–17.9%。
- DT 成本:模拟 1 小时服务耗时 39.5 s / 41.4 s(≈90× 实时加速),无 GPU、≤1 CPU core、~200 MB RAM。
- 数据规模:87,198 条 DT 合成(train+val,99%)+ 882 条真机(test,1%)。
- ML 精度(对真机标签):树模型 $N$ 误差 0.05–1.01%,$G$ 误差 6.73–7.15%;线性模型 $N$ 误差 38.6–40.6%(≈40× 差距)。
- 可解释版:RFRegressor 压成单棵 depth-6 树,<30 条规则,Table 1/2 的
Tree**行;$N$ 上 Qwen 保持 1.01%,Llama 退化到 3.70%。 - 推理开销:树模型 ≤0.15 ms(两个输出求和)。
3. 架构 / 方法图 #
DT 的结构就是"vLLM 主循环的影子":三个组件(SCHEDULER / ADAPTER CACHE / MODEL)挂五个 estimator。
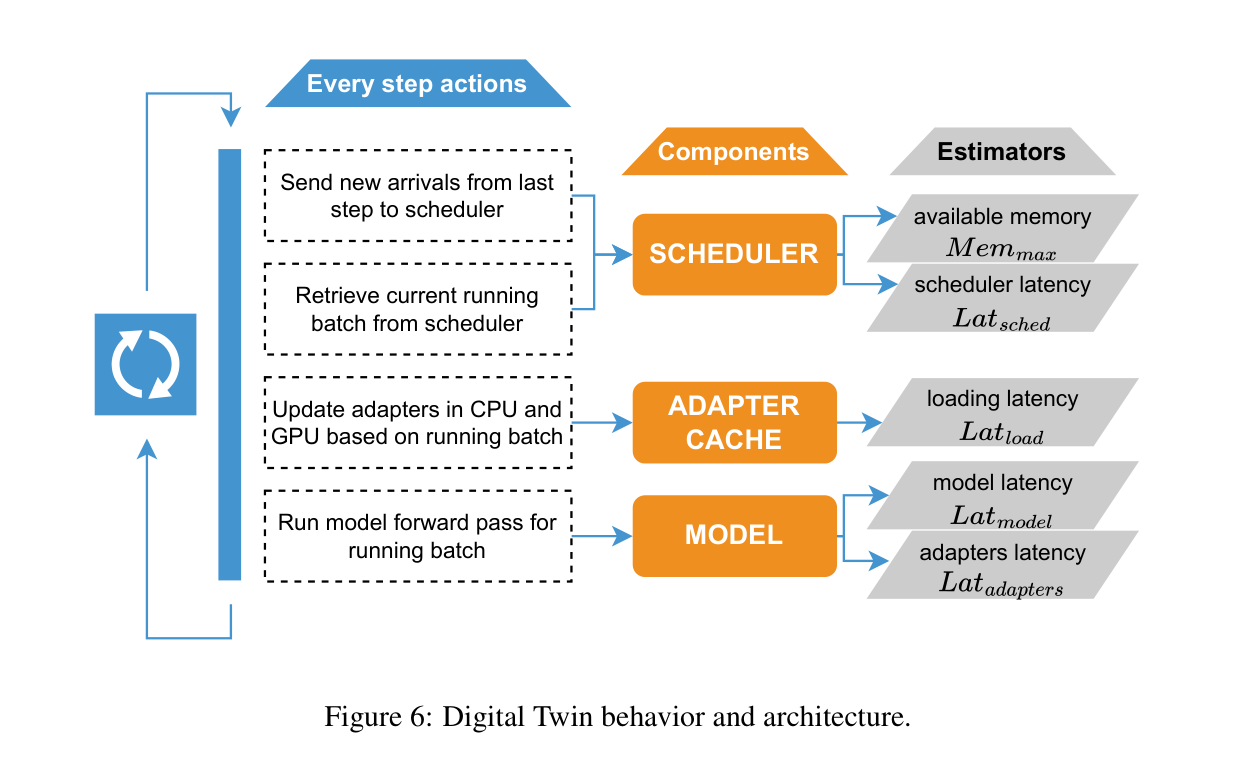
Paper's Figure 6, verbatim(caption: "Digital Twin behavior and architecture.")
图里最该看的是右侧 Estimators 那五项——scheduler latency、available memory、loading latency、model latency、adapters latency——它们是 DT 里唯一的"物理",其余全是状态机。注意 KV/内存管理被拆成独立的 $Mem_{max}$ estimator,与 scheduler 分离:$Mem_{max}$ 由 slot 数与 adapter size 决定可用于 KV 的显存,scheduler 再在这个预算内做 greedy 分配,这正好对应 §2 里"adapter 权重挤占 KV"的因果链。
请求生命周期与调度/缓存的关系用序列图更清楚:
分配单元与策略在此钉死:调度粒度 = 请求(chunked prefill 下 prefill 按 token chunk 切),排队纪律 FCFS,KV 分配 greedy(vLLM paged block),adapter 缓存单元 = 一个 adapter 的全部权重,淘汰策略 LRU,换出目标 = CPU 内存(Appendix A.3 显示比 disk 快约 70%)。跨节点通信路径:不存在——全文单 GPU,无 collective、无 IB/NVLink 参与。
4. 作者证明 #
论文没有排队论或闭式吞吐模型;形式化内容只有 Equation 1 的四个拟合 latency 模型(外加 Appendix C.1 的第五个 $Mem_{max}$)。以下按框架类论文的要求逐项审。
4.1 记号表 #
| 符号 | 含义 | 出处 |
|---|---|---|
| $N$ | concurrent adapters,被服务的 adapter 总数(可超显存) | §1 para 4 |
| $G$ | adapter slots,vLLM 启动时静态设定的 GPU 常驻 adapter 上限 | §1 para 4 |
| $R_{running}$ | 当前 running batch 中的请求数 | §3 post-Eq.1 |
| $R_{waiting}$ | 等待队列中的请求数 | §3 post-Eq.1 |
| $A_{running}$ | 当前并行(GPU 常驻且参与本步)的 adapter 数 | §3 post-Eq.1 |
| $K_1 \ldots K_7$ | 由 SciPy curve_fit 非线性最小二乘标定的常数 | §3 post-Eq.1 |
| $Mem_{max}$ | 可用于 KV 的显存上界(由 $G$ 与 adapter size 决定) | Appendix C.1 |
| $TPOT$ | time per output token | Fig. 4 caption |
| $\overline{x},\ \widetilde{x}$ | $x$ 的均值 / 标准差(Fig. 8 规则记号) | Fig. 8 caption |
4.2 方程与物理意义 #
$$Lat_{model} = K_{4} R_{running} + K_{5}$$
backbone forward 对 batch size 仿射:$K_5$ 是与 batch 无关的固定开销(kernel launch、layer 遍历),$K_4$ 是每请求边际成本。为什么不含 sequence length?因为 chunked prefill 把每步的 token 预算钉住了,步内 token 数近似常数,长度效应被吸收进 $K$ 与步数中。该形式直接沿用 SHEPHERD / Nexus 的线性假设。
$$Lat_{adapters} = K_{6} A_{running} + K_{7}$$
关键在 $K_7$ 而不是 $K_6$:Appendix A.2 说 0→1 个 adapter 的跌幅最大,因为引入了一个无法跨请求并行的串行计算步;这个"一次性代价"正是截距 $K_7$。此后每多一个并行 adapter 只加 $K_6$,是次比例增长。自变量选 $A_{running}$ 而非 rank,是对 CaraServe 的公开反驳。
$$Lat_{sched} = K_{1} R_{running} + K_{2} R_{waiting} + K_{3} R_{waiting} (G/N)$$
前两项是"扫一遍 running / waiting 两个队列"的线性成本。第三项 $R_{waiting}(G/N)$ 里,$G/N \in (0, 1]$ 是"被服务 adapter 中能同时驻留的比例",乘上等待队列长度 ≈ 每步 scheduler 需要为其检查 adapter 驻留状态、并可能触发 swap 判定的请求量。为什么是乘不是加:只有当既有排队请求、又有 adapter 命中/换入的可能性时才产生这项开销,二者缺一为零,乘法编码的是合取。为什么是 $G/N$ 不是 $G$:绝对 slot 数不决定命中率,占比才决定。
$$Lat_{load} = \text{benchmark 查表(adapter size × storage tier)}$$
不拟合函数形式,因为加载时间对 size 是分段离散的,且 disk/CPU 是两个截然不同的常数带(disk 平均慢 70%)。
4.3 单调性 / 凸性 —— 最优点为何是内点 #
论文没有显式讨论,但可以从模型形状推出。固定 $N$ 增大 $G$:$Mem_{max}$ 单调下降(adapter 权重挤占 KV)→ 可容纳的 $R_{running}$ 上界下降 → 吞吐下降;同时 $A_{running}$ 上升让 $Lat_{adapters}$ 上升;但 $G$ 太小会让 $Lat_{load}$ 频繁触发(LRU 抖动)且 $R_{waiting}(G/N)$ 项虽小、可用 adapter 不足反而使 batch 填不满。两个方向都单调恶化 ⇒ 最优 $G$ 是内点,与 Fig. 1 最右面板一致。对 $N$:吞吐随 $N$ 上升直到入流速率超过 $Mem_{max}$ 支撑的服务率,之后进入饥饿。此处是 90% 门限而不是模型本身切出了最优点——若无该约束,argmax 会滑到平台区右端。这是全文最脆的一处:论文未做该阈值的敏感性分析。
4.4 六项最低核查 #
- 单位一致性:Eq.1 四式左端均为时间;$R_\cdot$、$A_\cdot$、$G/N$ 为无量纲计数/比值,故 $K_1,K_2,K_3,K_4,K_6$ 单位为 s/req 或 s/adapter,$K_5,K_7$ 为 s。自洽。唯一不一致在 Table 1:表头
Mem (%)但值为 210/211,正文称 "~200MB RAM" —— 表头单位错误,应为 MB。 - 极限行为:$A_{running} \to 0$ 时 $Lat_{adapters} \to K_7 \neq 0$,即"没有 adapter 也有 adapter 开销",物理上应为 0。该式只在 $A_{running} \geq 1$ 的域内有效,论文未声明定义域。$N \to \infty$ 时 $G/N \to 0$,scheduler 交互项消失——含义是"命中率趋零、不再有换入判定",方向合理但极限值可疑(换入应更频繁而非更少)。这是模型在极端 over-subscription 下的已知薄弱处。
- 数量级复算(90× 加速):模拟 1 小时 = 3600 s,Llama 用时 39.5 s → 3600/39.5 = 91.1×;Qwen 41.4 s → 87.0×。论文写 "up to 90×",与 Llama 行吻合,取的是较优者。✅
- 数量级复算(数据集划分):87,198/(87,198+882) = 98.999%,与"99% / 1%"一致;总计 88,080 次 run。反推网格:rate 从 10 值中取三(可重复则 220 种组合),size 从 [8,16,32] 取三(可重复 10 种),220×10 = 2200 个 workload mix,88,080/2200 = 40.04 个 $(N,G)$ 网格点/mix——落在整数 40 上,与"8–384 扫描"若取 8 个 $N$ × 5 个 $G$ 相符。论文未给网格步长,此为一阶反推,量级自洽。✅
- 内部一致性(表 ↔ 文):正文"maximum average error of 1.0% for concurrent adapters"对应 Table 2 Qwen RFRegressor 1.01;"maximum of 7.2% for slots"对应 Qwen RFRegressor 7.15(四舍五入 7.2)。Table 1 的
Tree行 (0.1/6.7, 1.0/7.2) 即 Table 2 的 RFRegressor 行。✅ 但正文称压缩树"maintains competitive performance",而 Table 2 显示 Llama $N$ 由 0.05 → 3.70(74×)、$G$ 由 6.73 → 10.86,"competitive"是宽松措辞。 - 反例 / 内部矛盾:Fig. 8 规则 7 与 8 相对 $\overline{rate}$ 非单调——高方差分支下 $\overline{rate} \leq 1.16 \to 16$ slots,而 $\overline{rate} > 1.16 \to 32$ slots,方向与规则 4–6(rate 升则 slot 降)相反。论文未解释。这既可能是真实物理(极高速率下少数 adapter 独占,需更多 slot 避免抖动),也可能是深度受限树的过拟合残差。
- DT 只需要输入/输出长度的均值和标准差,不需要完整长度分布(Appendix C para 2)。这是 DT 能被 87,198 次批量调用的前提——如果要求完整 trace,扫参空间会立刻爆炸。复刻时若误以为需要喂真实 trace,会把整个数据生成管线的成本量级搞错。
- 两个输出是两个独立的单输出回归器,不是一个二输出模型(§3 para 1),且请求长度不是特征(被 ShareGPT 分布固定)。这意味着模型不能外推到别的长度分布,也不保证 $(N^, G^)$ 两个预测彼此自洽(可能预测出 $G > N$ 这类组合)。论文未讨论这种不一致的处理方式。
- 附带一条工程性的:$Mem_{max}$ estimator 不在 Equation 1 里(Appendix C.1 明确说"not included in the main text")。只照着正文那四个式子实现,DT 会缺掉显存预算这一环,行为完全不对。
4.5 一阶映射:把 case study 代回模型 #
论文没有给出可代入的闭式吞吐式,因此无法像典型 framework 论文那样"把 Table N 的 workload 代进 Eq. N 复现 54%"。可做的一阶核查是误差传播:DT 吞吐本身有 4.2–5.1% 误差,而用它生成的 99% 训练数据训出的模型对真机标签只有 0.05–1.0% 误差。这不矛盾但需要解释——因为 ML 的目标是 argmax 的位置而非吞吐值本身,DT 只要保持 $(N,G)$ 网格上的序正确,幅值偏差就可被吸收。论文没有明写这一点,但它是整个"用有偏 simulator 训练无偏决策器"设计成立的唯一理由,也解释了为什么 $G$ 的误差(6.7–7.2%)系统性高于 $N$:Appendix E 指出 DT 的 ITL 精度随 slot 数增加而变差,序在 $G$ 轴上更容易被扰动。
若有模型会澄清什么:一个显式的 $\text{throughput}(N,G) = \min(\lambda_{in},\ \mu(Mem_{max}(G), B))$ 形式的饱和模型,可以把 90% 门限从一个魔数变成 $\lambda_{in}$ 与 $\mu$ 的交点,并直接给出最优点是否唯一。现状是纯经验搜索 + 回归拟合。
5. 实验与数据 #
5.1 设置与基线口径 #
| 项 | 值 |
|---|---|
| Backbone | Llama-3.1-8B-Instruct、Qwen2.5-7B-Instruct(Appendix A/B 另用 Llama-2-7B/13B) |
| Adapter | 两个 HuggingFace LoRA(finance/Llama、medical/Qwen),rank ∈ {8,16,32} |
| 硬件 | NVIDIA H100(论文写 "64GB HBM2",与常见 80GB HBM3 规格不符,照录不改)、128GB RAM、20 CPU cores |
| 框架 | vLLM(未给版本号/commit) |
| Workload | clean ShareGPT,保留异构 in/out 长度 |
| 指标 | 相似度一律用 SMAPE(越低越近);吞吐为 total tokens/s(未区分 in/out);latency 报 mean ITL / mean TTFT(非 p99) |
基线口径的两个缺口:(1) vLLM 版本与 commit 未披露,DT 的 scheduler 模型强绑定具体调度实现,这直接影响可复现性;(2) 与最接近的工作 dLoRA 没有做头对头对比,论文在 §5 主动承认并推给未来工作。因此"我们比启发式好"这句话在本文里没有实验支撑,只有"我们的预测贴近真机最优"这一自比结论。
5.2 DT 保真度:好在吞吐,差在 TTFT #
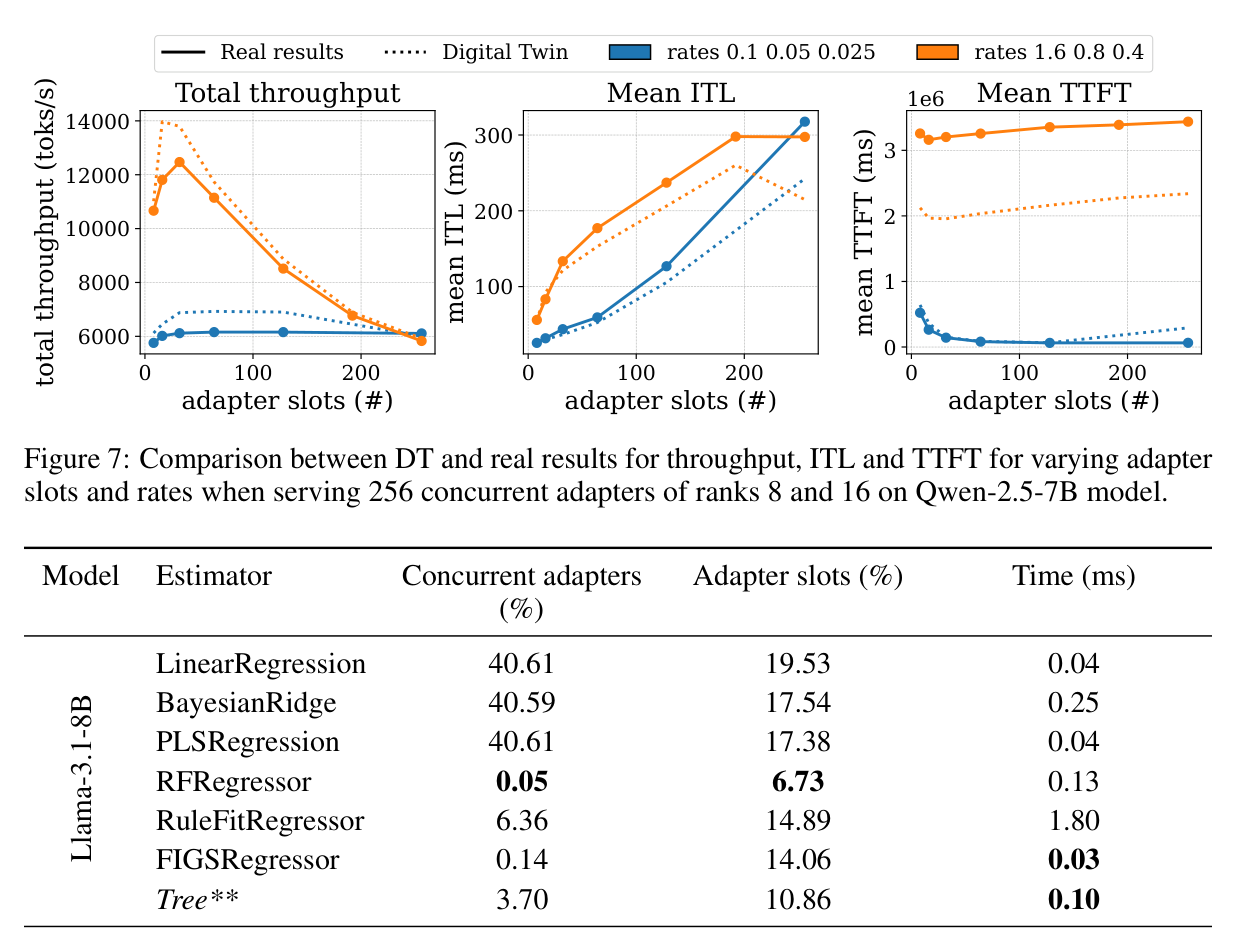
Paper's Figure 7, verbatim(caption: "Comparison between DT and real results for throughput, ITL and TTFT for varying adapter slots and rates when serving 256 concurrent adapters of ranks 8 and 16 on Qwen-2.5-7B model.")
三个面板的误差结构完全不同:吞吐两条线基本重合,ITL 随 slot 数增大而张开,TTFT(注意 y 轴 ×1e6 ms 量级)在高到达率下偏离最大。这是全文最该被记住的负面结果——DT 恰恰在高负载、多 slot 这个"最优点所在的区域附近"最不准。Limitations 段没有提这一条。
5.3 ML 精度:线性模型集体坍塌 #

Paper's Table 2, verbatim(caption: "Expanded results of the ML model for predicting the optimal joint configuration... All values represent the SMAPE difference from the benchmark maximum values, except time (reported in milliseconds), which corresponds to the summed inference time across the two output predictions.")
三种线性模型在 $N$ 上聚成 38.56–40.61 的窄带,跨两个 backbone、跨三种正则都几乎不动——这是退化为近似常数预测器的指纹(若真值在 8–384 上分布,常数预测的 SMAPE 恰在 40% 量级)。树模型 0.05–1.01% 说明 8 维序统计量到最优 $N$ 的映射是强非线性的、带阈值的。同时注意 RuleFitRegressor 推理 1.80/2.03 ms,比其余高一个数量级却不占精度优势——它在这张表里是纯输家。
5.4 机理证据:为什么 adapter 数会伤吞吐 #
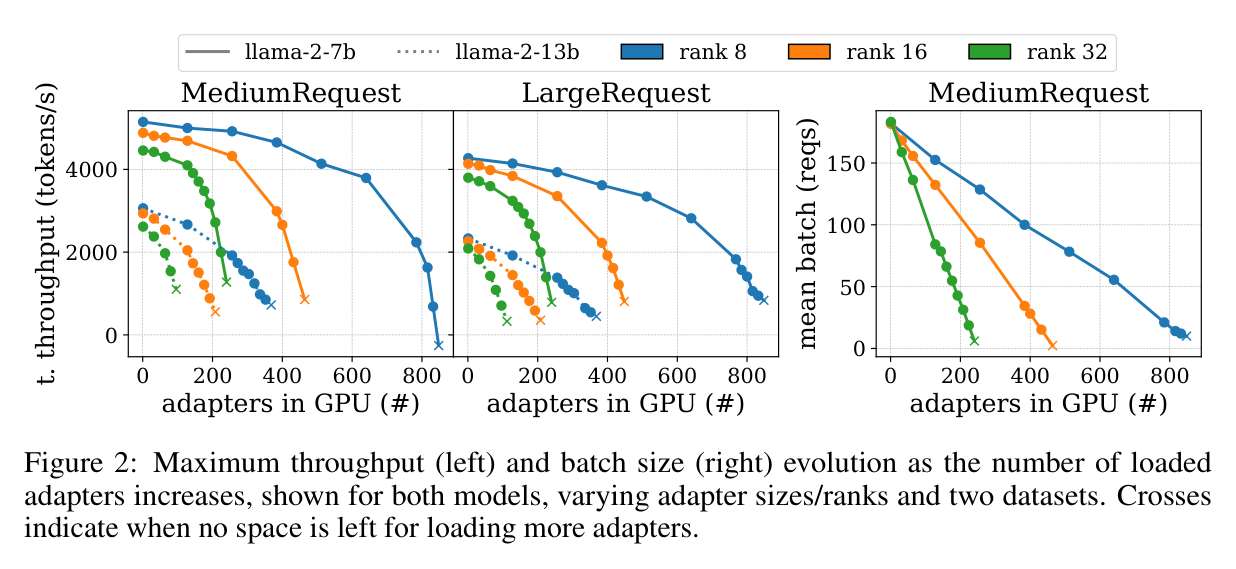
Paper's Figure 2, verbatim(caption: "Maximum throughput (left) and batch size (right) evolution as the number of loaded adapters increases... Crosses indicate when no space is left for loading more adapters.")
这是 $Mem_{max}$ estimator 的实证基础,也是最有信息量的一张:batch size 随常驻 adapter 数线性下降,而吞吐指数式下降。二者不同步的原因是 throughput plateau——大 batch 区间里 batch 换吞吐的边际收益已经很低(图中每条线的最左端),所以前期掉 batch 几乎不掉吞吐,越往右越陡。模型越大、rank 越大,转折来得越早。
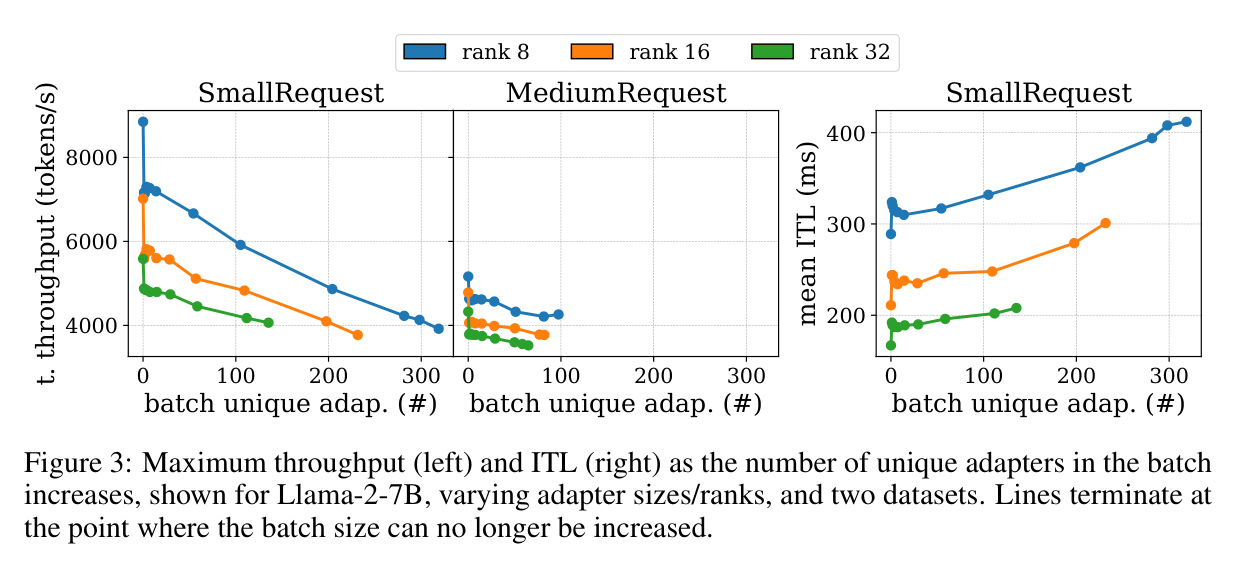
Paper's Figure 3, verbatim(caption: "Maximum throughput (left) and ITL (right) as the number of unique adapters in the batch increases... Lines terminate at the point where the batch size can no longer be increased.")
这是 $Lat_{adapters} = K_6 A_{running} + K_7$ 的实证基础。要看的是 0→1 那一跳的落差远大于之后任何一步,对应无法跨请求并行的那个串行计算段,也就是模型里的截距 $K_7$。此后曲线趋缓,证明用并行 adapter 数而非 rank 之和建模是合理的。
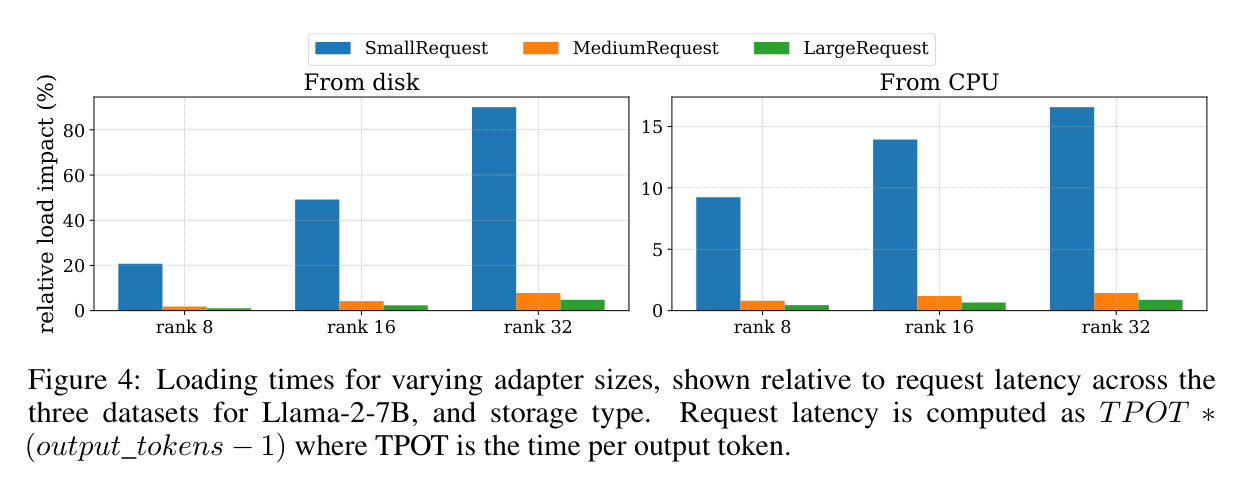
Paper's Figure 4, verbatim(caption: "Loading times for varying adapter sizes, shown relative to request latency across the three datasets for Llama-2-7B, and storage type.")
注意两个面板的 y 轴量级差 5 倍以上(disk 最高 80%,CPU 最高 ~15%)。这解释了为什么 $Lat_{load}$ 用查表而非公式,以及为什么把 adapter 预加载到 CPU 内存是廉价的一阶优化:对长请求,CPU 加载开销跌到 2% 以下。分母口径是 $TPOT \cdot (output\_tokens - 1)$,即纯 decode 段,不含 TTFT。
5.5 跨框架泛化与可解释产物 #
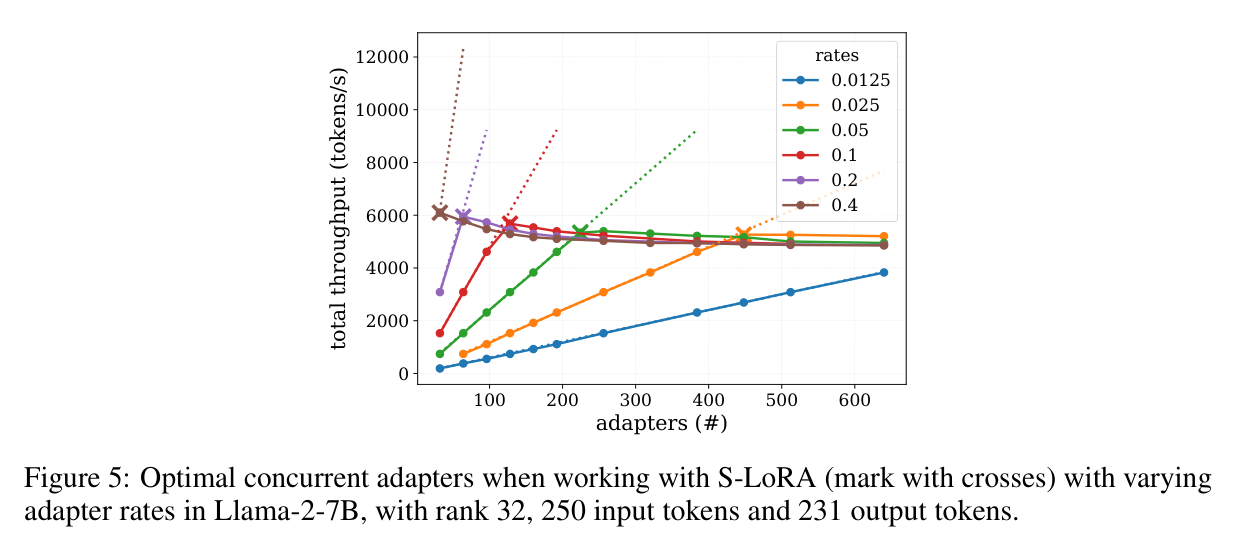
Paper's Figure 5, verbatim(caption: "Optimal concurrent adapters when working with S-LoRA (mark with crosses) with varying adapter rates in Llama-2-7B, with rank 32, 250 input tokens and 231 output tokens.")
换成 S-LoRA 后曲线形状仍然是"升—峰—落",叉号依旧存在,说明 adapter caching problem 不是 vLLM 的实现缺陷。但降幅只有 15–20%(vLLM 下要剧烈得多)——S-LoRA 的设计把这个问题削弱了但没有消除,这既支持了通用性主张,也削弱了"必须用本文方法"的紧迫性。
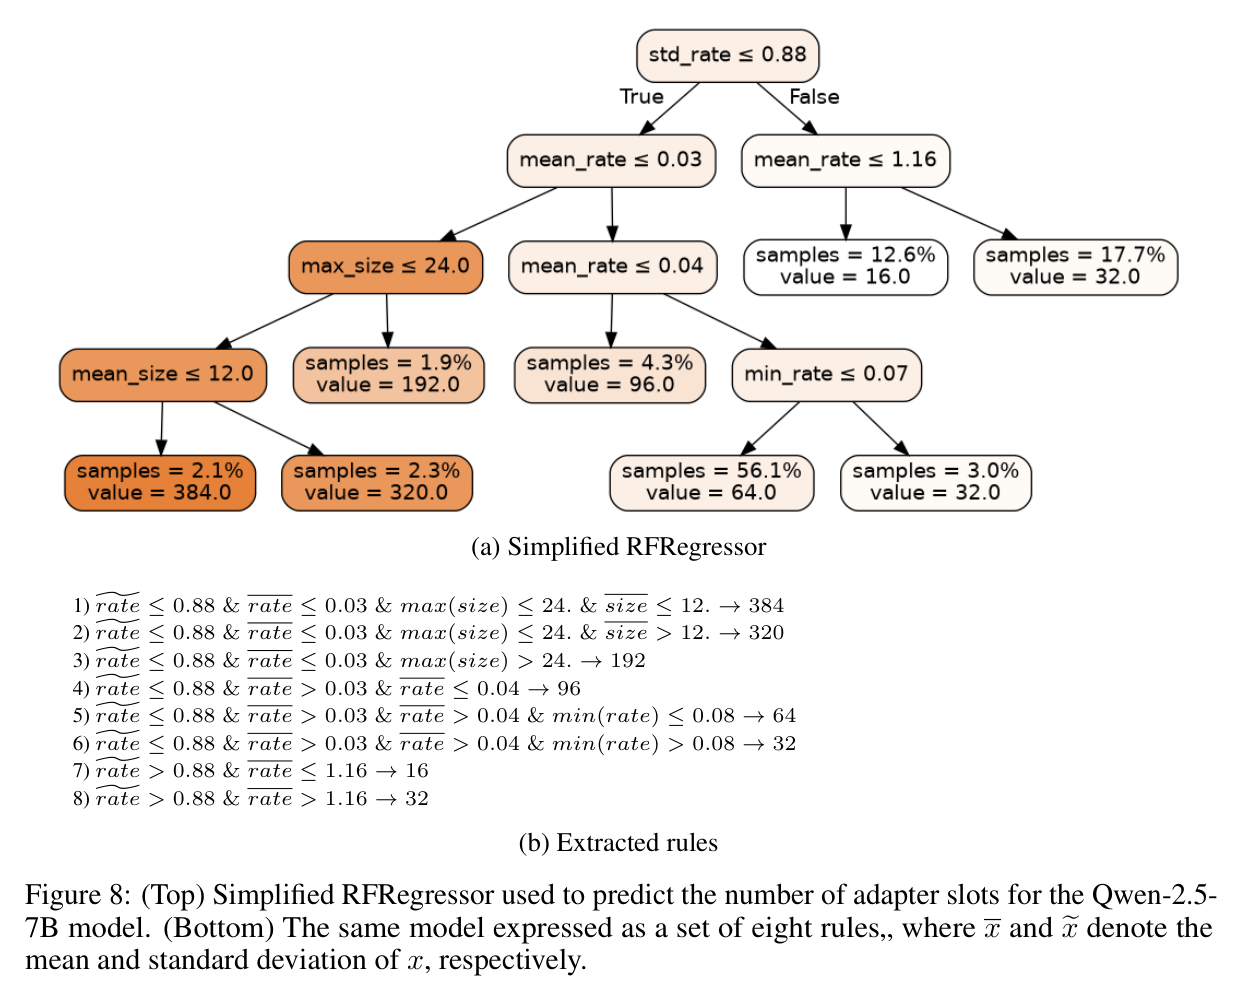
Paper's Figure 8, verbatim(caption: "(Top) Simplified RFRegressor used to predict the number of adapter slots for the Qwen-2.5-7B model. (Bottom) The same model expressed as a set of eight rules.")
这是本文可直接落地的成品:根节点先按 $\widetilde{rate}$(速率标准差)在 0.88 处分叉,低方差分支再看 $\overline{rate}$、$\max(size)$、$\overline{size}$,叶子直接给出 slot 数(384/320/192/96/64/32/16)。运维人员不需要跑模型,读八条 if...AND...→ G 就能配置 server。代价见 §4.4 第 5 条:Llama 上压缩后精度掉得不轻。
5.6 Workload regime —— 赢在哪、输在哪 #
论文没有给这张表,以下按其数据与自陈局限归纳。
| Workload regime | 本文方法 | 基线(人工/启发式,如 dLoRA 式贪心) | 为什么 |
|---|---|---|---|
| 大量 adapter、异构 rate/size(rate 跨 3.2→0.003125 三个量级) | 强:$N$ 误差 ≤1.0%,规则集覆盖整个 slot 量程 | 弱:启发式需要按场景重调阈值 | 8 维序统计量足以刻画分布,树模型能学到阈值型边界 |
| adapter 数少但个体差异极大 | 弱(作者自陈):只预测数量不预测"放哪个" | 相对占优:可按个体做放置决策 | 序统计量在小样本上失真;count-level 抽象丢掉了 placement 自由度 |
| 短请求为主(SmallRequest 23/27 tok) | 中:加载开销占请求延迟 7–16%(CPU)乃至更高(disk),模型未把长度入特征 | 相当 | 请求长度被固定为 ShareGPT 分布,短请求场景外推无保障 |
| 长请求为主 | 强:加载开销 <2%,$Lat_{load}$ 的建模误差影响可忽略 | 相当 | 固定开销被长 decode 稀释 |
| 高到达率 + 高 slot 数(最优点邻域) | 需警惕:DT 的 ITL/TTFT 在此最不准(Fig. 7) | — | 训练标签本身在该区域噪声更大 |
| 多 GPU / 多节点 | 不支持(§5 Limitations) | dLoRA 原生支持 | 全部建模假设单设备显存预算 |
| 非 vLLM 框架 | 部分:问题存在(Fig. 5),但 $Lat_{sched}$ 模型需重标定 | — | scheduler 项由 vLLM 实现形状决定 |
6. 论证链 #
| # | 论断 | 依据(论文内部) | 交给下一步什么 |
|---|---|---|---|
| 1 | adapter 权重与 KV cache 争抢同一块显存,因此"GPU 内 adapter 数"是一个有代价的旋钮 | Appendix A.1 / Fig. 2:常驻 adapter 数↑ ⇒ mean batch 线性↓ ⇒ 最大吞吐指数↓;模型越大、rank 越大越早触顶 | 确立 $G$ 不能一味调大 |
| 2 | adapter 计算开销由并行 adapter 数主导,且以 0→1 的一次性串行代价为主,不由 rank 之和主导 | Appendix A.2 / Fig. 3:0→1 跌幅最大,之后次比例;Appendix D 明言 CaraServe 的 rank sum/max 公式 "did not align with our results" | 确定 $Lat_{adapters}$ 的自变量为 $A_{running}$ |
| 3 | 加载开销是分段离散的、且相对影响强依赖请求长度 | Appendix A.3 / Fig. 4:disk 比 CPU 平均慢 70%;短请求 7–16%,长请求 <2% | 确定 $Lat_{load}$ 用查表而非拟合式 |
| 4 | 综合 1–3,吞吐对 $(N,G)$ 呈"升—饱和—饥饿"两段式,最优点是内点且随 workload 漂移 | §2 / Fig. 1 四面板:拐点随 size、输出长度、rate、slot 数显著移动 | 把问题定义为求 $(N^, G^)$,并用"吞吐 > 0.9×入流"操作化"不饥饿" |
| 5 | 逐场景真机搜索该最优点不可行,但用 1–3 的估计器拼一个 vLLM 主循环 emulator 是可行的 | §3 para 2 + Appendix C:复刻 FCFS + greedy KV + chunked prefill + LRU adapter cache;Eq. 1 的 $K$ 由 curve_fit 标定 | 得到 DT |
| 6 | 该 DT 精度足以生成训练标签 | §4.1 / Table 1:吞吐 SMAPE 4.2–5.1%,ITL 9.1–9.6%;成本 39.5–41.4 s/模拟小时、无 GPU、~200MB | 授权用 DT 造 87,198 条样本,真机 882 条只做测试 |
| 7 | 从 adapter 分布的 8 个序统计量到最优配置的映射是强非线性的 | §4.2 / Table 2:线性族在 $N$ 上齐刷刷 38.6–40.6% SMAPE,树族 0.05–1.01% | 选定树模型族 |
| 8 | 树模型可压成 <30 条规则而仍可用,从而能进生产 | Appendix G / Fig. 8:单树 max_depth=6, min_samples_leaf=10,八条规则覆盖 16–384 全量程;Table 2 Tree** 行 | 结论:可解释配置建议器,推理 ≤0.15 ms |
链条的两处薄弱环节(论文内部即可看出,非外部攻击):步骤 4 的 90% 门限无敏感性分析;步骤 6→7 之间,DT 自身 4–5% 的吞吐误差如何不污染 argmax,论文未论证(见 §4.5)。
7. 实现 cross-reference #
论文公开了代码仓库 https://github.com/FerranAgulloLopez/GPULLMAdapterOptimization(§0 摘要末句与 §1)。该仓库不在本次可读取范围内,因此无法给出 file:line 级引用:[实现未公开](就本次检索环境而言不可就地核对;仓库 URL 已记录,后续可补 L1 code 条目)。可从论文正文重建的实现契约如下。
核心技术壁垒(对应 §2 Q2)。要复刻这套东西,最难的一步不是训模型而是把 scheduler 时间建成一等公民并找对它的自变量组合。$Lat_{sched} = K_1 R_{running} + K_2 R_{waiting} + K_3 R_{waiting}(G/N)$ 中的交互项没有任何前人可抄——作者自称是 LLM serving 领域首个 scheduler latency 模型,并同时承认它"currently limited to vLLM"。这句话的含义是:这个函数形式是从 vLLM 具体调度循环的代码行为里逆向出来的经验形状,换 SGLang、TRT-LLM 或换一个 vLLM 大版本(V0→V1 调度器重写)都要重新做形状发现,而不是重新 curve_fit 一下常数就行。第二难点是承认并推翻 CaraServe 的 rank-based 开销模型:这需要先有 Appendix A.2 那组"逐个增加 batch 内唯一 adapter 数"的受控实验,才敢把自变量从 rank 换成 $A_{running}$。这两处都是测量方法学的壁垒,不是代码量的壁垒。
关键实现细节(容易漏掉的两个):
配置面与迁移成本。用户侧真正被改动的只有 vLLM 启动参数里的 adapter slot 上限(静态,server 启动时定死)与上层路由决定的并发 adapter 数——没有 kernel 改动,没有调度器 patch,不是 vLLM 的 fork。对一个已经在跑 vLLM 多 LoRA 服务的团队,采用成本 = 离线跑一次针对本地 (模型, 硬件) 组合的 $K$ 标定 benchmark + 用 DT 生成数据训一棵树 + 把 Fig. 8 那种规则集接到部署脚本里。代价集中在每换一个 (LLM, hardware) 组合就要重新标定一整套性能模型(§3 para 2 明说),这是该方法规模化的真正税负。