HPC Digital Twins for Evaluating Scheduling Policies, Incentive Structures and their Impact on Power and Cooling
S-RAPS: 把批调度器塞进超算数字孪生 — L2 #
1. TL;DR #
S-RAPS 把批调度器重构进 ExaDigiT 数字孪生的前向仿真环,使"换调度策略后功耗/冷却如何变"成为可离线回答的问题。五个真实系统数据集可回放亦可重排;backfill 把 PM100 利用率从 ~80% 推到 ~100% 并削平功率跳变;FastSim 耦合达 688× 实时。
2. Q1 / Q2 / Q3 #
Q1 — 痛点:调度评估与基础设施仿真是两个互不相交的世界 #
论文把先验工作切成两个不重叠的阵营。一边是数据中心数字孪生(DCDT):ExaDigiT 有 Modelica 冷却模型、功率变换损耗模型、可视分析模型,但"only replays the given workloads, therefore unable to re-schedule for what-if analysis"——它的 scheduler 类里装的其实是 replay 机制,节点放置甚至不被强制执行。另一边是批调度模拟器(Slurm Simulator、CQSim、Batsim、Alea、ScheduleFlow、FastSim 等十余种):它们把调度核心做到很深,但"generally are not focused on the systems infrastructure",没有功率、没有冷却、没有 PUE、没有冷却塔回水温度。
结果是一整类问题无人能答:如果把 FCFS 换成 priority+backfill,机房的功率摆幅会怎么变?如果给用户上一套省电激励机制,作业混合与回水温度会怎么响应?生产系统上做这种实验意味着可接受的服务中断,而两个阵营各自的工具都缺一半状态。
论文的场景锚点是 Frontier 的真实调度策略:一个被节点数加权提升、被超额占用惩罚的改良 FIFO。这类"策略参数是可调旋钮"的系统,恰恰最需要在部署前看到旋钮转动的物理后果。
Q2 — 方法:把 replay-only 的仿真环拆成"调度器接口 + 资源管理器 + tick" #
原 RAPS 的 Algorithm 1 是三步环:新作业入队 → ScheduleJobs(选择+放置)→ Tick(资源管理+利用率+功率+冷却)。S-RAPS 把它重构为四步,并把五个组件从硬编码提升为插件:
- 系统初始化:从 telemetry 同时构造 job 对象与 user/account 对象,把 resource manager 与 scheduler interface 分离。
- Dataloaders:每个系统一个插件,负责解析 telemetry 并产出待调度作业列表;每作业最少需要 submit/start/end time、time limit、请求节点数(或确切节点集合),外加 telemetry 起止时间。
- 仿真引擎:四步环 = 清理已完成作业 → 加入已提交作业 → 调用 schedule → 调用 tick。
- 调度器抽象:三段契约,桥接前向时间步与事件驱动外部模拟器。
- 系统计账:把统计从"系统级功率能耗"扩展到 job/user/account/scheduler 四层。
- 预填充(prepopulation):仿真起点之前已在跑的作业会被放置到系统上,使 $t=0$ 的机器状态与 telemetry 观测一致。论文的脚注直指同行:"This is often neglected by scheduling simulators, which ignore jobs before simulation start, and therefore need time to fill up the queue and system, distorting the results."
- 无未来信息(no clairvoyance):重构后作业只有在提交之后才可被调度,"pre-computing a schedule is not possible as the digital twin observes the jobs as they are submitted, just like a real system"。这是把 replay 模式的"全队列可见"退化掉的关键约束。
- 缺失数据规则:重排后作业的 telemetry 时间片与仿真时间对不上时,一律"use the last known value"。
- PM100 第 50 天:replay 利用率 ~80%(队列在堆积),两种 backfill 策略持续 ~100%;每作业平均功率 $-2\%$、作业规模 $-5\%$;21:00 的功率跳变被 backfill 削平。
- Frontier 那一天(有冷却模型):三个 9216 节点全系统作业被 S-RAPS 排得比 replay 更早;功率、PUE、冷却塔回水温度在四种策略下明显分叉。
- Adastra 15 天:低负载下所有重排曲线塌成一条线——策略无关。论文把这个空结果重新解释为功率模型预测保真度的验证。
- FastSim 顺序耦合:5324 作业 / 15 天在 31 min 24 s 内跑完,688× 实时。
- ScheduleFlow 耦合:功能上通,真实数据集上性能不可用,且附录披露它会把作业排到不可用节点上、根因未查明。
- 量纲一致性:不通过。$X^j_i$ 混合了时长(s)、功率(W)、内存(B)与静态特征,$\sqrt{X+1}$ 对有量纲量取根号本身无量纲意义,且 $+1$ 的单位未定义。这意味着打分对特征归一化尺度敏感——附录确实在推理阶段先做 feature normalization,但方程本身没有把归一化写进来。
- 边界情形 $X^j_i = 0$:良定。内层 $=1$,外层 $=e$,即零特征拿到该项的最大贡献。对"预测功率 = 0"这类退化预测,打分给出最高优先级,这是一个需要上游预测器保证非退化的隐含前提。
- 值域与单调性:对 $X \ge 0$,每一项落在 $(1, e]$ 且随 $X$ 单调递减。故 $S \in \left(\sum_j \alpha_j, \; e\sum_j \alpha_j\right]$(当所有 $\alpha_j > 0$)。整体单调性成立:任一特征增大都使 $S$ 减小。
- 判别力(论文声称与实际相反):论文说指数"captures fine-grained differences"。但把 $X$ 从 100 增到 10000,内层从 $\approx 0.0995$ 降到 $\approx 0.0100$,外层从 $1.105$ 降到 $1.010$——两个量级的特征差异被压缩到 $\sim 0.1$ 的分数差内。真正的细粒度区分发生在 $X \in [0, 3]$ 附近。这是论文自陈机制与数学行为的一处实质性错位。
- 退化/极值位置:$S$ 无内点极值——梯度 $\partial S / \partial X^j_i < 0$ 处处成立,最优解总在特征取值域的边界(最小特征)上。因此该打分等价于"偏好各特征都尽量小的作业",在高负载下退化为"优先小作业"。论文自己承认高负载下机制就是"prioritizing smaller jobs over larger ones"。
- 一阶回代:无法完成。论文既未给出 $\alpha_j$ 的取值,也未给出 $K$ 与特征清单,因此无法把 Fig. 10 的工作负载代回方程验证报告的排序。Fig. 10(b) 的雷达图是 L2 归一化后的多指标对比,不是从该方程推导出的预测值。这是一个 sweep-then-report 而非 model-then-verify 的结果。
- 利用率-功率摆幅的定量关系:backfill 削平功率跳变的幅度应当是队列中小作业存量与节点碎片分布的函数。现在只有"$-2\%$ 平均功率"这一个数据点,无法回答"换一个作业混合还能削多少"。
- 策略无关区的边界:Adastra(低负载)与 Fugaku 的 16% 请求节点利用率窗口都表现出策略无关,而 PM100 与 Frontier 的高负载窗口策略强相关。这个相变点应当有解析刻画(例如以到达率/服务率比与作业规模分布为参数),论文只给了两个定性区间。
- 耦合开销的可预测性:plugin 模式要求 S-RAPS 与 FastSim 各维护一份系统状态副本,"reduces communication between the two simulators at the cost of additional computational overhead"。这个权衡本该是一个通信量对状态复制成本的比较模型;现在只有"顺序耦合更快"的定性结论和一个 688× 的顺序模式数字。
- 账户统计的跨运行存取:
--accounts保存、--accounts-json载入。这个不起眼的开关是激励结构研究的全部机制——收集期(replay)产出/accounts.json accounts.json,赎回期五次运行从同一份账户历史派生优先级。没有它,Fig. 8 的两阶段实验不可能存在。附录的任务依赖写得很明确:$T_{11}\rightarrow[T_{12}..T_{16}]\rightarrow T_{17}$。 - 时间序列特征先做摘要再聚类:PM100 之类给轨迹的数据集不能直接喂 K-means——"timeseries data is inherently noisy and high-dimensional, this causes inaccuracies in the clustering",故先抽 max / min / std 等摘要统计量。这一步同时也是让轨迹型与摘要型数据集在同一 ML 流水线里共存的唯一手段。
- 缺失数据用"最后已知值":重排后 telemetry 时间片错位一律沿用上一个已知值。对 Fig. 3 中 Job 1(仿真前已启动)与 Jobs 6/7/8(仿真后才结束)这类边界作业,论文要求打标记,因为它们"can cause potential discrepancies in other simulations as no known ground truth is available"。
三个容易被略过但决定结论可信度的设计选择:
核心技术壁垒:不是任何单一算法,而是让一个前向时间步的物理协同仿真环(功率 → 热 → CDU → 冷却塔)与一个事件驱动的批调度器共享同一份系统状态,且在同一个时间步内既有作业结束又有作业开始时仍保持节点账目自洽。论文对此的表述极其低调——"These descriptions seem simple, but required major changes from the simple replay mechanism","the refactor resolved timing and allocation issues for nodes with both ending and starting jobs coinciding in the same time step"。这一句话背后是整篇论文唯一无法靠读论文复现的东西:replay 模式下强制执行 telemetry 记录的确切节点放置,重排模式下由调度器选节点、资源管理器落实分配,两条路径共用一套 tick,且冷却模型对状态错误极其敏感(PUE 与回水温度是积分量,节点账目漂移会累积)。
Q3 — 结果:策略差异在高负载下变成可见的物理量,在低负载下消失 #
3. 架构 / 方法图 #
3.1 重构前:replay-only 的 ExaDigiT #
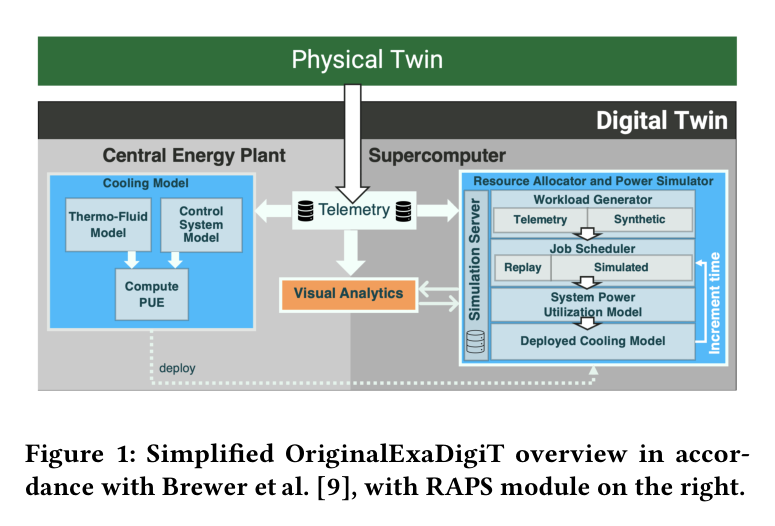
Paper's Figure 1, verbatim(caption: "Simplified OriginalExaDigiT overview in accordance with Brewer et al., with RAPS module on the right.")。
读这张图要注意的是数据流是单向的:telemetry/job trace → 按记录回放节点利用率 → 功率模型(含整流与变换损耗)→ 冷却模型(CDU 到冷却塔)。图里没有任何反向箭头允许"改变作业何时开始",这正是 §2.1.1 指出的结构性缺口。
3.2 重构后:S-RAPS #
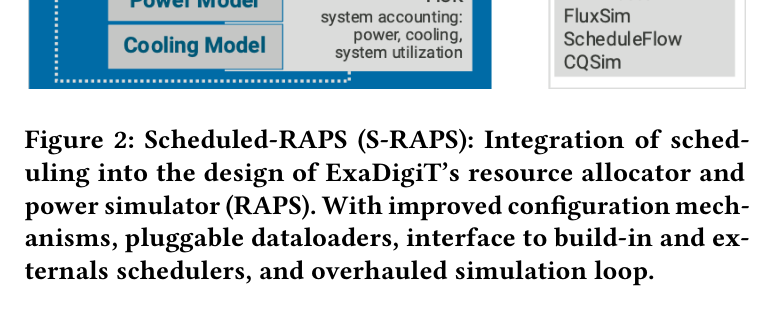
Paper's Figure 2, verbatim(caption: "Scheduled-RAPS (S-RAPS): Integration of scheduling into the design of ExaDigiT's resource allocator and power simulator (RAPS). With improved configuration mechanisms, pluggable dataloaders, interface to build-in and externals schedulers, and overhauled simulation loop.")。
与 Fig. 1 对比,唯一但决定性的差别是 scheduler 从 tick 内部被提出来变成一个接口:tick 被窄化为"only responsible for the simulation of physical sub-systems",而排序与放置决策移到 schedule 里,由内建策略或外部模拟器提供。dataloader 从硬编码变成插件是让五个异质数据集共存的前提。
3.3 请求生命周期与调度器契约(Mermaid 补充结构) #
原文没有给出时序图;四步环与三段调度器契约散落在 §3.2.3/§3.2.4 的散文里,下图把它们对齐到一个时间步内。
关键点在第 (3) 步的分支:SI→SC 这条边就是三段契约——触发(或判断无事件而跳过)重算、解释返回信息、再驱动资源管理器落实放置。外部模拟器只需要能回答"给定时间步 t 的运行作业列表",其内部事件模型与状态副本对 S-RAPS 不可见。
排队学科(queueing discipline):内建调度器提供 replay / FCFS / SJF / LJF / priority 五种 --policy,以及 no-backfill / first-fit / easy(EASY) 三种 --backfill;明确未实现 best-fit、greedy、conservative。优先级取自各数据集及其文档,不是论文自造的。
分配单元与抢占:分配粒度是整节点(共享节点的作业在 PM100 上被直接过滤掉,"as this is not yet supported in our model")。没有抢占、没有准入控制、没有 per-tenant 公平性保证;公平性只以事后度量出现(area weighted response time、priority-weighted specific-response time)。数据集里没有预留、作业依赖、down/drained 节点信息——这是论文自己标注的精度上限。
3.4 事件与时间步的对齐 #
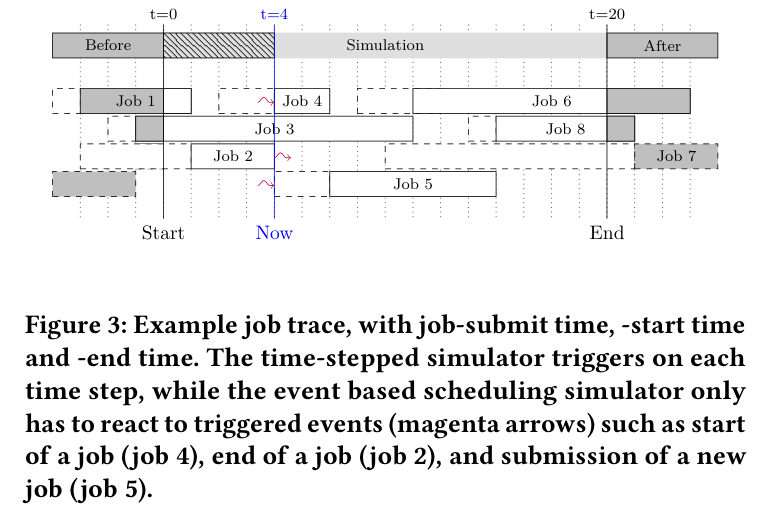
Paper's Figure 3, verbatim(caption: "Example job trace, with job-submit time, -start time and -end time. The time-stepped simulator triggers on each time step, while the event based scheduling simulator only has to react to triggered events (magenta arrows) such as start of a job (job 4), end of a job (job 2), and submission of a new job (job 5).")。
这张图是理解耦合成本的钥匙:S-RAPS 每个时间步都要走一遍环,而事件驱动调度器只在 $t=4$ 这样有事件发生时才需要动作。读者应注意 Job 1(仿真开始前已启动)与 Jobs 6/7/8(仿真结束后才结束)——论文脚注承认这两类作业在重排时可能没有对应时刻的 telemetry,必须打标记,因为"no known ground truth is available to S-RAPS"。
4. 作者证明 #
论文只有一个方程(§4.4.2 的 ML 打分函数,未编号),而且它属于 ML 用例而非框架本体。框架部分(吞吐、功率、排队)无形式化作者证明 — 仅实证。下面先审那唯一的方程,再列出缺失的模型本该澄清什么。
4.1 记号表 #
$$S(X_{i}) = \sum_{j=1}^{K} \alpha_{j} \cdot \exp\left( \left( \sqrt{X^{j}_{i} + 1} \right)^{-1} \right)$$
| 符号 | 论文定义 | 量纲 / 取值 |
|---|---|---|
| $S(X_i)$ | "the score of job $X_i$" | 无量纲排序键 |
| $X^{j}_{i}$ | "the $j$-th feature of the $i$-th job" | 混合量纲(预测运行时长、功率、内存 + 静态特征) |
| $\alpha_j$ | "the coefficient of feature $j$" | 权重,论文未给具体取值 |
| $K$ | 求和上界(特征数) | 整数;论文未单独定义 |
4.2 方程的物理意义 #
内层 $\left(\sqrt{X^{j}_{i}+1}\right)^{-1}$ 是特征值的单调递减饱和变换:特征越大,该项越趋于 0。外层 $\exp(\cdot)$ 把它映到 $(1, e]$:小特征值 → $e$,大特征值 → $1$。$+1$ 是 $X=0$ 的保护项。$\alpha_j$ 的线性加权是"多目标"的全部来源——论文的原话是这支持"trade-offs across throughput, wait time, turnaround, and energy",而不是单目标调度器。
4.3 六项最小检查 #
4.4 缺失的框架模型本该澄清什么 #
框架论文通常有吞吐/延迟/成本模型;本文没有。若有,至少三件事会从"图上可见"变成"可外推":
5. 实验与数据 #
5.1 系统与数据集矩阵 #
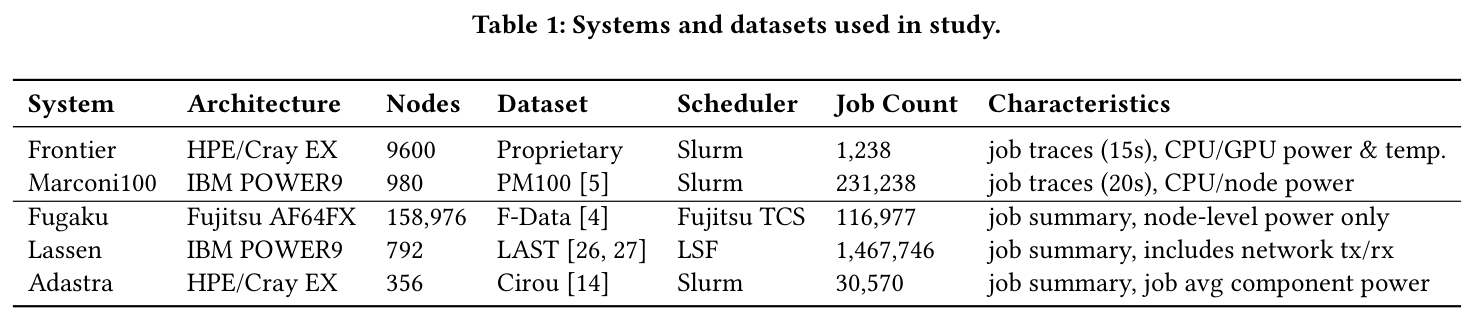
Paper's Table 1, verbatim(caption: "Systems and datasets used in study.")。
这张表决定了后续每张图能问什么问题。Marconi100 与 Frontier 提供逐作业资源利用率轨迹(20s / 15s),Fugaku、Lassen、Adastra 只有作业摘要(均值/标量)。作业数从 Frontier 的 1238 到 Lassen 的 1467746 跨三个量级,而携带论文两张最详细图(Figs. 6、8)的偏偏是作业数最少的 Frontier——因为它是唯一有经过验证的冷却模型的系统,也是唯一不公开的数据集。
度量定义:图中 "system power" 是功率模型计算值(含整流与变换损耗),不是 telemetry 求和;"utilization" 按节点占用计;PUE 与冷却塔回水温度来自 Modelica 冷却模型。调度侧指标为 wait time / turnaround time / EDP / ED2P / area weighted response time / priority-weighted specific-response time。没有 p50/p99 之类的分位数——这是 HPC 批调度语境而非在线服务语境。
5.2 高负载:backfill 把利用率与功率形状同时改写 #
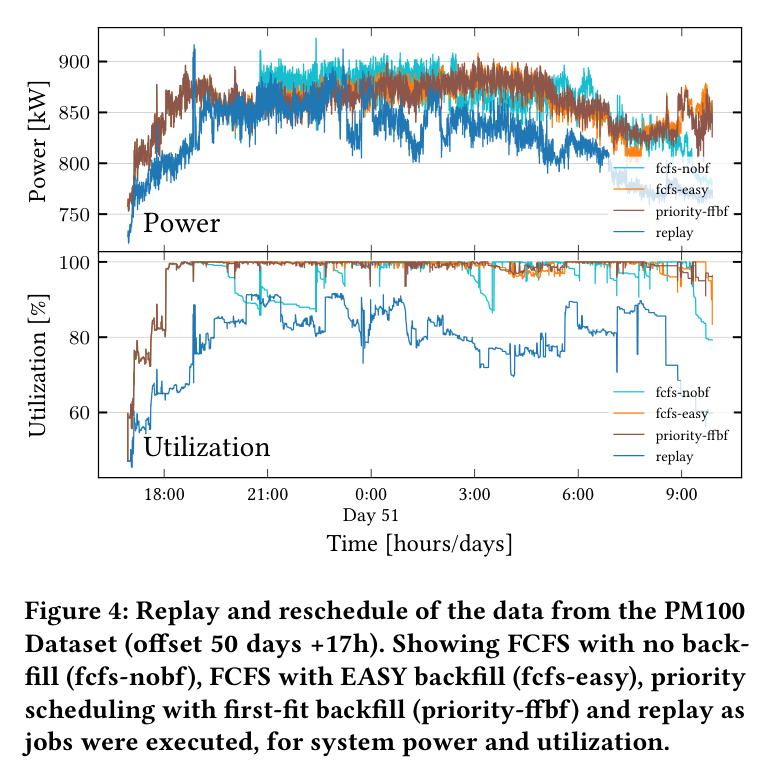
Paper's Figure 4, verbatim(caption: "Replay and reschedule of the data from the PM100 Dataset (offset 50 days +17h). Showing FCFS with no backfill (fcfs-nobf), FCFS with EASY backfill (fcfs-easy), priority scheduling with first-fit backfill (priority-ffbf) and replay as jobs were executed, for system power and utilization.")。
利用率面板:replay(蓝)贴在 ~80% 且队列在堆积,两条 backfill 曲线持续 ~100%。功率面板:无 backfill 的 fcfs-nobf(青)聚合功率更高,且在 21:00 有一个功率跳变,被 backfill 削平。读者应同时记住 §2.2 的自陈警告——PM100 过滤掉了共享节点作业,"replay and reschedule will differ",所以 80% vs 100% 这个对比在构造上就对 replay 不利。
5.3 加上冷却模型:策略差异传导到 PUE 与回水温度 #
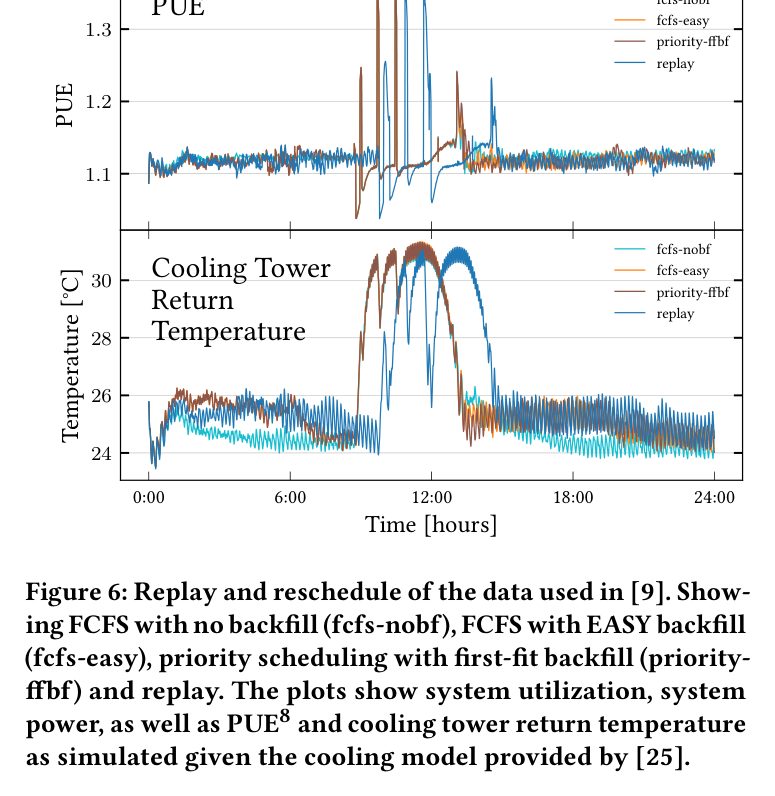
Paper's Figure 6, verbatim(caption: "Replay and reschedule of the data used in Brewer et al. 2024. ... The plots show system utilization, system power, as well as PUE and cooling tower return temperature as simulated given the cooling model provided by Kumar et al. 2024.")。
这是全篇唯一把调度决策一路传导到冷却塔的证据链:利用率面板显示系统为三个 9216 节点全系统作业腾空节点,三个大作业跑完后回到常规作业混合;四条策略曲线在"如何腾空系统"上分叉,而 PUE 与回水温度随之分叉。两点必须同时读:(a) S-RAPS 把大作业排得比 replay 更早,三种重排策略在启动时刻上完全重合;(b) 作者自己把 backfill 相对 replay 的利用率优势归因于缺少 down/drained 节点信息而非策略优越——一个主动折扣自家最醒目结果的罕见做法。脚注给出真实系统 PUE 均值 ≈1.06 作为该面板的唯一 ground truth。
5.4 外部调度器耦合:从可用性到预测能力 #
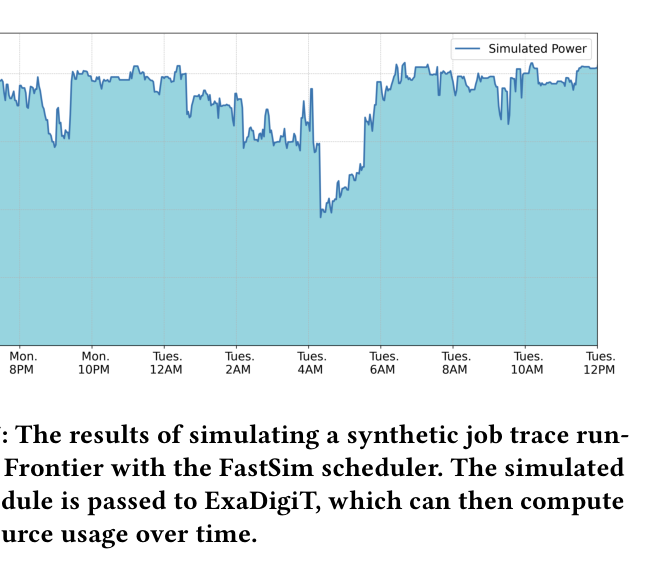
Paper's Figure 7, verbatim(caption: "The results of simulating a synthetic job trace running on Frontier with the FastSim scheduler. The simulated job schedule is passed to ExaDigiT, which can then compute the resource usage over time.")。
图中的目标特征是周二上午的功率先跌后冲。这是论文唯一的前瞻性演示:调度侧模拟器足够快(5324 作业 / 15 天在 31 min 24 s 内,688× 实时),孪生体因此从事后解释走向事件预报,而预报功率骤变正是能耗感知调度的输入。要注意 688× 来自顺序耦合(FastSim 排完再交给 RAPS),而 §4.2.2 花最多篇幅描述的 plugin 模式——也就是实时孪生真正需要的那个模式——速度从未被报告。
5.5 ML 引导策略:负载分区决定一切 #
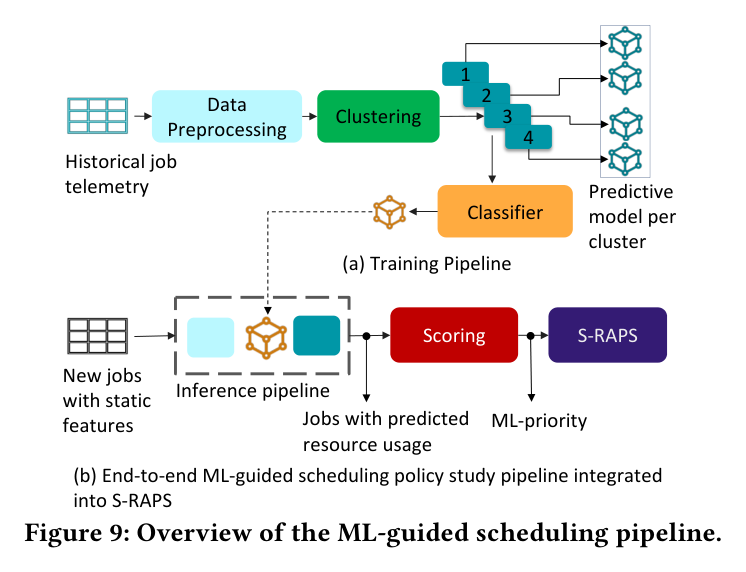
Paper's Figure 9, verbatim(caption: "Overview of the ML-guided scheduling pipeline.")。
训练三段:K-means 按静态(作业规模)+ 动态(功率轨迹)特征聚类 → Random Forest 从提交前特征映射到簇标签(因为动态特征在提交时不可得)→ 每簇一个回归模型预测运行时长/功率/内存。推理时归一化特征、预测簇、调用对应模型、算出 §4.4.2 的打分。这条流水线的存在本身就是论文的论点:它需要跨作业的功率轨迹与调度记录同时在手,而这只有在孪生体内部才成立。
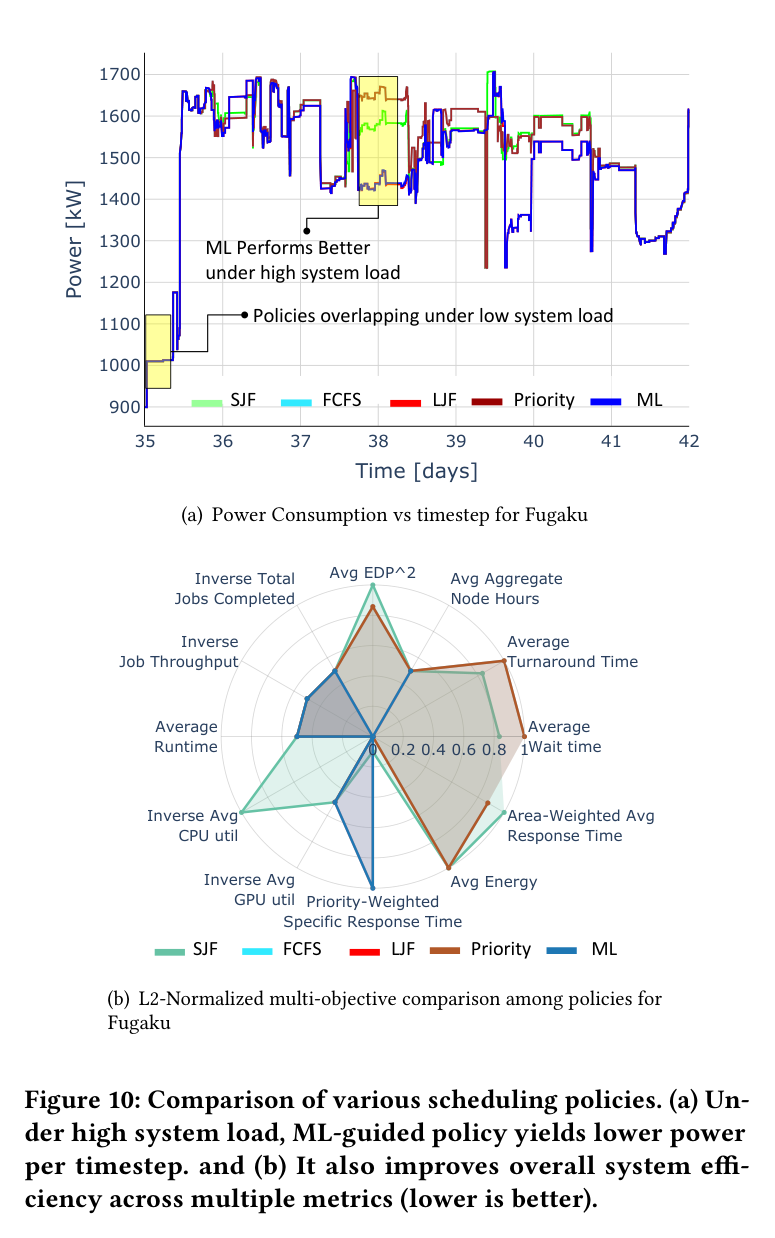
Paper's Figure 10, verbatim(caption: "Comparison of various scheduling policies. (a) Under high system load, ML-guided policy yields lower power per timestep. and (b) It also improves overall system efficiency across multiple metrics (lower is better).")。
(a) 的两个黄色标注区是全图的关键:左侧低负载区(16% 请求节点利用率)五种策略行为几乎重合——资源充裕时几乎不排队,策略影响被抹平;右侧高负载区 ML 策略降低了每时间步的功率尖峰。(b) 是 L2 归一化的多指标对比(越低越好),支撑"最佳多目标折中 + 最低 turnaround 与 EDP"。两处需要打折:文中称"consistent trends across datasets"但两个子图都只标 Fugaku,附录确认 $A_4$ 只用了 F-Data;且 ML 策略的自陈机制"优先小作业"与同图基线 SJF 行为高度接近,论文从未解释学到的排序为何优于朴素 SJF、优多少。
5.6 工作负载分区:这套东西在哪里赢、在哪里根本无所谓 #
| 工作负载区间 | S-RAPS 重排 | Replay 基线 | 为什么 |
|---|---|---|---|
| 低负载(Adastra 15 天;Fugaku 16% 请求利用率窗口) | 与 replay 及彼此不可区分,全部曲线塌成一条 | 相同 | 队列不堆积,作业提交即可运行,策略没有可施加的自由度 |
| 高负载 + 小作业富集(PM100 day 50) | 利用率 ~100%,每作业均功率 $-2\%$、规模 $-5\%$,功率跳变被削平 | ~80%,队列堆积,21:00 出现功率跳变 | backfill 有足够的小作业填缝;节点碎片被消化 |
| 高负载 + 全系统大作业(Frontier,含冷却模型) | 大作业排得更早;PUE 与回水温度随策略分叉 | 腾空更慢 | 但作者把利用率优势归因于缺失 down/drained 节点数据,而非策略 |
| 事件驱动外部调度器 + 真实数据集(ScheduleFlow) | 功能通但性能不可用;且会排到不可用节点(根因未查明) | — | 每时间步触发全量重算,ScheduleFlow 未为此用例设计 |
| 事件驱动外部调度器 + 合成轨迹(FastSim,顺序耦合) | 688× 实时,可预报功率骤变 | — | 顺序耦合避开双状态副本开销 |
低负载区间是论文自己交出来的失败区:孪生体的核心能力在那里不产生任何差异。
5.7 基线公平性 #
四种策略的对比是同一实现内部的策略切换,不涉及跨框架对比,所以不存在"基线是否调优"的通常问题;但存在三个自陈的构造性偏差:PM100 的共享节点过滤(对 replay 不利)、缺失 down/drained 节点信息(对重排有利)、以及 Frontier 与 Fig. 8 的数据不公开(附录给了一个 Marconi100 替代方案,并承认结果"may not as easily readable as the result shown in the paper")。外部调度器方面,ScheduleFlow 的负面结果被保留在正文而非删除。
6. 论证链 #
| # | 步骤 | 论文内部依据 | 承接下一步 |
|---|---|---|---|
| 1 | 调度评估的现有工具分成两个不相交阵营:有基础设施模型但只能回放的 DCDT,与有调度深度但无功率/冷却的模拟器 | §2.1.1 对 ExaDigiT 的自陈限制("only replays the given workloads, therefore unable to re-schedule")+ §2.1.2 十余个模拟器"generally are not focused on the systems infrastructure" | 因此"换策略后物理量怎么变"无人可答 → 步 2 |
| 2 | 要回答该问题,必须把调度决策放进物理协同仿真环内部,而非在环外预计算一个时间表 | §3.2.3:作业只有提交后才可调度,"pre-computing a schedule is not possible as the digital twin observes the jobs as they are submitted";tick 被窄化为只做物理子系统 | 需要一次结构性重构 → 步 3 |
| 3 | 重构 = 五个组件插件化(初始化 / dataloader / 仿真引擎 / 调度器抽象 / 计账)+ 三步环变四步环 | §3.2 的五组件枚举;§3.2.3 的四步环;预填充消除队列预热失真;同一时间步内起止作业的节点账目被修正 | 得到一个可换策略、可换数据集、可换调度器的骨架 → 步 4 |
| 4 | 骨架在高负载下确实把策略差异转化为可观测的物理量差异 | Fig. 4:利用率 80%→100%,21:00 功率跳变被削平,$-2\%$ 均功率 / $-5\%$ 作业规模;Fig. 6:功率、PUE、冷却塔回水温度随策略分叉 | 但差异是否只是高负载现象?→ 步 5 |
| 5 | 低负载下策略无关;此时同一套机制转而验证功率模型的预测保真度 | Fig. 5:Adastra 所有重排曲线重合,且模拟功率与观测的升降时刻对齐;Fig. 10(a) 左侧 16% 利用率区五策略重合 | 说明骨架的价值不止于策略对比,还在于"给定作业剖面即可预测功率" → 步 6 |
| 6 | 调度器抽象足够通用,可驱动外部模拟器;其中快模拟器把孪生体从事后解释推向事件预报 | §4.2.1 ScheduleFlow 功能通但性能不可用(作为模板保留);§4.2.2 FastSim 顺序耦合 688× 实时,预报出周二上午功率骤降后骤升(Fig. 7) | 预报能力 + 账户级计账 → 步 7 |
| 7 | 账户级计账在环内后,两类此前无法离线研究的策略成为可能:激励结构与 ML 引导排序 | §4.3:replay 作收集期、四种赎回期优先级键(avg power / low avg power / EDP / Fugaku points),Fugaku points 如设计意图般惩罚三个大功率作业(Fig. 8);§4.4:五策略对比,ML 策略在高负载下功率尖峰与 EDP 最低(Fig. 10) | 支撑"孪生体内调度 = 生产系统上不可做的实验的替代场"这一总论点 |
7. 实现 cross-reference #
代码库为 ExaDigiT/RAPS 的三个分支(S-RAPS、fastsim-integration、ml-guided-scheduling / arunavo),托管于 code.ornl.gov/exadigit/raps,非 GitHub 且本地未克隆,因此以下为论文给出的文件级定位,行号未公开。
| 组件 | 路径(论文给出) | 作用 |
|---|---|---|
| 入口 | main.py | CLI:--system / --scheduler / --policy / --backfill / -ff(fast-forward)/ -t(仿真时长)/ -c(冷却模型)/ -o(输出)/ --accounts / --accounts-json |
| 数据集插件 | raps/dataloaders/ | 每系统一个;"Descriptions for usage of the datasets are part of the dataloaders in S-RAPS directory" |
| 激励结构策略 | raps/schedulers/experimental.py | acct_avg_power / acct_low_avg_power / acct_edp / acct_fugaku_pts 等由账户历史导出优先级的策略 |
| FastSim 耦合产物 | raps/schedulers/fastsim_artifact/ | synthetic_jobs.py、transform_data.py、plot_results.py + 五个阶段性数据集(sacct_jobs.csv、frontier_simulation_results.csv、jobs.parquet、jobsprofile.parquet、raps_results.csv) |
| ML 流水线 | app-fingerprinting/(submodule) | driver.py fugaku {split,train,test};配置在 app-fingerprinting/config;产物在 models/(clusterer / cluster_classifiers / prediction_models 的 pkl)与 results/(inference_results.parquet) |
| 绘图 | scripts/plots/2in1-pm100day50.py、2in1-adastra.py、4in1-frontier-wC.py、fgk_frontier.py;app-fingerprinting/scripts/plot_power.py、plot_stats.py | 分别对应 Figs. 4、5、6、8、10 |
| 单次运行输出 | simulation_results/<7-hex>/ | job_history.csv、power_history.parquet、loss_history.parquet、queue_history.csv、running_history.csv、util.parquet、stats.out、acounts.json(拼写如原文)、cooling_model.parquet(有冷却模型时) |
FastSim 本体闭源("not open at the time of this writing"),故该分支以阶段性数据集代替端到端执行;Frontier 数据集不公开,Figs. 6 与 8 无法公开复现(Fig. 8 有 Marconi100 替代路径)。
7.1 核心技术壁垒的落地形态 #
Q2 中指出的壁垒——前向时间步物理仿真与事件驱动调度器共享自洽系统状态——在实现上表现为两条互斥的耦合路径,而这正是外部无法从论文重建的部分。plugin 模式下 FastSim 被改造为"应答给定时间步的系统状态":处理到该时间步为止的所有事件,返回按 job ID 索引的运行作业列表;代价是两个模拟器各持一份系统状态副本,"reduces communication between the two simulators at the cost of additional computational overhead"。顺序模式下 FastSim 先独立排完整个时间表,再由 RAPS 做资源管理与回放;对历史重排更快,688× 就是这条路径的数字。真正难的是前者:实时孪生必须走 plugin 模式,而两份状态副本的一致性没有任何论文级描述,只有一句"requires both S-RAPS and FastSim to maintain separate copies of the system state"。附录披露的 ScheduleFlow 缺陷("scheduleflow may schedule even if nodes are unavailable, which we report as error... Why this discrepancy occurs has yet to be fully debugged")正是这类状态不一致的实证:S-RAPS 侧检查到节点不可用而抛错,且"does not always occur",说明是竞态性质的状态漂移。任何想复用这个抽象的人会撞上同一堵墙。
7.2 关键实现细节(易被忽略) #
8. API 与可用性 #
用户界面是 CLI,不是 OpenAI-compat 之类的服务接口——这是一个离线仿真器。核心旋钮组合为 --system × --scheduler {default,experimental,scheduleflow,...} × --policy × --backfill,加上时间窗口的 -ff(fast-forward 秒数或 35d 形式)与 -t(仿真时长,61000 或 7d),以及 -c(挂冷却模型)、-o(落盘)、--accounts 家族。运行时有交互式 TUI 显示统计。
配置面不大但存在若干粗糙处:附录命令里出现重复的 --scheduler experimental --scheduler experimental、Adastra 步骤复制粘贴留下 mkdir marconi100、AE 与 AD 之间 inference_reselts.parquet / inference_results.parquet 拼写不一致、以及 Adastra 第四次运行写成 --policy easy 而图例是 priority-ffbf。这些都是论文原文保留的,复现者需要自行判断。
依赖极轻:Python 3.9+(测试到 3.13)、matplotlib/numpy/pandas/scipy/pyarrow/rich/tqdm/requests/fmpy,ML 分支再加 scikit-learn/joblib/plotly/kaleido。硬件要求是"Laptop capable of running python 3.9+"——没有 GPU,没有集群。全部复现预算:$A_2$ ≈185 min(含 25 min 下载 ~4GB 数据集),$A_4$ ≈230 min(其中训练 27 min、5 次仿真 200 min),$A_3$ ≈32 min。
9. 生态与采用 #
S-RAPS 是 ExaDigiT 的分支演进,不是独立项目:$A_2/A_3/A_4$ 三个分支"will eventually be merged into"基线仓库 $A_1$(DOI 10.11578/dc.20240627.4)。作者横跨 ORNL、Texas State、NREL、Colorado State、LLNL 四家机构,数据来自 Frontier、Marconi100、Fugaku、Lassen、Adastra 五个 top-tier 系统——这个作者与数据的分布本身就是采用面的证据:想接入自家系统只需写一个 dataloader 插件。
论文对生态的姿态是明确的"不竞争、只接入":十余个既有调度模拟器被逐一点名并承认其价值,"we do not compete but try to enable them, and provide example integration in the source-code"。代价是它强制下游接受两个约束:(a) 外部调度器必须能应答"给定时间步的运行作业列表",事件模型要么改造成 plugin 模式(ScheduleFlow 就是在这里性能崩掉的),要么退化为顺序耦合;(b) 冷却侧要有 Modelica 模型,而"No open cooling model was available at the time of writing, e.g. for PM100"——这直接导致 Fig. 6 那类最有价值的 PUE/回水温度分析目前只能在 Frontier 上做。
一个尚未闭合的依赖:FastSim 闭源,因此 $A_3$ 的端到端流程对外只能以阶段性数据集形式交付。
10. 部署上下文 #
在真实系统中的位置:这不是在线服务组件,而是运维/规划侧的离线(或准实时)决策支持层。它坐在两类数据源下游——批调度器的作业记录(Slurm / LSF / Fujitsu TCS)与设施遥测(此处为 Cray EX Telemetry API + STREAM 平台)——输出是"若改变调度参数,功率/PUE/回水温度与用户公平性指标会如何变"。脚注 3 点出了准实时用法:"This also allows S-RAPS to simulate anticipated schedules and profiles from live-data."
受益规模区间:只有在队列会堆积的高负载系统上才产生差异化结论。Adastra 与 Fugaku 低负载窗口的空结果给出了明确的适用下界。反过来,节点数越大、全系统作业越多(Frontier 的 9216 节点作业)、功率摆幅越大,这套工具的价值越高。
硬件亲和性:仿真本身跑笔记本;真正的硬件耦合在冷却模型侧——液冷系统(Frontier 的 CDU 到冷却塔链路)才有 PUE/回水温度可算,风冷系统的收益会小得多。数据集侧的分野同样重要:能给出逐作业功率轨迹的系统(Marconi100、Frontier)支持完整分析,只有作业摘要的系统(Fugaku、Lassen、Adastra)只能做粗粒度重排。
迁移路径:一个运行 Slurm 的中心要采用这套东西,需要 (1) 写一个 dataloader 插件,把本地作业记录映射到 submit/start/end/limit/nodes + telemetry 起止时间;(2) 若要冷却分析,生成一个 Modelica 冷却模型(作者指向 datacenterCoolingModel 与 autocsm 两个自动化工具);(3) 若要复用自家调度器逻辑而非内建 FCFS/SJF/LJF/priority,实现三段调度器契约。前两步是数据工程,第三步是唯一需要理解耦合语义的部分。
当前的硬约束:论文自陈的瓶颈是"the current need of job traces, and power profiles"。Fig. 5 证明了在完美作业剖面信息下功率摆幅可被准确预测,但没有剖面时只能退回用户估计或指纹识别/预测——后者被点名为后续工作,而 §4.4 的 app-fingerprinting 模块已经是它的雏形。数据集里没有预留、作业依赖、down/drained 节点信息,这三项缺失是当前精度天花板,作者认为补上"could greatly increase the accuracy of schedules, especially when linking the DCDT to a live system"。