Cache-to-Cache: Direct Semantic Communication Between Large Language Models
Cache-to-Cache: Direct Semantic Communication Between Large Language Models — L2 #
1. TL;DR #
两个 LLM 不再用文本对话,而是让 Sharer 的 KV-Cache 经神经网络投影后、以残差 + 逐层门控的方式融进 Receiver 的 KV-Cache。冻结双模型只训融合器:比单模型高 6.4–14.2%、比文本通信高 3.1–5.4%,且平均 2.5× 加速(省掉逐 token 解码)。
2. Q1 / Q2 / Q3 #
Q1 · 痛点(为什么文本通信不够) #
多 LLM 协作当前全部走 text-to-text (T2T) 接口:模型把高维内部表示压成 token 串,接收方再解压。三个固有缺陷:
- 信息瓶颈:文本是低带宽介质,高维语义被压成线性字符串后不可逆地丢失(例:把
作为"段落分隔符"的结构语义无法用一句话可靠传达)。 - 歧义:自然语言天生歧义,即便 MCP / A2A 协议也不足以支撑开放域灵活协作。
- 延迟:每一次交换都要串行逐 token 解码;Sharer 解码 80 个 token 就要 ~1.3s(Table 3)。
- 比单模型平均高 +9.6 ~ +11.9%(三种 Sharer,Table 4)。
- 比 T2T 平均高 +3.1 ~ +5.4%,且 2.5× 平均加速(最高 14.4×,当 Sharer 是只会生成冗长文本的 base 模型时)。
- 惊人案例:Qwen3-4B-Base 单独几乎 0% 准确率(不会 follow instruction),作为 Sharer 却能把 Receiver 抬到 43.95% —— C2C 能榨取"自己没用"的模型的知识。
- 训练极廉价:~300 步 / <9 GPU·小时 即达到接近最终 checkpoint 的精度(Table 12)。
- 量纲/残差相容:$F_n$ 的输出必须与 $C_n(X)\in\mathbb{R}^{n\times d}$ 同形才能相加 → 投影模块把 Sharer cache 映回 Receiver 维度,检查通过。
- $G(n)$ 良定义:terminal 对齐从输出侧配对(末层↔末层、次末↔次末…直到浅模型首层),$G$ 在 $[1,N]$ 上唯一定义到较浅模型深度;无越界。
- 初始化退化为基线:若 $F_n\approx 0$,则 $\mathcal{C}^F = C_n(X)$,即退化成 Receiver-only —— 一个 sane 下界。与 Table 6 "Identical ≥ Single" 及门控行为一致。
- 门控边界:Gumbel-sigmoid 输出 $\in(0,1)$;温度 $\tau:1.0\to0.001$ 时趋于二值 $\{0,1\}$,极限行为正确(训练可微、推理硬开关)。
- oracle 切片长度:$|C^*(X)| = |X|$,与 Direct 的 cache 长度相同 → 确实隔离了"富化"与"长度"。与 Table 1 "Cache Len. = |X|" 行自洽。
- 解码开销:$\mathcal{C}^F(X)$ 与 $C(X)$ 同为 $n\times d$,注意力覆盖的 KV 位置数不变 → 解码 FLOPs 不增,只多一次性 90ms 融合。与 Table 3(C2C prefill = 20+90ms,decode 与 Receiver 同量级)自洽。
- 官方代码:https://github.com/thu-nics/C2C (论文 §0 公布)。
- Cache Transformation Oracle 的可复现核心(§A.3.2,L1 已抓取代码片段):投影器对 Sharer 的
past_key_values[-1]的 K、V 分别做k_projector / v_projector,再对torch.dstack([project_k, project_v])与 target 的同构张量算 MSE。这是验证"cache 可转换"的最小实现,与正式 fuser 的区别是它用 MSE 对齐表示而非 next-token 损失。 - Token 对齐的"最大覆盖"选择(§3.3.3 / A.1.2):跨 tokenizer 时,把 Receiver 每个 token 解码成字符串再用 Sharer tokenizer 重编码;遇到一对多,选字符串覆盖最长的 Sharer token(而非 first-occurrence)以保留最多表面语义。模板段则用
- Terminal(末端)层对齐(§3.3.3 / A.1.1):从输出侧往回配对(末层↔末层…),优先对齐承载高层语义的深层,而非 depth-normalized 均匀映射;论文选它因为"更简单、更直接、实证略好"。复现时若默认写成按比例映射,会偏离论文配置。
- 超参:LR $1\times10^{-4}$ 线性调度 + 10% warmup;weight decay 0.01;max grad norm 1;seed 42;温度退火 1.0→0.001 线性;99%/1% train/val。
- 成本:主实验全程 ~5.6–6.8 墙钟小时 / ~45–54 GPU·小时(单位 L1 Table 12);但 300 步 / <9 GPU·小时即达接近最终精度,训练损失 ~250 步收敛。
- 数据分析:训练集为通用 SFT 数据 OpenHermes-2.5(无领域配比披露);oracle 的 few-shot 示例从 MMLU 选取并排除 MMLU-Redux 重叠(做了污染检查)。
- 代码开源(thu-nics/C2C);最接近的前驱是 DroidSpeak(跨"同基座微调"模型的 cache 共享),C2C 把适用范围扩到跨模型族、跨尺寸、跨 tokenizer。
- 截至成稿(ICLR 2026),社区独立复现报告尚无(L1 未记录),上游代码为唯一参考实现。
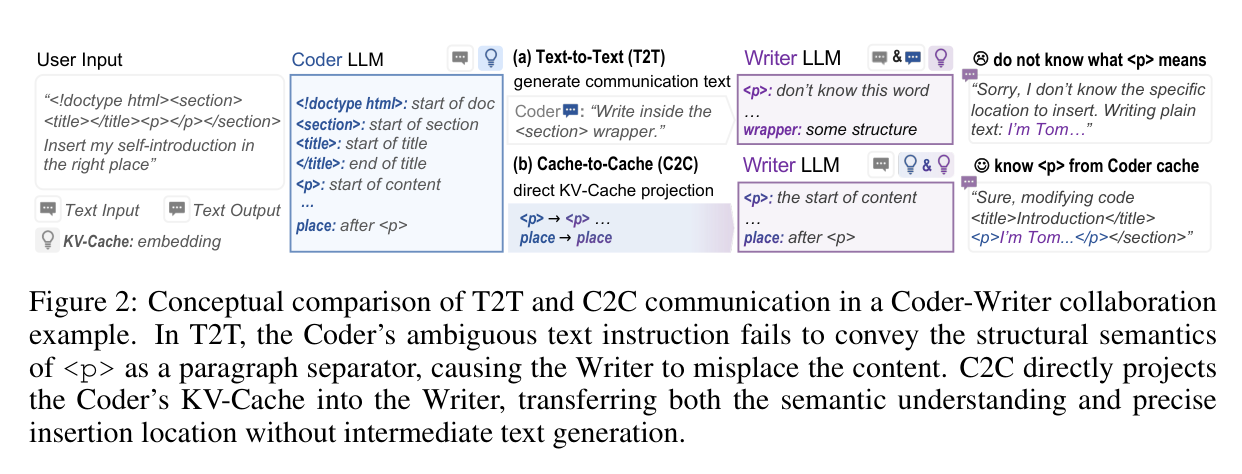
论文 Figure 2:在 T2T 下 Coder 用一句模糊指令"Write inside the wrapper"无法传达 作为段落分隔的结构语义,Writer 放错内容;C2C 把 Coder 的 KV-Cache 直接投影进 Writer,同时传递"语义理解"与"精确插入位置"。这张图把抽象的"信息瓶颈"落到一个可感知的失败案例上。
Q2 · 方法(C2C 做了什么) #
把 KV-Cache 本身当作通信介质。Sharer 与 Receiver 各自 prefill 同一上下文,产生各自的 KV-Cache;一个 Cache Fuser 把 Sharer 的 cache 投影到 Receiver 空间并与之融合,以残差方式加回 Receiver 的 cache;Receiver 用融合后的 cache 解码回复。整个通信是全并行的一次投影,不需要串行解码。
核心技术壁垒:跨模型族、跨尺寸、跨 tokenizer 地把一个模型的 KV-Cache 注入另一个模型而不破坏后者原有语义——关键不在"投影"而在"残差融合 + 逐层可学习门控"。消融显示:直接用投影后的 Sharer cache 替换 Receiver cache(无残差)准确率坍塌到 ~20%(低于 4 选 1 随机的 25%);加上残差立刻 +24.18%(Table 8)。这条"永远加修正、绝不覆盖"的约束,加上 Gumbel-sigmoid 门控在训练末期退火成二值开关逐层决定是否注入,是最难复制、也最 load-bearing 的设计。详见 §7。
Q3 · 结果 #
3. 架构 / 方法图 #
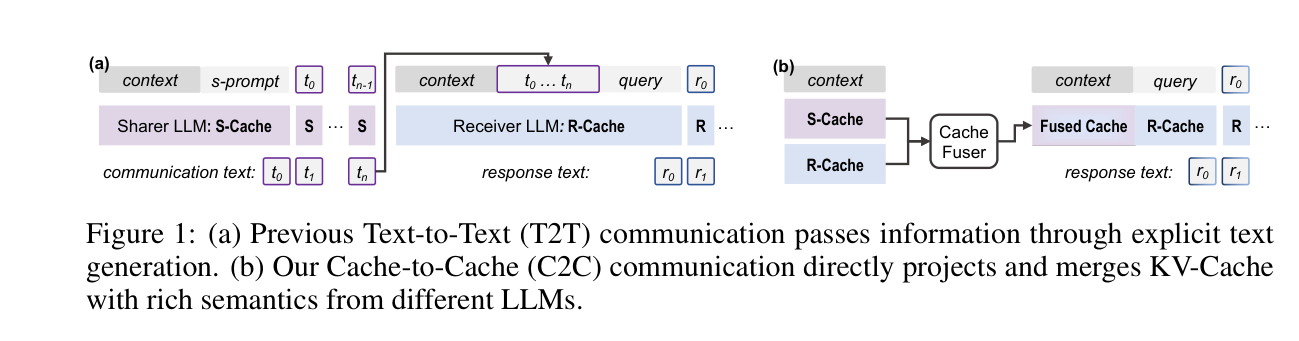
论文 Figure 1:(a) T2T 把信息经由显式文本生成传递(Sharer 生成通信文本 t₀…tₙ 喂给 Receiver);(b) C2C 中 Sharer 与 Receiver 都 prefill 上下文,Cache Fuser 把 S-Cache 与 R-Cache 投影合并成 Fused Cache,Receiver 直接从融合 cache 解码。右图是整篇论文的范式转变:通信边从"token 串"变成"KV 张量"。
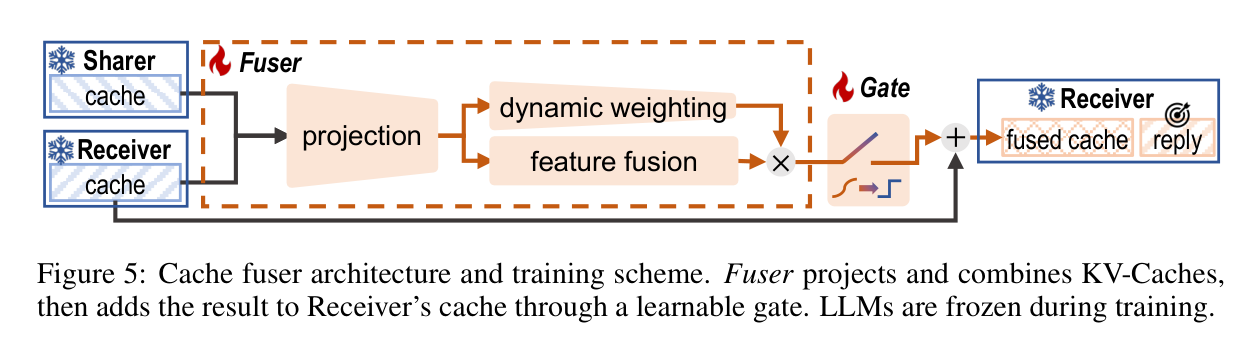
论文 Figure 5:Fuser 投影并融合两份 KV-Cache,再经一个可学习门控把结果加到 Receiver 的 cache 上;训练时 LLM 全部冻结。三个模块自上而下为 (1) 投影模块(拼接 R/S cache → 投影层 → 特征融合层)、(2) 动态加权模块(input-aware head modulation,逐头重加权)、(3) 逐层可学习门控(Gumbel-sigmoid,温度从 1.0 退火到 0.001,推理时变二值开关)。注意门控输出是"加"到 Receiver cache 而非"替换"——这正是残差设计的图示。
数据流(Mermaid,补充 Figure 5 的时序结构):
4. 作者证明 #
无形式化作者证明 — 仅实证。 本文无收敛定理 / 样本复杂度界 / PAC 式保证;全部结论由 oracle 实验与基准测试支撑。但方法由若干 load-bearing 方程定义,下面给出符号表、物理意义与 6 项一致性(量纲 / 边界)检查。若要补"理想中应有的保证",最缺的是:在何种 Sharer–Receiver 表示相容性假设下,融合后 Receiver 的预测损失不会被劣质 Sharer 抬高(即对 §5 列出的"弱 Sharer 污染强 Receiver"失败模式给出可证明的充分条件)。
符号表 #
| 符号 | 含义 |
|---|---|
| $X_{[0:n]}$ | 长度为 $n$ 的输入 token 序列 |
| $c_i,\; d$ | token $i$ 的 KV 状态;$d$ = 所有层 flatten 后的 KV 维度 |
| $C(\cdot)\in\mathbb{R}^{n\times d}$ | prefill 后逐 token 的 KV-Cache |
| $\oplus$ | 序列维拼接 |
| $N,\; n$ | Receiver 层数;当前层 index |
| $G(n)$ | 层映射:Receiver 第 $n$ 层 → Sharer 层 index(terminal 对齐) |
| $F_n$ | 第 $n$ 层的 fuser(投影+融合+动态加权+门控) |
| $C^S_{G(n)}$ | Sharer 在映射层的 cache(上标 $S$) |
| $\mathcal{C}^F$ | 融合后的上下文 cache,替换 $C(X)$ |
| $E$ | oracle 实验中的 few-shot 示例段 |
载重方程与物理意义 #
(1) 融合 cache(残差整合):
$$\mathcal{C}^F = \left\{\, C_n(X) + F_n\!\left(C_n(X),\, C^S_{G(n)}(X)\right) \right\}_{n=1}^{N}$$
物理意义:融合 cache = Receiver 自身 cache 加 fuser 产生的修正项;残差保证原 cache 不被破坏性覆盖。
(2) 融合后解码:
$$y_{i+1} = P\!\left(y_i \mid \mathcal{C}^F(X) \oplus C(Y_{[0:i]})\right)$$
物理意义:Receiver 以"含双方语义"的融合 cache 作为上下文解码,生成端 cache 仍是自己的。
(3) Enrichment oracle 切片:
$$C^*(X) = C_{[|E|:|E|+|X|]}(E \oplus X)$$
物理意义:对 $E\oplus X$ 做 prefill,但丢弃 exemplar 段,只保留 question 对齐的 KV 切片——问题 token 在 prefill 时已被 exemplar 语义"浸染",却不增加解码时可见的 cache 长度,从而把"语义富化"与"看更多 token"解耦。
(4) 训练损失(SFT 式 next-token,仅更新 fuser):
$$\mathcal{L} = -\sum_i \log P\!\left(y_i \mid \mathcal{C}^F(X) \oplus C(Y_{[0:i]})\right)$$
6 项一致性检查 #
5. 实验与数据 #
主结果(Table 4) #
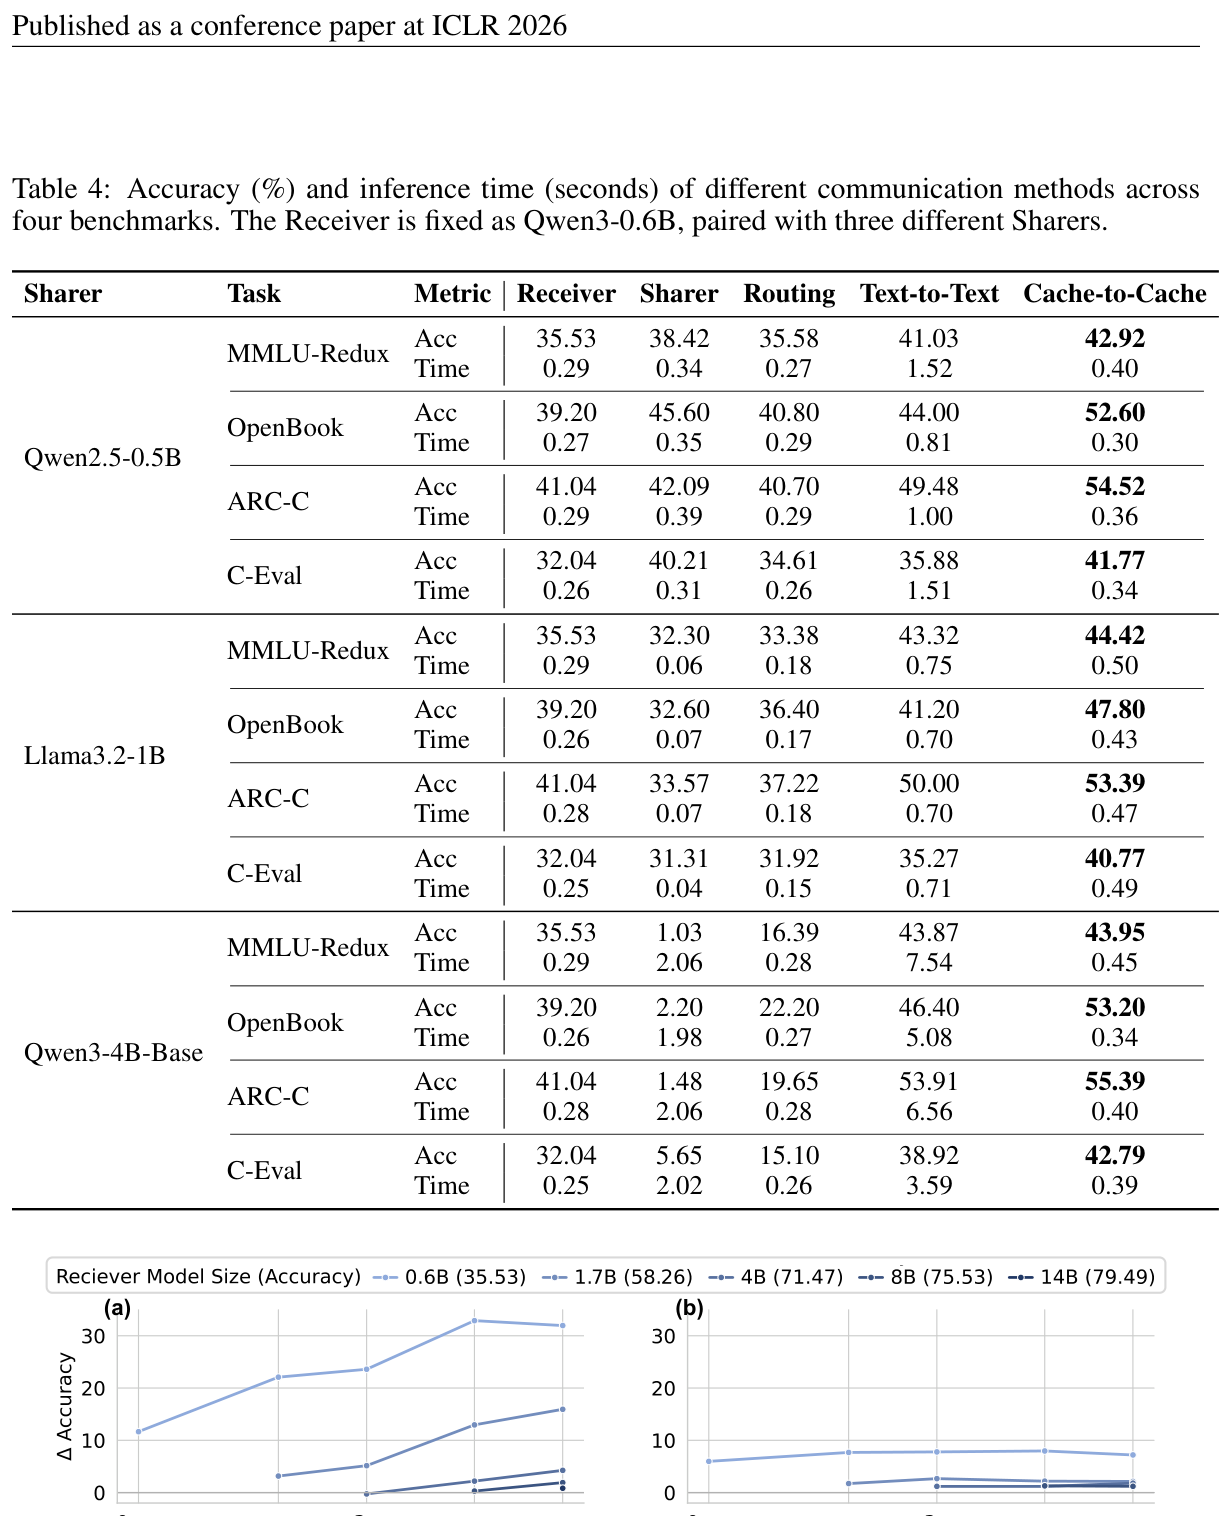
论文 Table 4(Receiver 固定 Qwen3-0.6B):C2C 在 3×Sharer × 4 基准 的全部 12 格都是最高准确率(加粗列)。看三点:(1) C2C 一致 > T2T(如 OpenBook Qwen2.5-0.5B Sharer:52.60 vs 44.00);(2) C2C 时间接近 Receiver-only(0.30–0.50s),而 T2T 因串行解码常 >1.5s;(3) Qwen3-4B-Base 行 Sharer 单独仅 1–5% 却把 C2C 抬到 43–55%。
t-SNE:KV-Cache 跨模型可转换(Figure 3) #
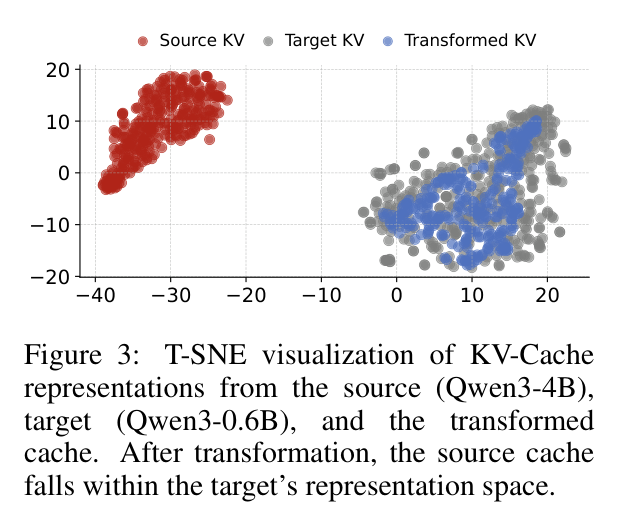
论文 Figure 3:Source(Qwen3-4B)、Target(Qwen3-0.6B)、以及经 3 层 MLP 转换后的 cache。原始双方表示相距甚远,转换后 source cache 落入 target 空间内——但只占 target 空间的一个子集,暗示大模型语义无法完全覆盖小模型(二者编码方式有内在差异,为"互补"提供依据)。这是 C2C 设计的前置可行性验证。
规模化:C2C 增益随 Sharer 容量上升更快(Figure 6) #
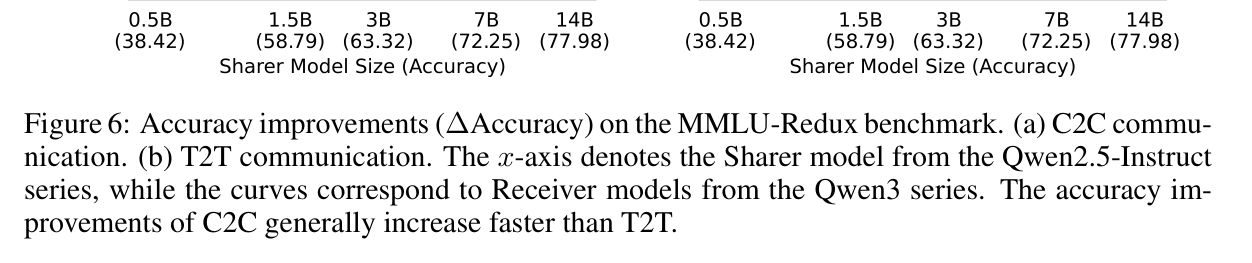
论文 Figure 6:x 轴为 Sharer 规模(Qwen2.5-Instruct 系列),曲线为不同 Receiver(Qwen3 系列)。(a) C2C 的 ∆Accuracy 曲线斜率普遍比 (b) T2T 更陡 —— Sharer 越强,C2C 从中榨取的增益增长越快;较大 Receiver 相对增益变小(基线更强、与 Sharer 知识重叠更高)。
消融一:增益来自互补 Sharer,而非新增可训练容量(Table 6) #
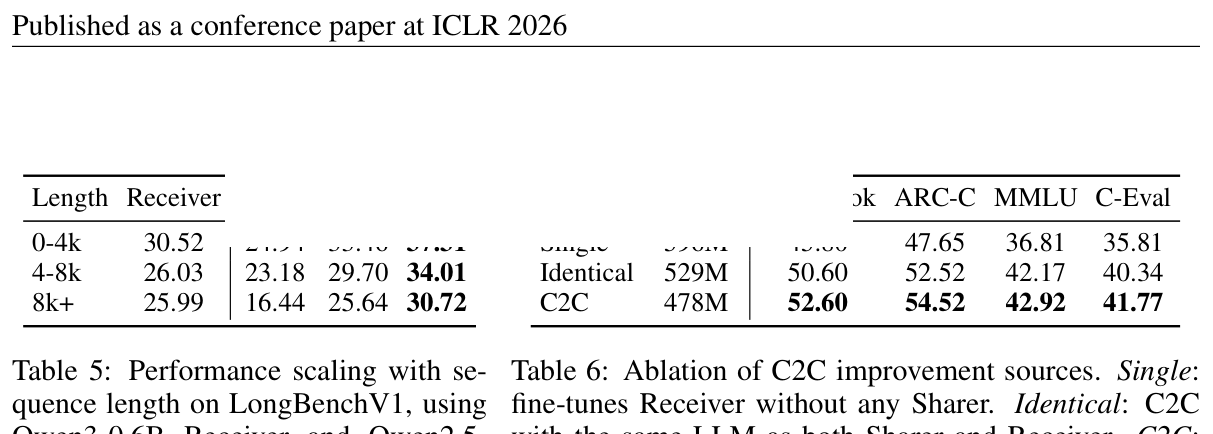
论文 Table 6:Single(全量微调 Receiver,596M)< Identical(Sharer=Receiver 同模型,529M)< C2C(异构 Qwen2.5-0.5B Sharer,478M)。关键在于 C2C 参数最少却最高——增益不是"多训了参数",而是"引入了互补的异构语义"。Identical 仍 > Single,说明 cache 级自通信本身也有益(呼应 looped transformer / latent reasoning)。
消融二:残差是命门,门控是加分项(Table 8) #
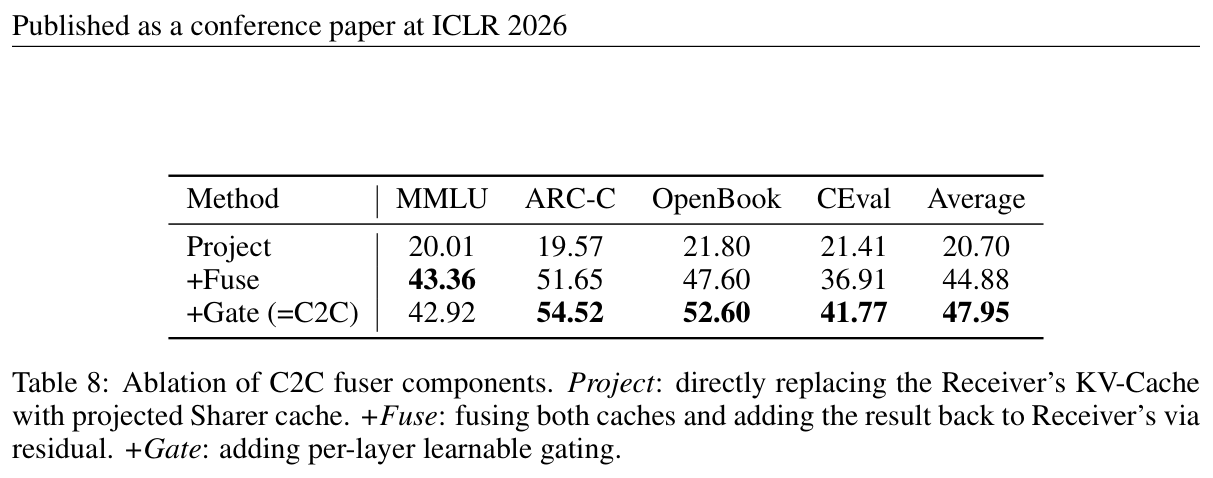
论文 Table 8:Project(直接用投影 Sharer cache 替换)平均仅 20.70%,低于随机;+Fuse(残差融合)跳到 44.88%(+24.18%);+Gate(逐层门控)再 +3.07% 到 47.95%。这张表单独证明了 Q2 中标注的核心壁垒——没有残差,跨模型 cache 注入是灾难性的。
其它关键数据(L1 内表,未逐一贴图):Table 2 有效秩(K:388→395, V:532→560,证明 Receiver 语义空间被真实富化但未被完全替换);Table 5 长序列(0–8k+ 各区间 C2C 均 > T2T);Table 7 异构/角色互换(互换时 T2T −6.30% 而 C2C +5.05%);Table 15 Agentic:T-C2C(T2T 解释 + C2C 融合)在 GSM8K 达 78.01%,超单独 C2C(62.55%) 与 T2T(61.18%) 各约 +16%。
6. 论证链 #
| 步 | 论点 | 依据(paper-internal) |
|---|---|---|
| 1 | KV-Cache 在不增加长度的前提下可被语义富化并提升准确率 | §3.2.1 Oracle 62.34% vs Direct 58.42%(Table 1);且富化是逐层异选的(Table 10 仅层 4/16 受益) |
| 2 | 一个模型的 KV-Cache 可被投影进另一个模型的表示空间 | §3.2.2 t-SNE(Figure 3):转换后 source cache 落入 target 空间 |
| 3 | 不同 LLM 对同一输入有互补的正确集 | §3.2.2 Figure 7 Venn:正确答案集重叠有限,聚合精度相当 |
| 4 | 故:把 Sharer cache 以残差融入 Receiver,可同时保留自身并吸收互补语义 | §3.3.1 Eq(1) 残差设计;§4.4 Table 8 残差使精度从 20%→45% |
| 5 | 逐层门控进一步筛选"值得注入"的层(由步 1 的层异质性驱动) | §3.3.2 Gumbel-sigmoid 门控;Table 8 +Gate +3.07% |
| 6 | 结果:冻结双模型、仅训融合器即可全面超越 T2T,且因免除串行解码而更快 | §4.2 Table 4 全 12 格最优 + 时间列;§4.4 Table 6 C2C(478M) > Identical > Single |
7. 实现 cross-reference #
核心技术壁垒(最难复制的一点) #
残差约束 + 退火二值门控下的跨架构 cache 注入。 复制者最容易踩的坑是"既然要传 Sharer 的语义,就用 Sharer 的 cache 替换 Receiver 对应层"——Table 8 的 Project 行证明这会把精度打到随机以下(~20%)。正确做法有三层硬约束缺一不可:(1) 永远残差,融合输出是加到 Receiver cache 上的修正项,初始化近 0 时安全退化为 Receiver-only;(2) 逐层 Gumbel-sigmoid 门控,训练用温度 1.0→0.001 退火把软门变成推理期硬开关,让模型自己学"哪些层该注入"(由 §3.2.1 发现的层异质性驱动——28 层里可能只有少数几层真正受益);(3) 门控之外还有 input-aware 动态加权,在通用训练下门几乎全开(>98.21%)、由动态权重承担调制,在任务特定训练下门变稀疏(52.67%)——两种 regime 的存在说明单靠门控不够。谁省掉其中任何一层,跨模型融合都会退化或坍塌。
关键实现细节(易漏的 1–2 个 trick) #
训练配方与规模(§A.3.5,algorithm 类必列) #
| 配置 | 数据 | max seq | 样本 | epoch | macro-batch | 步数 |
|---|---|---|---|---|---|---|
| 主性能实验 | OpenHermes-2.5 | 2048 | 500k | 1 | 256 | 1929 |
| 长序列规模化 | LongBenchV1 | 12000 | 1896 | 1 | 16 | 118 |
| 模型尺寸/组合 | MMLU aux-train | 1024 | 15000 | 1 | 128 | 116 |