A Real-Time Digital Twin for Adaptive Scheduling (SchedTwin)
SchedTwin:把离散事件模拟器接进生产调度器的反馈回路 #
1. TL;DR #
SchedTwin 把 CQSim 变成生产 PBS 调度器的在线数字孪生:每次 submit/end 事件到达就同步虚拟事件队列,并行跑 k 个候选策略的 what-if 全排空模拟,按管理员配置的 Score 取 argmax,再用 qrun 把选中策略的即刻 run 事件推回物理系统。合成 150 作业 trace 上雷达面积 1.86 vs WFP 1.67(+11.4%)。
2. Q1 / Q2 / Q3 #
Q1 痛点:静态启发式 + 一步决策,遇到相变型负载就失配 #
论文的痛点不是"调度器慢",而是调度策略在整个运行期内被钉死。§1 的三段式论证:HPC 作业规模与运行时长跨数个量级(Fig 1 的 Polaris trace);生产环境部署的是 FCFS+EASY backfilling 或 ALCF 那类 utility-based(WFP)策略,它们"inherently static and cannot adapt to evolving workload characteristics or system state";且它们的决策是 one-step 的——只看当前队头,"provide no guarantees of near-optimal performance"。
第三块缺口来自数字孪生一侧:ExaDigiT 一线的 DT 已经能把资源分配、供电、冷却、可视化整合进 in-silico 模型,但用途是 offline planning(回溯分析、容量规划、设计期评估),"rather than providing real-time feedback for dynamic operational control"。所以缺的不是模拟器,而是把模拟器接进活的控制回路。
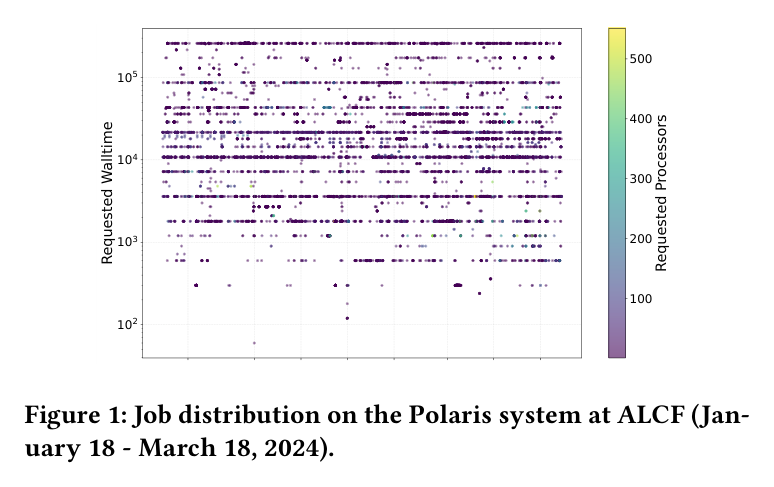
Paper's Figure 1, verbatim(caption: "Job distribution on the Polaris system at ALCF (January 18 - March 18, 2024).")。
这张图是全文唯一的真实系统证据。要注意两点:一是纵轴 walltime 从 $10^2$ 到 $10^5$ 秒横跨三个数量级,且呈明显的水平条带(用户只填整数 walltime),二是色标显示绝大多数作业落在低处理器数区间、大规模作业稀疏。这两个特征正是后文合成 trace 想模仿的对象——大而长的作业偶发出现并阻塞后续小作业。讽刺的是,这张真实 trace 只用于 motivate,§4 的评测完全没有用它。
Q2 方法:事件流 → 状态对账 → k 路并行 what-if → argmax → qrun #
SchedTwin 是一个旁挂(alongside)的孪生进程,不改调度器内核。一个调度周期的七步:
- ❶ 物理调度器发生 submit / run / end 事件;
- ❷ PBS hook(
queuejob/runjob/jobobit)把元数据 publish 到 Redis stream; - ❸ 孪生订阅该 stream 读入事件;
- ❹ 同步块:先用命令行工具刷新节点可用性,再按事件类型分支(❹A 拉回/推前预测 end 事件,❹B 插入预测 end 事件);
- ❺ fork k 份共享同一数据库的 simulator 对象,每份绑一个候选策略,各自跑到队列排空,并行执行;
- ❻ 把 k 个终态 simulator 交给 $Score(\cdot)$,取 argmax;❻A 只抽取选中策略时间线上"紧随当前时刻"的 run 事件;
- ❼ 用
qrun在物理系统上启动这批作业。 - 量纲一致性 — 不通过。 Score 把 wait time(秒)与 slowdown(无量纲比值)直接以 0.25 等权相加。除非二者先各自归一化,这个和式量纲不齐;论文没有给出归一化定义。Fig 3 的轴标签写成 "1/Avg. Wait" 说明作图时确实做了倒数与归一,但正文的 Score 表达式与作图口径之间缺一步。
- 方向性 — 不通过。 §3.4 取 argmax(越大越好),而 Score 是等待时间与 slowdown 的正加权和(越小越好)。二者符号方向相反,论文从未说明是取负、取倒数还是取补。这不是排版疏漏,而是让"Score 定义"与"选择规则"无法直接对接的实质缺口。
- 边界情形 $k=1$ — 通过(退化正确)。 策略池只有一个策略时 argmax 恒选它,SchedTwin 退化为该静态策略加一层无用模拟开销。行为定义良好,与 §3 preamble 的"需要策略互补"前提自洽。
- 单调性 / 最优性 — 不通过(未讨论)。 逐周期贪心地对终态 Score 取 argmax,不保证任何全局目标的单调改善:每个周期用不同策略拼出的排程序列,未必优于全程使用其中任一策略。这正是 §1 批判静态策略"one-step decision-making"时提出的标准,而 SchedTwin 自身是"one-step over policies"——rollout 到排空只是用来打分,commit 仍然只有一步。论文没有反例、也没有单调性论证。
- 首阶数值代入 — 可复算的部分通过。 11.4% 这个数:$1.86 / 1.67 = 1.1138$,即 +11.4% 确实等于 Fig 3 两个雷达面积之比,不是从别处 fit 来的。Table 1 三格 $35.19 + 15.66 + 49.15 = 100.00\%$ 也自洽。但雷达面积本身如何从 maxWT/avgWT/maxSD/avgSD/util 五个原始量算出(归一化上下界是什么),无法从论文复现——FCFS 面积恰为 0.00 就是这个不透明归一化的直接后果:面积为零意味着 FCFS 在足够多条轴上被压到内边界,论文对这个退化值未置一词。
- 开销界的前提检查 — 部分不成立。 $\max_i$ 界成立需要 k 路模拟真并行。评测环境是单台 48 核主机上跑 33 个容器加孪生进程,k=3 时核数够;但当 k 增大或每次 rollout 都要跑到队列排空(作业数随规模增长)时,$\max_i$ 会随负载而非随 k 增长,而这条曲线全文没有测过。"a few seconds per scheduling cycle"没有任何测量支撑。
选择规则本身是纯 argmax,没有混合、没有偏序:$P^{\ast} = \operatorname*{argmax}_{i \in \{1,\dots,k\}} Score(P_i)$。每个调度周期恰好由一个策略独占。
核心技术壁垒不在 argmax(那是三行代码),而在 ❹ 这个双向状态对账层:要让一个高保真 DES 的事件队列与一个正在服务真实用户的 PBS 实例保持一致,必须同时处理三件互相冲突的事——(a) 虚拟未来只能包含 end 事件(submit 不可预测,run 只有物理系统真跑了才能插入),(b) 用户填的 walltime 系统性高估,所以预测 end 时间必须在真实 end 事件到来时被拉回,偶发的清理延迟又要求能推前,(c) run 事件必须立即退出而不触发重规划。这三条约束共同定义了一个"虚拟时间轴只允许被物理事件单向校正"的不变量。任何想复刻这套系统的人,真正要写对的是这个不变量,而不是策略池。
Q3 结果:合成 trace 上雷达面积 1.86,比次优 WFP 高 11.4% #
单一实验:32 节点 PBS 集群(33 个 Docker 容器跑在一台 48 核 AMD x86 CloudLab 节点上),150 作业四阶段合成 trace,到达率 5 s/job。策略池 $k=3$(FCFS、WFP、SJF),Score 为四项等权 0.25 的 maxWT/maxSD/avgWT/avgSD 加权和。Kiviat 面积:FCFS 0.00、SJF 0.31、WFP 1.67、SchedTwin 1.86。策略选择分布(tie-break 后)WFP 35.19% / FCFS 15.66% / SJF 49.15%。实现约 1,000 行代码,扩展 CQSim。
开销方面,论文只给出设计层面的界("overhead never exceeds the runtime of the longest running simulation")和摘要里的"a few seconds per scheduling cycle",全文没有任何计时表格或测量数字。
3. 架构 / 方法图 #
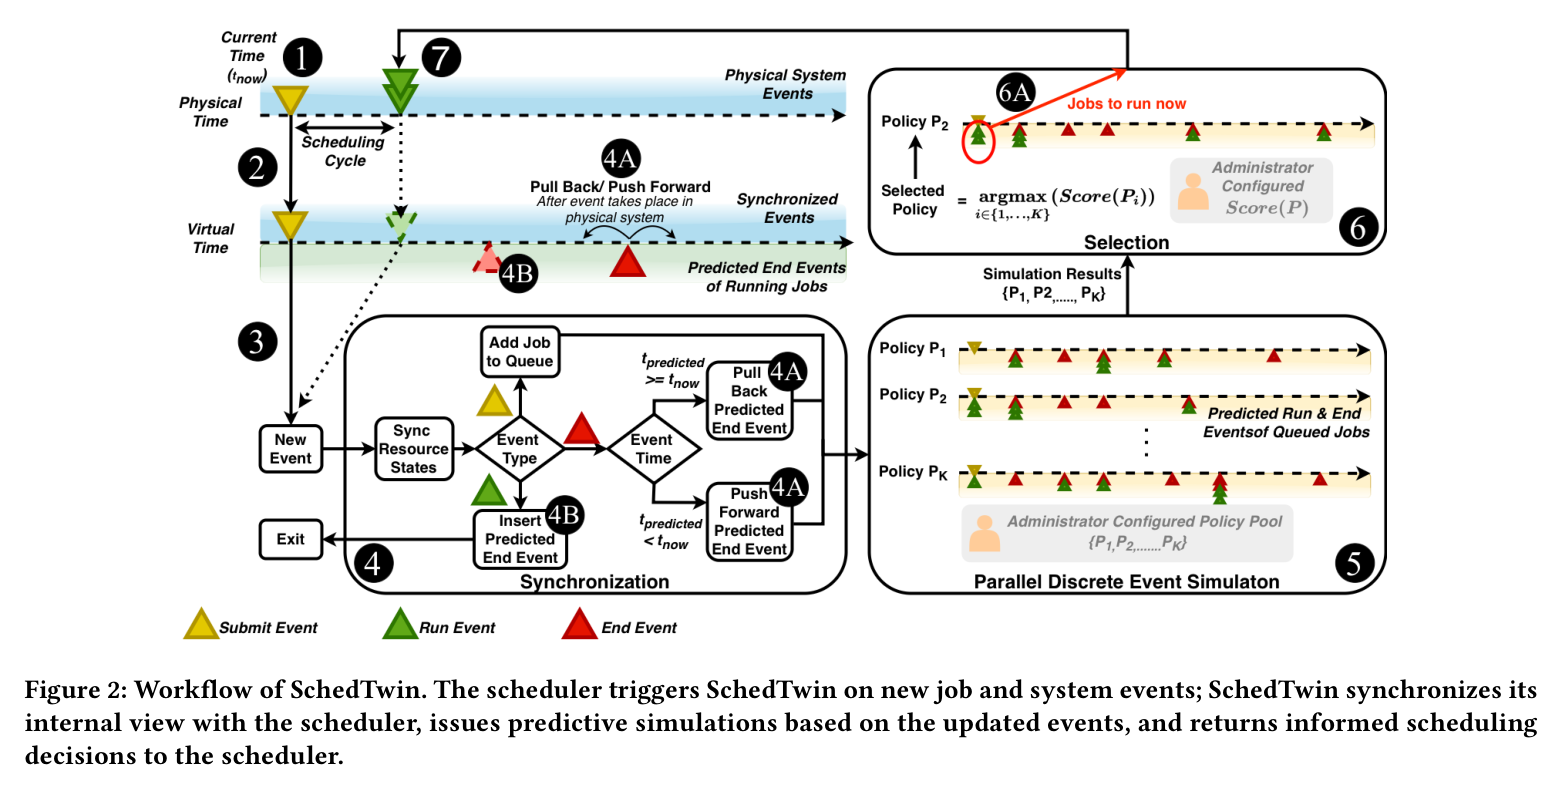
Paper's Figure 2, verbatim(caption: "Workflow of SchedTwin. The scheduler triggers SchedTwin on new job and system events; SchedTwin synchronizes its internal view with the scheduler, issues predictive simulations based on the updated events, and returns informed scheduling decisions to the scheduler.")。
读这张图要抓三处结构信息。第一,两条时间轴:上面 Physical Time 标 "Physical System Events",下面 Virtual Time 标 "Synchronized Events",两轴之间只有 ❷(下行,事件同步)和 ❼(上行,qrun 决策)两条通路——这就是"不修改调度器内核"的图形化表达。第二,Virtual Time 轴当前时刻右侧的阴影带标注为 "Predicted End Events of Running Jobs",即虚拟未来的唯一居民是运行中作业的预测结束事件。第三,❺ 块里 $P_1 \dots P_K$ 各占一条独立时间线,标注 "Predicted Run & End Events of Queued Jobs",说明 k 路 rollout 是完全隔离的,没有共享状态推进。
原图是复合示意图,时序因果(谁触发谁、哪一步会提前退出)需要靠圈号 ❶–❼ 逆推。下面这张 sequence diagram 补上原图不便表达的控制流与退出路径:
系统边界(framework scope) #
| 维度 | SchedTwin 的取值 | 依据 |
|---|---|---|
| 调度对象 | HPC 批作业,bare-metal 独占整节点(非容器/非 LLM 请求) | §2.1 |
| 阶段覆盖 | 作业准入/派发决策;不涉及作业内执行、不涉及 preemption | §3.4、§3.5 |
| 批处理模式 | 事件驱动的调度实例(submit 或 end 触发),非固定周期轮询 | §3.2 |
| 并行维度 | 唯一的并行轴是 k 路策略 what-if;无 TP/PP/EP 类比 | §3.3 |
| 部署形态 | 单机旁挂进程 + Redis + PBS hook;评测为单节点 33 容器伪集群 | §3.1、§4.1 |
| 通信路径 | Redis in-memory stream(下行)+ PBS CLI qrun(上行);无 collective | §3.1、§3.5 |
| 侵入性 | 零内核改动,"without modifying the core scheduler logic" | §3.5 |
调度与资源管理 #
调度决策的粒度是作业(不是 token/层/算子):❻A 只提交"紧随当前时刻"的 run 事件,其余 rollout 结果全部丢弃,下个事件重新规划。这是一个 receding-horizon 结构——rollout 视野无界(跑到队列排空),但 commit 视野只有一步。
抢占策略:没有。已经 qrun 出去的作业不可撤回,孪生的重规划只作用于仍在等待队列里的作业。准入控制:无丢弃、无过载保护;等待队列无界。公平性:无 per-tenant / per-priority 保证,公平性只能通过 $Score$ 里的 maxWT/maxSD 项间接体现——这也是等权 0.25 设计的实际作用(压尾部)。
资源管理侧:分配单元是整节点(exclusive access),因此不存在 KV cache 那类分页/碎片问题;节点可用性由 ❹ 每次事件用命令行工具重新拉取。状态复用方面,§3.3 明确 k 份 simulator 拷贝 "share a common database and only carry event metadata",这是把 fork 成本压下来的关键手段——共享只读作业库,只复制事件元数据。无换出、无淘汰机制。
4. 作者证明 #
无形式化作者证明 — 仅实证。
全文没有吞吐/延迟/成本模型,没有排队论分析,没有最优性或收敛性论证。§3 是纯架构叙述,全部形式化内容只有三处:Fig 2 的 argmax、§3.3 的策略池成员关系、§4.1 的 Score 定义。下面先把这三处的记号与物理含义整理清楚,再对可检查的部分做最小检查。
记号表 #
| 符号 | 定义(论文原文口径) | 出处 |
|---|---|---|
| $P_i$ | 策略池中第 $i$ 个候选策略 | §3.3、§3.4 |
| $k$ / $K$ | 策略池大小(正文用 $k$,Fig 2 用 $K$,同一量);§4 中 $k=3$ | §3.3、Fig 2 |
| $P^{\ast}$ | 本调度周期被选中的策略 | §3.4 |
| $Score(P_i)$ | 管理员配置的打分函数,作用在第 $i$ 个模拟的终态 | §3.4 |
| $\mathrm{maxWT}(p),\ \mathrm{avgWT}(p)$ | 策略 $p$ 下队列内所有等待作业的最大 / 平均等待时间 | §4.1 |
| $\mathrm{maxSD}(p),\ \mathrm{avgSD}(p)$ | 策略 $p$ 下的最大 / 平均 slowdown | §4.1 |
| $t_{now}$ | 物理系统当前时刻 | Fig 2 |
| $t_{predicted}$ | 运行中作业按用户估计 walltime 推出的预测结束时刻 | Fig 2 ❹A |
方程与物理意义 #
选择规则:$P^{\ast} = \operatorname*{argmax}_{i \in \{1,\dots,k\}} Score(P_i)$
为什么是 argmax 而非加权融合?因为策略是离散且互斥的调度规则,无法在"半个 FCFS + 半个 SJF"上定义一个合法的作业顺序;一个周期只能由一个策略生成排程。为什么 $Score$ 作用在终态而非路径积分?因为 rollout 跑到队列排空,终态已经吸收了整条路径上的等待时间统计——maxWT/avgWT 本身就是路径量的聚合。
评测目标函数:$Score(p) = 0.25\,\mathrm{maxWT}(p) + 0.25\,\mathrm{maxSD}(p) + 0.25\,\mathrm{avgWT}(p) + 0.25\,\mathrm{avgSD}(p)$
四项等权的物理含义是尾部与均值各占一半:$\{\mathrm{maxWT}, \mathrm{maxSD}\}$ 合计权重 0.5 压尾,$\{\mathrm{avgWT}, \mathrm{avgSD}\}$ 合计 0.5 压均值。这正是 §4.2 用来解释"为什么不直接一直用 SJF"的机制——SJF 能把 avg 项压得和 SchedTwin 相当,但会把 maxWT 顶起来,在等权目标下被扣分。同时注意分母侧的缺口:目标函数里没有 utilization 项,而 utilization 是 Fig 3 五条轴之一,SchedTwin 在这条轴上的领先并不是它在优化的东西。
开销界:$\text{overhead} = \max_i(\text{sim time of } P_i)$ 而非 $\sum_i$
这是"low overhead"唯一的论证。$\max$ 取代 $\sum$ 的前提是 k 路模拟真正并行且互不依赖(§3.3 明确 "run in parallel independent of each other"),以及 fork 成本可忽略(共享数据库)。
6 项最小检查 #
若有模型本可澄清什么 #
一个即使很粗的排队模型也能回答三个现在悬空的问题:(a) 在什么负载相变频率下"换策略"的收益才超过 rollout 开销——如果负载相变周期远长于调度周期,静态策略加一次人工重配就够了;(b) receding-horizon(无界 rollout / 一步 commit)与全排程 commit 之间的性能差有多大,即"只用队头"损失了多少 rollout 的信息;(c) $Score$ 的权重取值与最终 Kiviat 面积之间的敏感度——现在 0.25×4 是给定的,没有任何扫描说明结论对权重稳健。
5. 实验与数据 #
配置 #
单一实验点:32 节点 PBS 集群,由 33 个 Docker 容器(32 个 worker daemon + 1 个 admin/scheduler daemon)跑在一台 48 核 AMD x86 CloudLab 节点上。工作负载是合成四阶段 trace,共 150 作业,到达率 5 s/job:
| 阶段 | 描述 | 作业数 | 节点/作业 | walltime/作业 |
|---|---|---|---|---|
| 1 | warm-up 小作业 | 25 | 2–4 | 60–180 s |
| 2 | 大而长作业突发 | 35 | 16–20 | 500–700 s |
| 3 | steady 阶段 | 40 | 6–8 | 200–300 s |
| 4 | 短作业尾部 | 50 | 2–4 | 60–180 s |
阶段 2 的 16–20 节点作业在 32 节点系统上一次只能并跑一个多一点,因此必然阻塞阶段 3/4 的小作业——§4.2 自述这个 trace 是 "intentionally designed" 成让 SJF 有效的形状。基线三个:FCFS+backfilling、WFP(ALCF 的 utility-based)、SJF(无引用)。指标:wait time、slowdown、system utilization,各取 avg 与 max。
基线公平性方面需要标注两点:三个基线都不是外部实现,而是同一个 CQSim 策略池里的成员,因此不存在版本/调参差异问题,这是本文实验设计相对干净的地方;但反面是它也意味着 SchedTwin 的上界被策略池锁死——它永远不可能优于池内最佳策略在每个周期上的逐点最优组合。
主结果 #
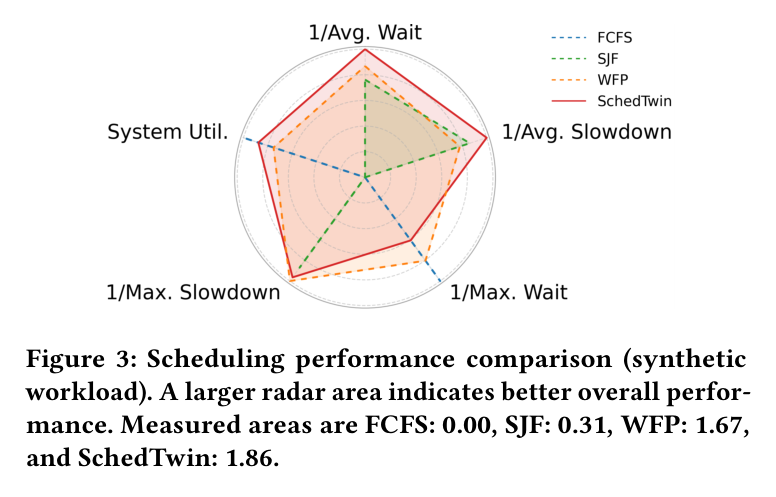
Paper's Figure 3, verbatim(caption: "Scheduling performance comparison (synthetic workload). A larger radar area indicates better overall performance. Measured areas are FCFS: 0.00, SJF: 0.31, WFP: 1.67, and SchedTwin: 1.86.")。
五条轴是 "1/Avg. Wait"、"1/Avg. Slowdown"、"1/Max. Wait"、"1/Max. Slowdown"、"System Util."——四条延迟轴取倒数使得"外扩=更好"。红色 SchedTwin 多边形在四条轴上最外或并列最外,这构成了 1.86 的面积。真正该注意的是它输在哪条轴:蓝色 FCFS 在 "1/Max. Wait" 上外扩最远,超过 SchedTwin——FCFS 按到达序执行,天然不会让任何作业无限等待,最大等待时间最优是它的结构性优势,而 SchedTwin 的等权目标为了换取均值收益放弃了这一点。同时绿色 SJF 在 "1/Avg. Wait" 与 "1/Avg. Slowdown" 上被论文自述为 "comparable to SchedTwin",即在均值指标上 SchedTwin 并没有拉开差距,1.86 vs 0.31 的巨大面积差主要来自 SJF 在 "System Util." 和 "1/Max. Wait" 上的塌缩。
策略选择归因 #
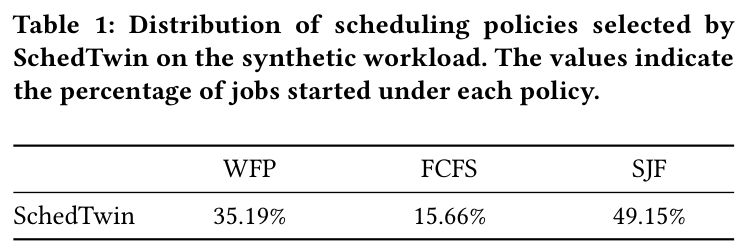
Paper's Table 1, verbatim(caption: "Distribution of scheduling policies selected by SchedTwin on the synthetic workload. The values indicate the percentage of jobs started under each policy.")。
WFP 35.19% / FCFS 15.66% / SJF 49.15%,三格合计 100.00%。这张表是全文最有信息量的一处,因为它同时支撑与限制了核心主张:SJF 占近半印证了 trace 被设计成 SJF 友好;而非 SJF 策略占 50.85% 则是"SchedTwin 没有退化成单一策略"的唯一证据。但这个证据被一条归因规则削弱——§4.2 明说打分相同的 tie 按 WFP → FCFS → SJF 的优先序判给前者,而论文没有报告 tie 周期占多少。如果 tie 比例很高,35.19% + 15.66% 这一半就可能主要是 tie-break 规则的产物而非自适应能力的体现。此外正文说 Table 1 报的是作业"数量"、caption 说是"百分比",实际是百分比。
负载区间画像:什么时候赢、什么时候输 #
论文只给了单一 trace 的聚合结论,下表按其机制推出各区间行为(依据均标注,非论文自述的部分明确标为推断):
| 负载区间 | SchedTwin | 最佳静态基线 | 为什么 |
|---|---|---|---|
| 均质小作业(阶段 1/4 单独) | 无增益,纯开销 | 三者近似等价 | 策略池"complementary strengths"前提失效,argmax 退化为 tie-break 优先序(推断,据 §3 preamble 前提 + §4.2 tie 规则) |
| 大长作业阻塞小作业(阶段 2→3/4 相变) | 赢 | SJF 均值好但尾部与 util 差 | 这是唯一被实测的区间;SchedTwin 在相变处切策略拿到 1.86 vs 1.67(§4.2 + Fig 3) |
| 严格要求最大等待时间有界 | 输 | FCFS | Fig 3 "1/Max. Wait" 轴 FCFS 外扩最远;等权目标里 maxWT 只占 0.25(Fig 3) |
| 高到达率 / 长队列 | 未测,机制上劣化 | 静态策略 O(1) 决策 | rollout 跑到队列排空,单周期开销随队列长度增长,而调度周期随到达率缩短(推断,据 §3.3 终止条件) |
| 物理调度器自行启动作业 | 未定义 | — | run 事件让孪生立即退出不重规划(§3.2),隐含假设作业只经 qrun 启动 |
指标定义口径需要点明:wait time 与 slowdown 都是"across all jobs waiting in the queue"聚合,不是 p50/p99 分位;utilization 未给出统计窗口定义;雷达面积的归一化区间未定义(这是 FCFS=0.00 的来源)。全文没有任何调度周期时延的实测数字,"a few seconds"是设计推断而非测量。
6. 论证链 #
| # | 步骤 | 论文内依据 | 该步产出 |
|---|---|---|---|
| 1 | HPC 负载在作业规模与运行时长上跨数量级变化 | §1 + Fig 1(Polaris 2024/01/18–03/18 trace) | 建立"负载非稳态"的事实前提 |
| 2 | 生产部署的策略是固定的启发式(FCFS+EASY、WFP),且只做一步决策 | §2.1 段 3 的策略定义 + [1][18] 等站点文档引用 | 建立"策略静态"的事实前提 |
| 3 | 由 1+2 推出:静态策略无法对非稳态负载给出近优性能 | §1 段 2 结论句(断言,本节未测量) | 得到问题陈述 |
| 4 | 已有数字孪生(ExaDigiT 线)是 log-driven、offline planning 导向 | §2.2 段 1 + [6][7][16] | 定位"实时在环孪生"为空缺 |
| 5 | DES 天然适配调度建模(事件即时、时间跳跃),且已有成熟实现 CQSim | §2.2 段 2 + §3.3(CQSim [24],[26] 佐证长期使用) | 选定预测引擎,把空缺变为可实现 |
| 6 | 在环孪生需要虚拟状态与物理状态对账:未来只能有 end 事件,用户 walltime 不准需拉回/推前,run 事件不构成调度机会 | §3.2 三分支决策树 + Fig 2 ❹A/❹B | 得到可运行的同步不变量 |
| 7 | 从对账后状态 fork k 份共享数据库的 simulator,各绑一策略并行跑到排空 | §3.3("share a common database"、"until no jobs are left") | 得到 k 个可比的终态 + 开销界 $\max_i$ |
| 8 | 对终态取管理员配置 Score 的 argmax,只 commit 紧随当前时刻的 run 事件 | §3.4 + Fig 2 ❻/❻A | 得到自适应决策,且保留每事件重规划能力 |
| 9 | 决策经 qrun 回灌,不改调度器内核 | §3.5 + §3.6(~1,000 LOC on OpenPBS [11]) | 得到可部署工件 |
| 10 | 在 32 节点 PBS + 150 作业四阶段合成 trace 上,SchedTwin 雷达面积 1.86 > WFP 1.67 | §4.1 配置 + §4.2 段 1 + Fig 3 caption | 支撑"优于池内静态策略" |
| 11 | Table 1 显示 SJF 被选 49.15%、非 SJF 合计 50.85%,说明未退化为单一策略 | §4.2 段 2–3 + Table 1(含 tie-break 归因说明) | 支撑"自适应性真实存在" |
| 12 | 由 10+11 推出:实时数字孪生是可行且有效的自适应调度路径 | §5 结论段 | 完成论证闭环 |
7. 实现 cross-reference #
[实现未公开] — 论文把"implementing SchedTwin as open-source software"列为三大贡献之二(§1 段 5),§3.6 也称已针对 OpenPBS 实现,但全文未给出 SchedTwin 自身的仓库 URL。唯一可定位的代码是被扩展的底层模拟器 CQSim(ref [24],github.com/SPEAR-UIC/CQSim),SchedTwin 相对它的约 1,000 行增量无法逐行核对。因此本节不提供 file:line 引用,只记录论文自述的实现坐标:
| 组件 | 论文给出的实现事实 | 出处 |
|---|---|---|
| 预测引擎 | 扩展 CQSim(trace-based DES scheduling simulator),增量 ~1,000 LOC | §3.3、§3.6、[24] |
| 事件生产者 | PBS hook 脚本,绑定 queuejob / runjob / jobobit 三个事件 | §3.1 |
| 传输 | 轻量内存 Redis stream,scheduler 为 producer,孪生为 consumer | §3.1 |
| 状态刷新 | 节点可用性经命令行工具查询(未指明具体命令) | §3.2 |
| 执行回路 | PBS qrun | §3.5 |
| 目标调度器 | OpenPBS [11] 开源版 | §3.6 |
| 测试床 | CloudLab [9] 单节点 48 核 AMD x86,33 个 Docker 容器 | §4.1 |
核心技术壁垒的实现面 #
复刻 SchedTwin 的难点集中在 §3.2 的同步块,而这恰好是代码不可见的部分。要写对它,实现者必须同时满足三条互相牵制的约束:
第一,虚拟未来的事件类型闭包。虚拟时间轴当前时刻之后只允许存在预测 end 事件——submit 无法预测,run 只有物理系统真的启动后才能插入(❹B)。这意味着孪生不能"预演"自己尚未 qrun 的作业的 run 事件到主事件队列里,否则虚拟状态会跑在物理状态之前,后续对账无法收敛。rollout 内部当然会产生 run 事件,但那些只活在 fork 出的副本里,不回写主队列。
第二,walltime 误差的双向校正。用户估计的 walltime 系统性高估,真实 end 事件通常早于 $t_{predicted}$,需要"拉回";反之调度器清理资源的延迟会让作业看起来晚结束,需要"推前"(论文称后者少见)。这里有一处值得警惕的不一致:Fig 2 画的分支谓词是 t_predicted >= t_now → Pull Back、t_predicted < t_now → Push Forward,而 §3.2 的散文表述是"结束得更早则拉回、更晚则推前"。按图的谓词读,$t_{predicted} \ge t_{now}$(预测结束时间还没到,而作业已经结束了)对应拉回——两种表述其实可以对上,但图上的不等式方向极易被反向实现,这是一个真实的踩坑点。
第三,run 事件的立即退出。§3.2 明确 run 事件插入预测 end 事件后立刻退出,"run events don't imply new scheduling opportunities"。这条优化背后有一个未言明的部署假设:物理调度器不会自作主张启动作业,所有启动都源自孪生的 qrun。若 PBS 自身的调度循环仍在活跃地派发作业,孪生就会漏掉由它触发的资源状态变化窗口。
关键实现细节(易被忽略) #
细节一:fork k 份 simulator 靠的是"共享只读库 + 只复制事件元数据"。 §3.3 特意说明 "This does not incur a large overhead as all objects share a common database and only carry event metadata required for simulation"。天真实现会深拷贝整个作业数据库 k 次,那样 fork 本身就吃掉了并行省下的时间,$\max_i$ 的开销界立刻失效。共享数据库是这个界能成立的前置条件,而不是一个可选优化。
细节二:rollout 到排空,但只 commit 队头。 §3.3 的终止条件是"run until no jobs are left in the queue"(无界视野),而 §3.4 只抽取"紧随当前时刻"的 run 事件(一步 commit)。这个不对称是有意的——长视野用来给策略打分,短 commit 用来保留下一个事件到来时改主意的权利。实现时容易犯的错是把选中策略的整条排程一次性提交,那样就丧失了自适应性,退化成"周期性重选策略的静态调度"。
细节三:tie-break 优先序是一条硬编码的策略偏好。 §4.2 段 2 说明打分相同时按 WFP → FCFS → SJF 判定,理由是"roughly reflects the relative popularity of these static policies in practice"。这条规则不在 §3 的机制描述里,却直接决定了 Table 1 的数字构成。任何复现者若采用不同的 tie-break(例如随机或保持上周期策略以减少抖动),会得到完全不同的策略分布表,尽管聚合性能可能一致。