Data-Driven Optimization of GPU efficiency for Distributed LLM–Adapter Serving
Data-Driven Optimization of GPU efficiency for Distributed LLM–Adapter Serving #
§1 TL;DR #
给定可预测的 LoRA 工作负载(adapter 数量/尺寸/到达率),用 Digital Twin 生成数据训练 ML 代理模型,再用 FFD 变体贪心算法求解 adapter→GPU 放置与每卡 A_max,把每张卡压到"不饿死的最大吞吐点" Max_pack。4 卡实测平均少用 2.4 张 GPU(60%),代价是 ITL 变差。
系统边界:单节点 4×H100,每 GPU 一个独立 vLLM 实例,请求按 adapter 归属路由。没有任何跨 GPU 集合通信——这是一个"把 GPU 当 bin 来装 adapter"的容量规划问题,不是 fabric 问题。
§2 Q1 / Q2 / Q3 #
Q1 — 痛点:Max_pack 是一个位置不定、越界即崩的悬崖 #
多租户 LoRA 服务把成百上千个 adapter 塞在同一个 backbone 上。单个 adapter 的到达率太低喂不饱 GPU,所以要"堆";但堆过头就越过一个临界点:adapter 权重挤占 KV cache 的显存,batch 装不下,请求积压速度超过处理速度,进入 request starvation(延迟单调发散)。这个最优堆叠点论文记作 $Max_{pack}$,操作性定义是"吞吐仍高于总入向 token 速率 90% 的最高实测吞吐"。
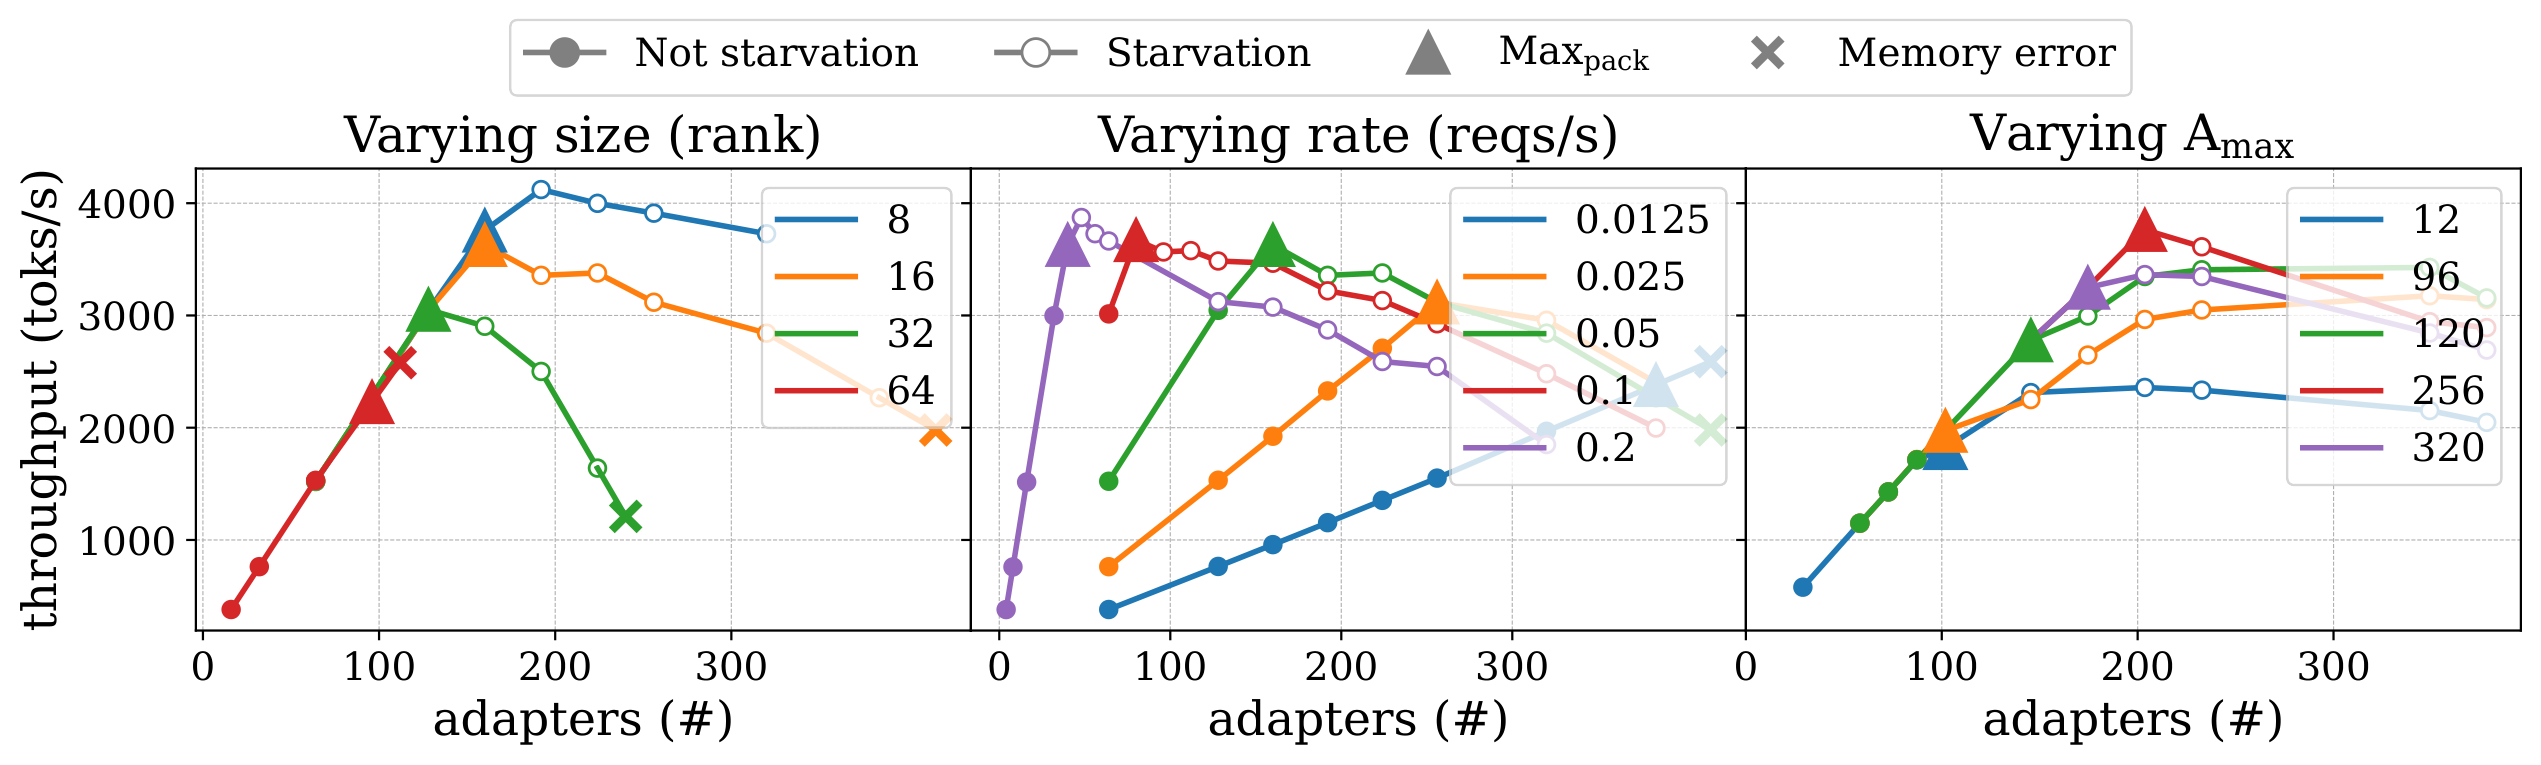
论文 Figure 1(caption: "Throughput as a function of the number of served adapters under varying adapter sizes (left), arrival rates (center) and configured $A_{max}$ (right).")。
三个面板给出的形状一致:吞吐先近线性上升,越过某点后饱和或下跌。关键在于拐点位置随三个参数剧烈漂移——大 adapter 拐点更早(占显存又增算力),低到达率拐点吞吐更低(要堆更多 adapter 才饱和,adapter 开销累积),而 A_max 本身是双刃:A_max=320 预留显存过多,A_max=96 又限制并行度。图中的叉号是硬 OOM:把 A_max 直接设成 adapter 总数(最"自然"的配置)在大 adapter + 低到达率时直接把权重区开爆。
vLLM 的机制约束放大了这个问题:显存在初始化时静态切分,A_max 决定预留给 adapter 权重的区域大小,且每个槽位按统一上限 $S_{max}$ 分配——不管实际 adapter rank 多大,全按场景中最大的那个算。所以一个 rank-32 的 adapter 会把同卡上所有 rank-8 adapter 的槽位一起撑大 4 倍。
Q2 — 方法:DT → ML 蒸馏 → 贪心装箱 #
三级流水线:
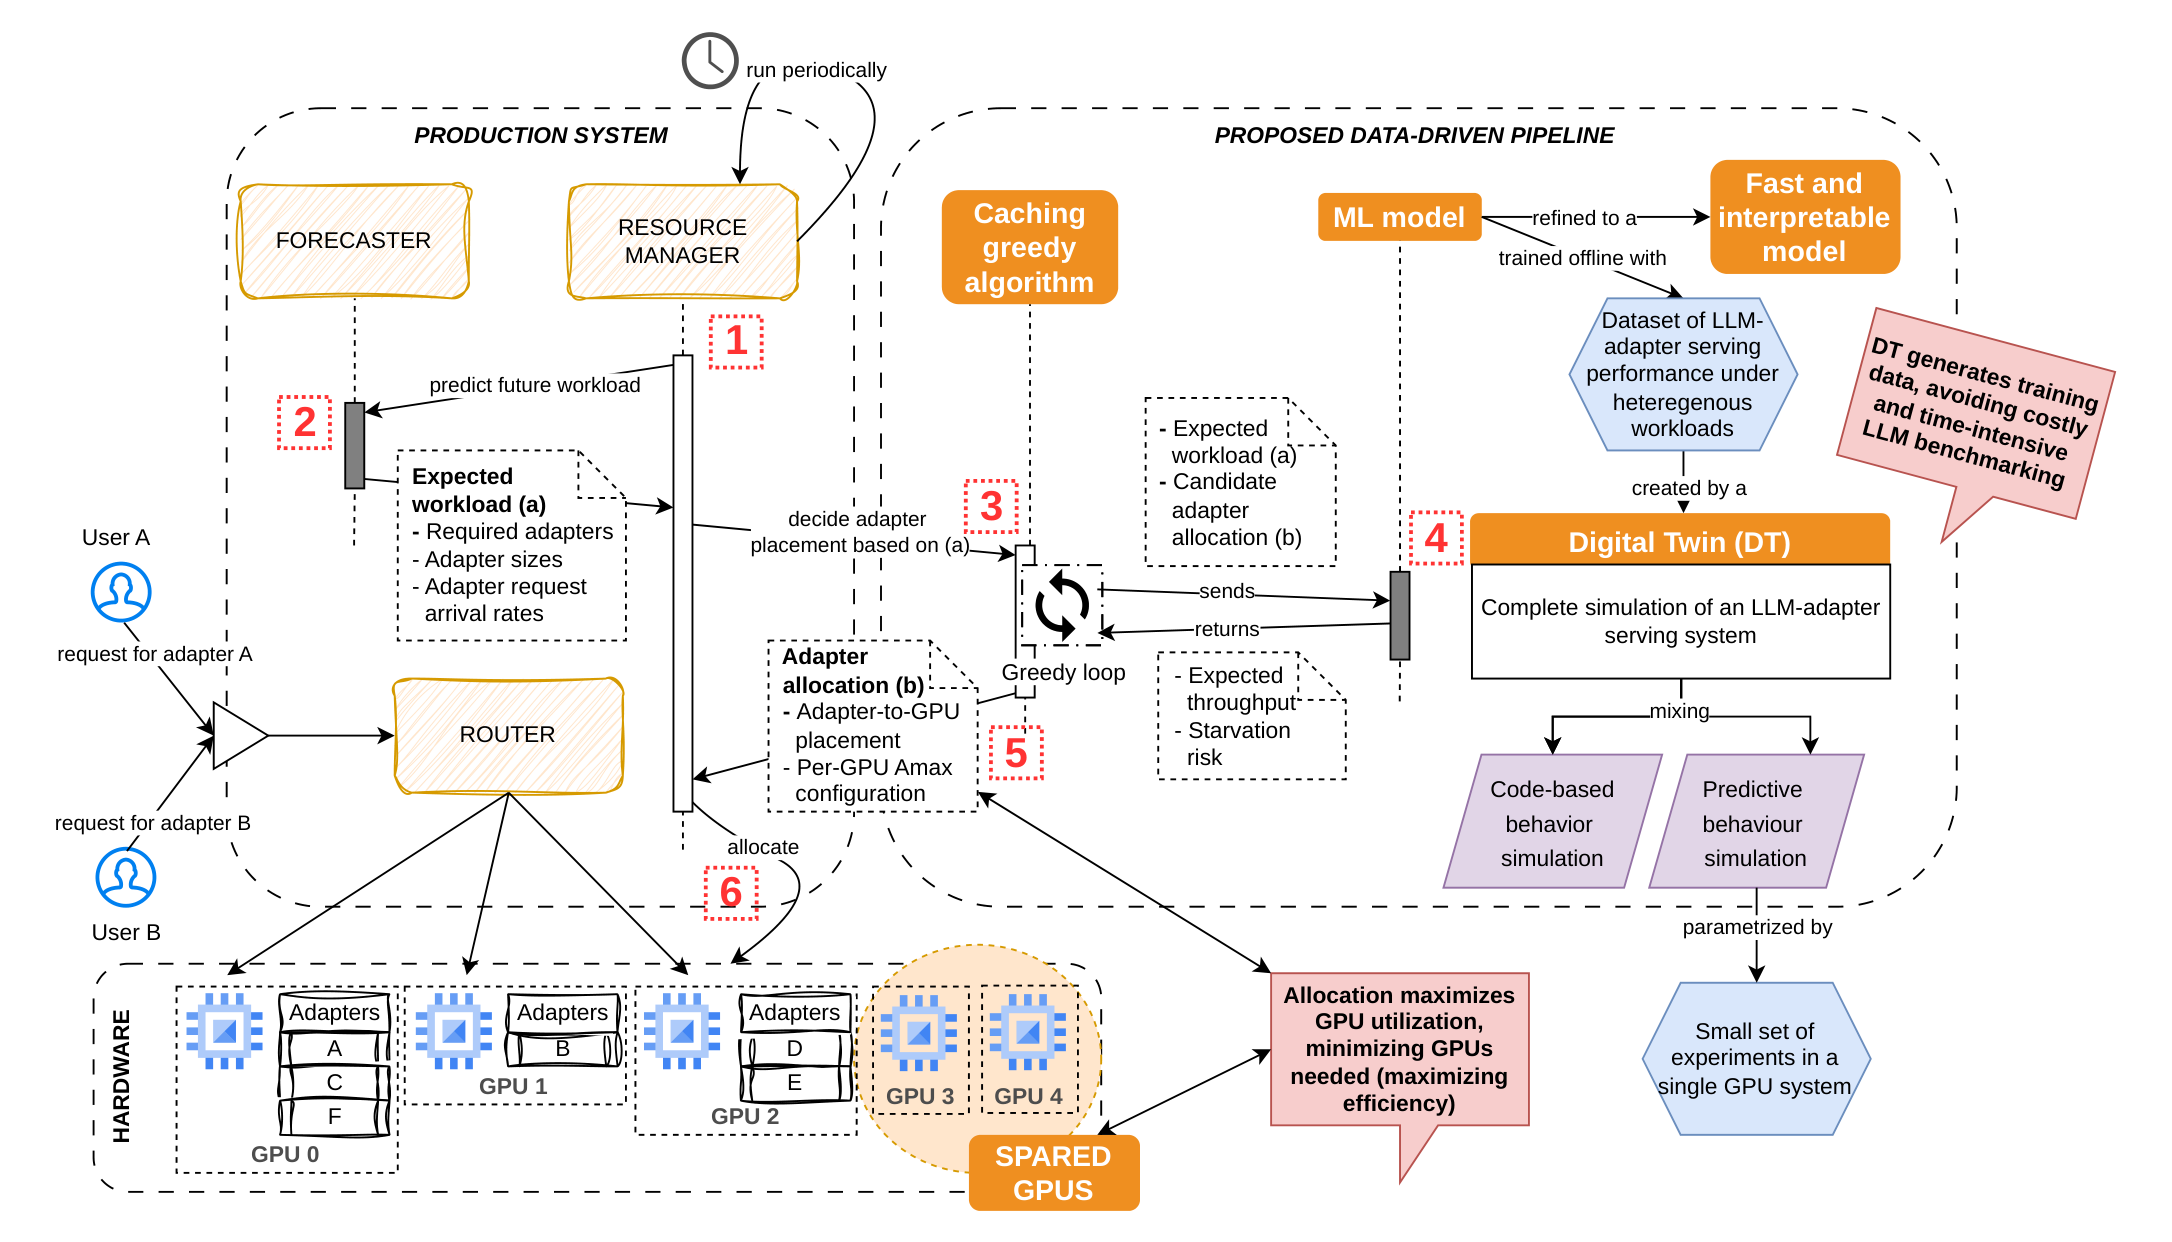
论文 Figure 2(caption: "Proposed data-driven pipeline to address the adapter caching problem (right), shown alongside its expected usage within a production system (left).")。
左半是生产集成方式:周期性地用"预期下一时段负载"重新调用流水线;右半是流水线内部。注意关键的分工——DT 只在离线跑(生成训练数据),在线决策路径上只有 ML 模型,因为贪心算法要在一次放置里反复查询上千次,DT 的 39 秒量级完全不可用。
- Digital Twin(§5):不是性能公式拟合器,而是把 vLLM 的 continuous batching 主循环用代码重实现一遍,状态转移函数逐步推进(注入到达 → scheduler 更新 batch → adapter cache 换入换出 → model forward)。耗时任务不真跑,改由 4 个拟合估计器给时间。纯 CPU、单核、~200MB。
- ML 阶段(§6):在 DT 生成的数据上训两个头——吞吐回归 + starvation 二分类。特征只有 7 维:adapter 数 $A$、到达率之和与标准差、adapter 尺寸的 max/mean/std、配置的 $A_{max}$。可选 refinement 把 RF 蒸馏成一棵浅决策树,再用 Numba 重写。
- 贪心算法(§7):First-Fit Decreasing 变体。adapter 先按尺寸降序分组(防止后来者抬高 $S_{max}$),组内按到达率 zigzag(高低交替)排列;逐个 provisional 塞进 GPU,到达预设测试点
[8, 16, 32, 64, 96, 128, 160, 192, 256, 320, 384]时调TestAllocation查 ML:先在当前 $A_{max}$ 和下一候选值之间选吞吐更高的,再用 starvation 分类器验一次;不过就整批回滚重排队。
核心技术壁垒:不是 DT,也不是 ML,而是把 A_max 从"用户拍脑袋的启动参数"提升为与放置决策联合求解的决策变量,并用一个学出来的 starvation 分类器作为可行性 oracle。两个 baseline(dLoRA、LoRAServe)都把 A_max 设成"每卡 adapter 数"——这恰好是 §2.3 已证明会触发 OOM 的配置。整篇论文的优势有相当一部分是从这个联合搜索里榨出来的,而它能成立的前提是有一个足够便宜(0.25ms)又足够准(macro-F1 0.95–0.99)的 starvation 预测器;这个预测器又只能由 DT 喂数据训出来,因为真机穷举一小时一个点根本跑不完。这条"便宜的可行性 oracle"链条是最难复制的部分。
Q3 — 结果 #
| 指标 | 数值 | 出处 |
|---|---|---|
| GPU 数量减少 | 平均 2.4 张 / 4 张 = 60% | Fig. 11 |
| DT 吞吐保真度 | SMAPE ≤ 5.08%(ITL ≤ 9.63%,TTFT ~19%) | Table 1 |
| DT 加速比 | ~39s vs 1 小时真机 ≈ 90×,1 CPU 核 / 0 GPU / ~200MB | Table 2 |
| ML 吞吐预测 | SMAPE < 8%;starvation macro-F1 0.93–0.99 | Table 4 |
| 蒸馏后推理 | 规则数 7.13e6 → 32;时延 0.25ms → 1.13e-4ms | Table 5 |
| 放置计算时间 | Proposed 1.59–1.79s;ProposedFast 4ms | Table 6 |
| 单卡可服务 adapter 数 | >500(baseline <200),吞吐 >2× | Fig. 10a |
代价明确写在论文里:ITL 比两个 baseline 都差(堆得越满 batch 越大),并且自曝一处回归——Qwen center-right 配置下 Proposed 低估峰值利用率,错误地判定 >768 adapter 不可行,而 baseline 实际服务成功了。
§3 架构 / 方法图 #
3.1 Digital Twin 内部结构 #
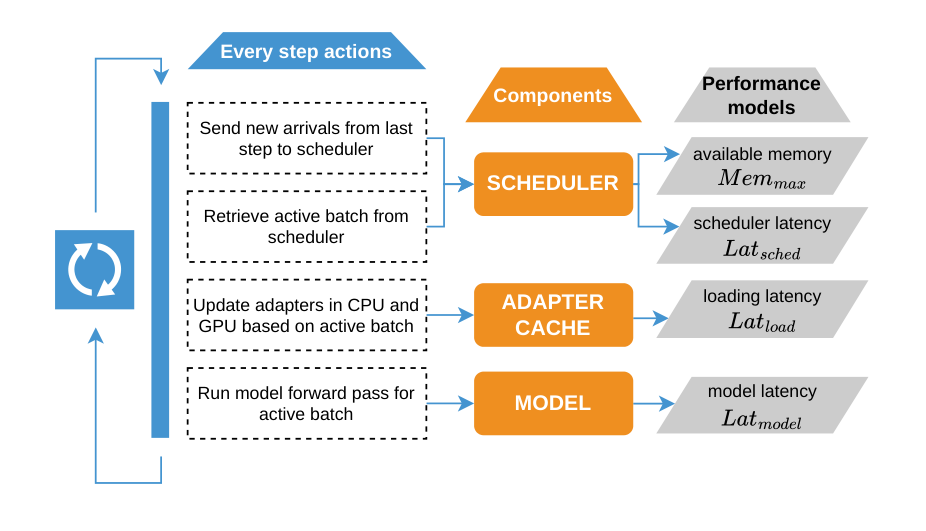
论文 Figure 3(caption: "Digital Twin behavior and architecture.")。左侧是每步仿真流程,右侧列出 Eq. (1) 的四个预测模型。
值得注意的是 DT 的输入契约与真机不完全相同:它额外需要"期望输出长度"作为输入参数,因为它不真跑 LLM 所以推不出 EOS 何时出现。论文的处理是全局平均输出长度(Mean 变体),而这恰恰是 ML 训练阶段实际使用的模式——也就是说生产流水线永远跑在它验证时精度较低的那个模式上。
3.2 部署拓扑(本文的"集群"实际形态) #
adapters, sizes, Poisson λ"] --> DT["Digital Twin
~39s/场景, 200MB"] DT --> DS["合成数据集
Llama 6h / Qwen 9h (80 核并行)"] DS --> RF["RF 吞吐回归 + starvation 分类"] RF -.refinement.-> ST["Small Tree + Numba
32 rules, 113ns"] end subgraph Online["在线放置(周期性重算)"] GA["贪心 FFD 变体
Algorithm 1 + TestAllocation"] end RF --> GA ST --> GA GA --> P["g[a] 放置 + A_max[g] 每卡配置"] subgraph Node["单节点 4×H100 (64GB), 512GB RAM"] G0["GPU0: vLLM 实例
A_max0"] G1["GPU1: vLLM 实例
A_max1"] G2["GPU2: 空闲/他用"] G3["GPU3: 空闲/下电"] end P --> G0 P --> G1 R["请求按 adapter 归属路由"] --> G0 R --> G1
拓扑层面必须说清楚的事实:节点数 = 1,GPU/node = 4,没有 NIC、没有交换机层级、没有 rail、没有 over-subscription。四张 H100 之间不做任何 tensor/pipeline 并行,也不跑 all-reduce——每张卡是一个完全独立的 vLLM 实例,"分布式"仅指请求按 adapter 归属被路由到不同实例。唯一的数据通路是 CPU RAM ↔ GPU 的 adapter 权重换入换出(PCIe),disk→CPU 被当作一次性初始化成本剔除。因此本文对 fabric、拥塞控制、集合通信算法均无贡献,也不应按这些维度评价它;它在集群语境下的贡献是容量规划 / bin packing 侧:用多少张卡承载给定的 adapter 负载。
节点内 NUMA / PCIe 拓扑(哪些 GPU 共享 root complex)论文未披露,而这对 adapter 换入带宽是有影响的——见 §4 检查 6。
§4 作者证明 #
论文的形式化内容集中在 Eq. (1)(DT 的四个估计器)与 Algorithm 1/2(放置过程)。没有定理,没有最优性/近似比证明——NP-hard 只是引用 bin packing 文献的一句断言,贪心算法的近似质量完全靠实验支撑。
4.1 记号表 #
| 符号 | 含义 |
|---|---|
| $A$ | 该 GPU 上服务的 adapter 总数 |
| $A_{max}$ | vLLM 静态配置的同时驻留 adapter 数上限(决策变量) |
| $S_{max}$ | 每 adapter 槽位统一预留的显存上限(取场景内最大 adapter 尺寸) |
| $T_{max}$ | 显存能容纳的最大请求 token 数 |
| $B$ | batch size |
| $R_P$ | 待处理(pending)请求数 |
| $A_B$ | 当前 batch 中不同 adapter 的个数 |
| $S_A$ / $L_A$ | adapter 尺寸 / 其加载耗时 |
| $K_1 \ldots K_7$ | 按 (backbone, adapter, 硬件) 用非线性最小二乘拟合的常数 |
| $Max_{pack}$ | 吞吐仍 ≥ 总入向 token 速率 90% 的最高实测吞吐 |
4.2 Eq. (1) 逐行物理意义 #
$$Mem_{max}(A_{max}, S_{max}) = T_{max}$$
纯经验查表,不是闭式解。它只依赖两个静态显存切分旋钮——这与 vLLM 在初始化时预分配 adapter 区域的语义严格一致:一旦 $A_{max}$、$S_{max}$ 选定,token 预算就冻结了。论文承认可以推解析式但"经验拟合更直接且同样准",未给消融。
$$Lat_{sched}(B, R_P, A_B, A) = K_1 B + K_2 R_P + K_3 R_P \frac{A_B}{A}$$
三项一一对应 vLLM 调度器里的三段循环:遍历活跃 batch 检测完成请求($K_1B$)、部分遍历 pending 队列判定可纳入性($K_2R_P$)、以及 §5.1.4 那个病态项。第三项的建模选择值得停下来看:分数 $A_B/A$ 表示"已在 batch 中的 adapter 占服务总数的比例",它刻画的是调度器要扫多深才能找到可执行请求。
$$Lat_{model}(B, A) = Lat_{backbone} \cdot Overhead_A = (K_4 B + K_5)(K_6 A + K_7)$$
注意这是乘积不是求和。线性于 $B$ 的因子是 backbone 成本,线性于 $A$ 的因子是相对慢化率——与 Fig. 5 把 adapter 影响报成"相对 backbone-only 的 throughput slowdown / ITL overhead"这一测量方式匹配。截距 $K_5$ 吸收固定每步开销,$K_7$ 吸收 0→1 个 adapter 那个陡降。
4.3 最小检查集 #
检查 1 — Eq. (1) 建模形式与测量语义的一致性(通过,但有张力)。 §5.1.2 用语是 adapter 引入"额外的计算与 GPU 内部传输",直觉上应是加法项;Eq. (1) 却写成乘法。乘法形式在量纲上自洽($Overhead_A$ 无量纲),且与 Fig. 5 的相对度量口径一致。但它隐含一个物理主张:adapter 开销正比于 backbone 时间,因而随 batch size 增长而放大。这在 backbone 与 adapter 计算共享同一 GEMM 批次时说得通,作为可证伪预测应当能在固定 $A$、扫 $B$ 时验证——论文未做这个正交实验。
检查 2 — DT 加速比算术(通过)。 Table 2 给 Llama $38.94 \pm 5.58$ s,真机每配置跑 1 小时。$3600/38.94 = 92.4$,$3600/(38.94{+}5.58) = 80.9$。"up to 90×"与均值一致,且下界(含 1σ)仍在 80× 量级。CPU 89.5% 说明确为单核。
检查 3 — 60% GPU 削减的算术(通过,但口径需注意)。 baseline 恒用满 4 卡,$2.4/4 = 60\%$。但 2.4 是跨所有评测场景的平均值,包含了 Proposed 只用 2 卡的低负载点和用满 4 卡的高负载点;它不是任一具体场景的削减率。论文正文的例子(Qwen 最右配置:256 / 768 adapter 分别用 2 / 3 卡)对应 50% / 25%,都低于 60%,说明 60% 的均值由更极端的低负载场景拉高。
检查 4 — 显存预算推导,独立复现 "$A_{max} > 144$ 有害" 这个决策树阈值(通过)。 取 Llama-3.1-8B、fp16、$S_{max}=32$(尺寸集 {8,16,32})。rank-$r$ LoRA 覆盖 q/k/v/o 四个投影、32 层、$d=4096$:每模块 $2 \cdot r \cdot 4096$ 参数,总计 $128 \cdot 2 \cdot 32 \cdot 4096 \approx 3.36\times10^7$ 参数 ≈ 67 MB (fp16)。则 $A_{max}=144$ 占 $144 \times 67\text{MB} \approx 9.7$ GB;$A_{max}=384$ 占 25.7 GB。KV 侧:Llama-3.1-8B 用 GQA(8 KV heads × 128 dim × 32 层 × 2 × 2B)= 128 KB/token。从 144 加到 384,牺牲 16 GB KV ≈ 12.5 万 token 的批处理容量。按 ShareGPT 平均序列长度数百 token 计,这是数百个并发请求的容量。而 §5.1.1 的 throughput plateau 说明超过某点后 batch 增大对吞吐几乎无回报——反过来,减小 batch 一定在 plateau 的陡峭段造成损失。两侧一凑,"$A_{max}$ 超过 ~144 净亏"这个学出来的阈值有独立的物理解释,不是过拟合噪声。
检查 5 — 排队论:90% 阈值即 $\rho = 0.9$,可反推出 ITL 惩罚(通过,且解释了论文的主要代价)。 $Max_{pack}$ 的定义"吞吐 ≥ 入向 token 速率的 90%"等价于把系统钉在利用率 $\rho \approx 0.9$。对 M/D/1(LLM decode 步长近似确定性),等待时间 $W = \frac{\rho}{2(1-\rho)} \cdot \tau = \frac{0.9}{0.2}\tau = 4.5\tau$;对 M/M/1 则是 $\frac{\rho}{1-\rho}\tau = 9\tau$。也就是说,按定义就要求排队时间是服务时间的 4.5–9 倍。baseline 摊在 4 张卡上时 $\rho \approx 0.45$,M/D/1 下 $W = 0.41\tau$——约一个数量级的排队延迟差。Fig. 11 里 Proposed 的 ITL 系统性劣于 baseline 因此不是实现瑕疵,而是目标函数的直接推论:60% 的 GPU 节省是用 $1/(1-\rho)$ 的延迟放大买来的。论文把这归因于"batch size 更大",这只是同一现象的另一半表述。
检查 6 — adapter 加载的带宽预算(不通过:实测远高于 DMA 理论值,说明开销不在链路上)。 rank-8 adapter ≈ 16.8 MB (fp16),PCIe Gen5 x16 有效带宽约 50 GB/s → 理论 DMA ~0.34 ms;rank-32 约 1.3 ms。论文报告"小请求下 CPU 加载增加 7–16% 延迟"。取小请求为 output≈8 token、TPOT≈25 ms,则请求延迟 $\approx 25 \times 7 = 175$ ms,7% = 12 ms——比 DMA 理论值高 30×以上。结论:加载开销主要不是 PCIe 搬运,而是 vLLM LoRA 加载路径的框架成本(逐 tensor host 拷贝、槽位管理、同步点)。这解释了为什么 $Lat_{load}$ 只能查表拟合而无法解析建模,也意味着该常数是强框架版本依赖的,换 vLLM 版本或换成 zero-copy pinned-memory 路径后 DT 需重新参数化。论文把 disk 加载"当作一次性初始化成本"剔除同样只在 adapter 集合静态时成立;周期性重放置一旦改变 adapter→GPU 归属,冷 adapter 就要重新从 disk 进来(disk 比 CPU 慢 70%)。
检查 7 — refinement 加速比声明与 Table 5 单元格不完全自洽(不通过)。 声明是"shallow tree 超过 69×,Numba 版最高 2120×"。逐格算:Llama 吞吐 $0.25/3.24\text{e-}3 = 77\times$、$0.25/1.13\text{e-}4 = 2212\times$;Qwen 吞吐 $83\times$ / $2244\times$;Llama starvation $0.16/3.25\text{e-}3 = \mathbf{49\times}$ / $1928\times$;Qwen starvation $68.5\times$ / $0.22/1.05\text{e-}3 = \mathbf{210\times}$。下界 69× 被 Llama starvation 的 49× 违反,上界 2120× 被两个吞吐格的 2212×/2244× 超出。另外 Qwen starvation 的 Numba 版写作 10.5e-4(非常规写法,即 1.05e-3),是唯一没有掉到 1e-4 ms 以下的格子——210× 与其他三格的 ~2000× 差一个数量级,提示这一格可能是笔误或该树未真正走 Numba 路径。精度退化的两个平均值可复现:SMAPE $(5.86+7.61)/2 = 6.735 \approx 6.74$;F1 $(0.03+0.02)/2 = 0.025$,均通过。
检查 8 — "Original 变体一致更优"被 Table 1 自身证伪(不通过)。 12 个 (模型 × 到达模式 × 指标) 格子里有 6 个 Mean 更优:可预测 TTFT 两行(18.83→17.44、18.95→17.92)、不可预测 TTFT 两行(19.95→19.91、20.74→20.72)、以及不可预测下 Qwen 的吞吐(5.16→5.12)与 ITL(9.87→9.22)。即给 DT 精确的逐请求长度反而让 TTFT 系统性变差。这不是随机波动:TTFT 由请求何时被准入决定,而准入取决于 KV 预算下的排队顺序;喂进真实的长度异质性会让 DT 的贪心 KV 分配在个别长请求上偏离真机的抢占行为,误差被 TTFT 放大而被吞吐(累积量)平均掉。对结论的实际影响是正向的——生产可用的 Mean 模式并不比理想模式差——但论文的表述与自己的表相矛盾。
检查 9 — 放置耗时与 ML 调用次数不自洽(不通过,量级偏差 ~50×)。 Table 6:Proposed 1.59 s,用 RF(吞吐 0.25 ms、starvation 0.16 ms)。若每次 TestAllocation 是 2 次吞吐 + 1 次 starvation ≈ 0.66 ms,1.59 s 对应约 2400 次 TestAllocation。但结构上界是:11 个测试点 × 4 GPU = 44 次(无回滚时),即使算上回滚重试也难以达到 2400。反过来 ProposedFast 4 ms 配 1.13e-4 ms 的树,若调用次数相同(2400)应只需 0.8 ms,说明其 4 ms 中大部分是排序与簿记等非 ML 成本。两个变体无法用同一套调用次数同时解释,提示 Proposed 的 1.59 s 里含有可观的 scikit-learn 单次调用开销(batch=1 时 predict 的 Python/校验成本远高于 Table 4 报的摊薄值)。这不影响结论方向(4 ms 仍足够周期性重配置),但说明 Table 4 的"预测时延"与 Table 6 的端到端时间不能直接相乘对账。
检查 10 — 集合通信规模公式(不适用,明确记录)。 常规集群论文要给 $T_{collective}(N)$;本文架构下不存在跨 GPU 集合通信,$N$ 张卡之间零通信,扩展成本项是放置算法本身的 $O(N_{adapter} \log N_{adapter})$ 排序 + $O(|\text{testing points}| \times N_{GPU})$ 次 oracle 查询。真正的扩展性瓶颈不在通信而在两处:(a) DT 数据集生成随 adapter 上限增长(Qwen 因为模型更小能塞更多 adapter,数据集生成反而从 6 小时涨到 9 小时);(b) ML 模型的特征向量只有 7 维聚合统计量,与 GPU 数无关,因此模型本身可跨规模复用,但贪心的 first-fit 决策质量随 $N_{GPU}$ 增长未被评估(只测到 4 卡)。
§5 实验与数据 #
5.1 四类 adapter 开销的刻画(DT 的地基) #
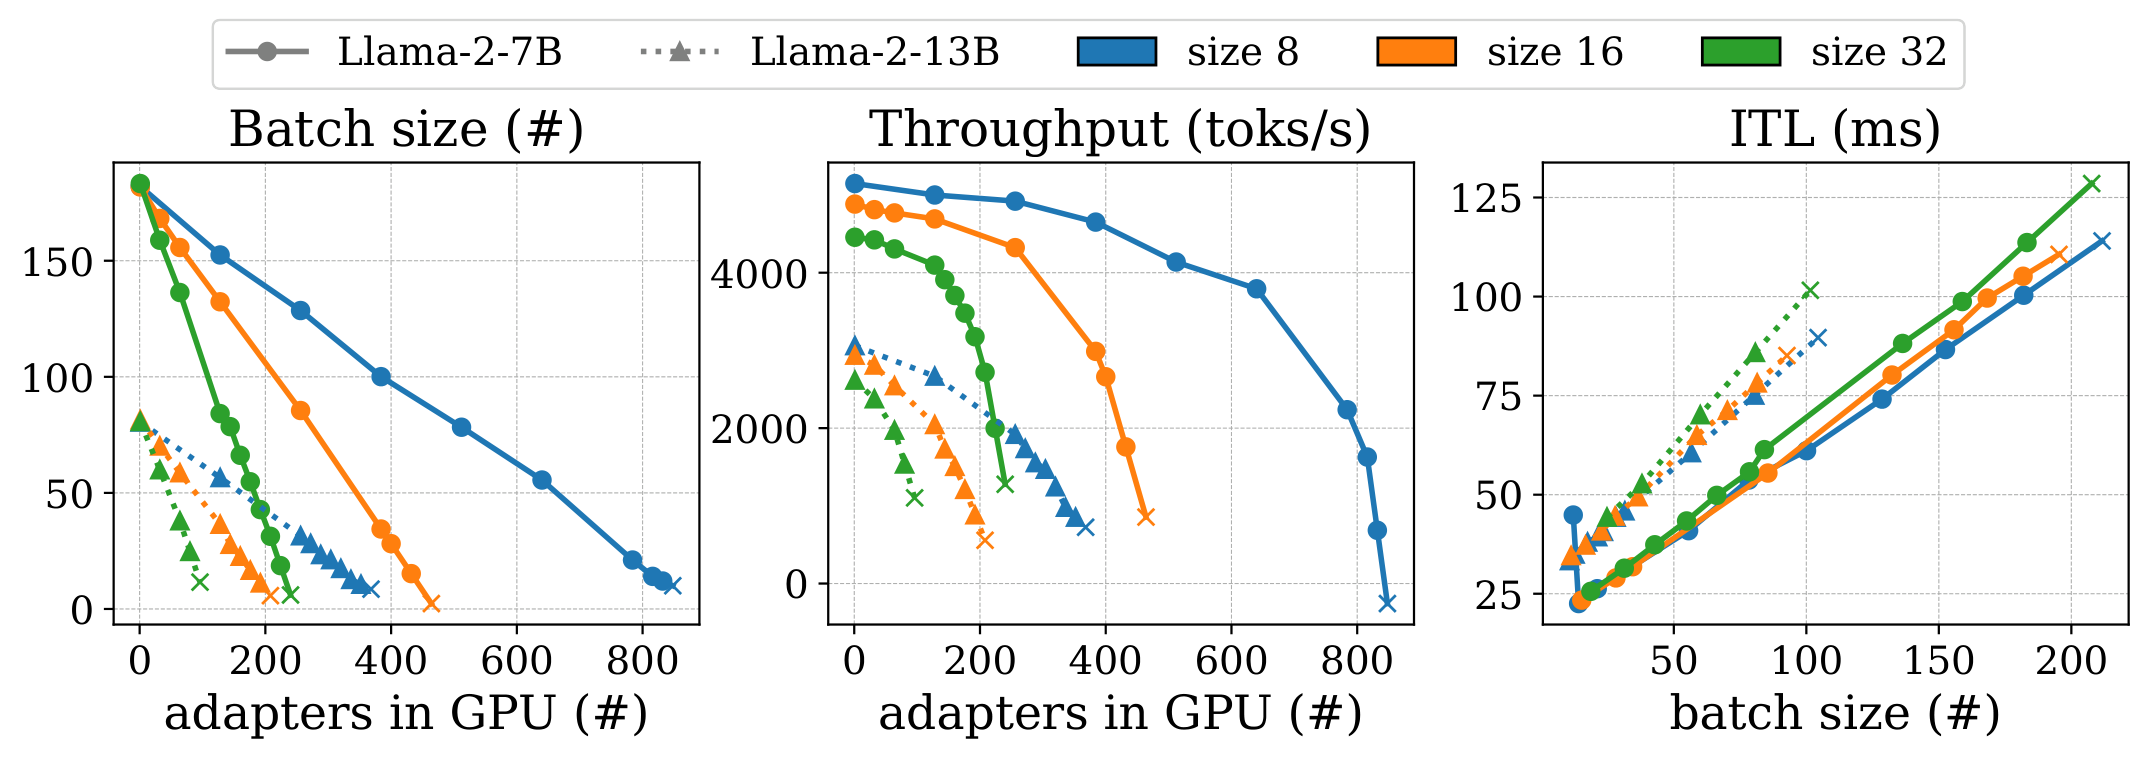
论文 Figure 4(caption: "Evolution of batch size and throughput with increasing numbers of loaded adapters (left, center) and ITL versus batch size (right)... Crosses denote the point where GPU memory is exhausted.")。
这张图给出了全文最反直觉的观察:左图 batch size 随 adapter 数近线性下降,中图吞吐却几乎不动——Llama-2-7B 上前约 100 个 adapter 对吞吐的影响可忽略,论文声称首次报道此现象。机制是 throughput plateau:batch 在饱和区,砍掉一部分并发对吞吐没有回报也没有损失。这直接决定了 A_max 存在一段"免费区间",也是检查 4 中 144 这个阈值的物理来源。右图确认 ITL 线性于 batch size,为 Eq. (1) 的 $K_4B + K_5$ 提供依据。
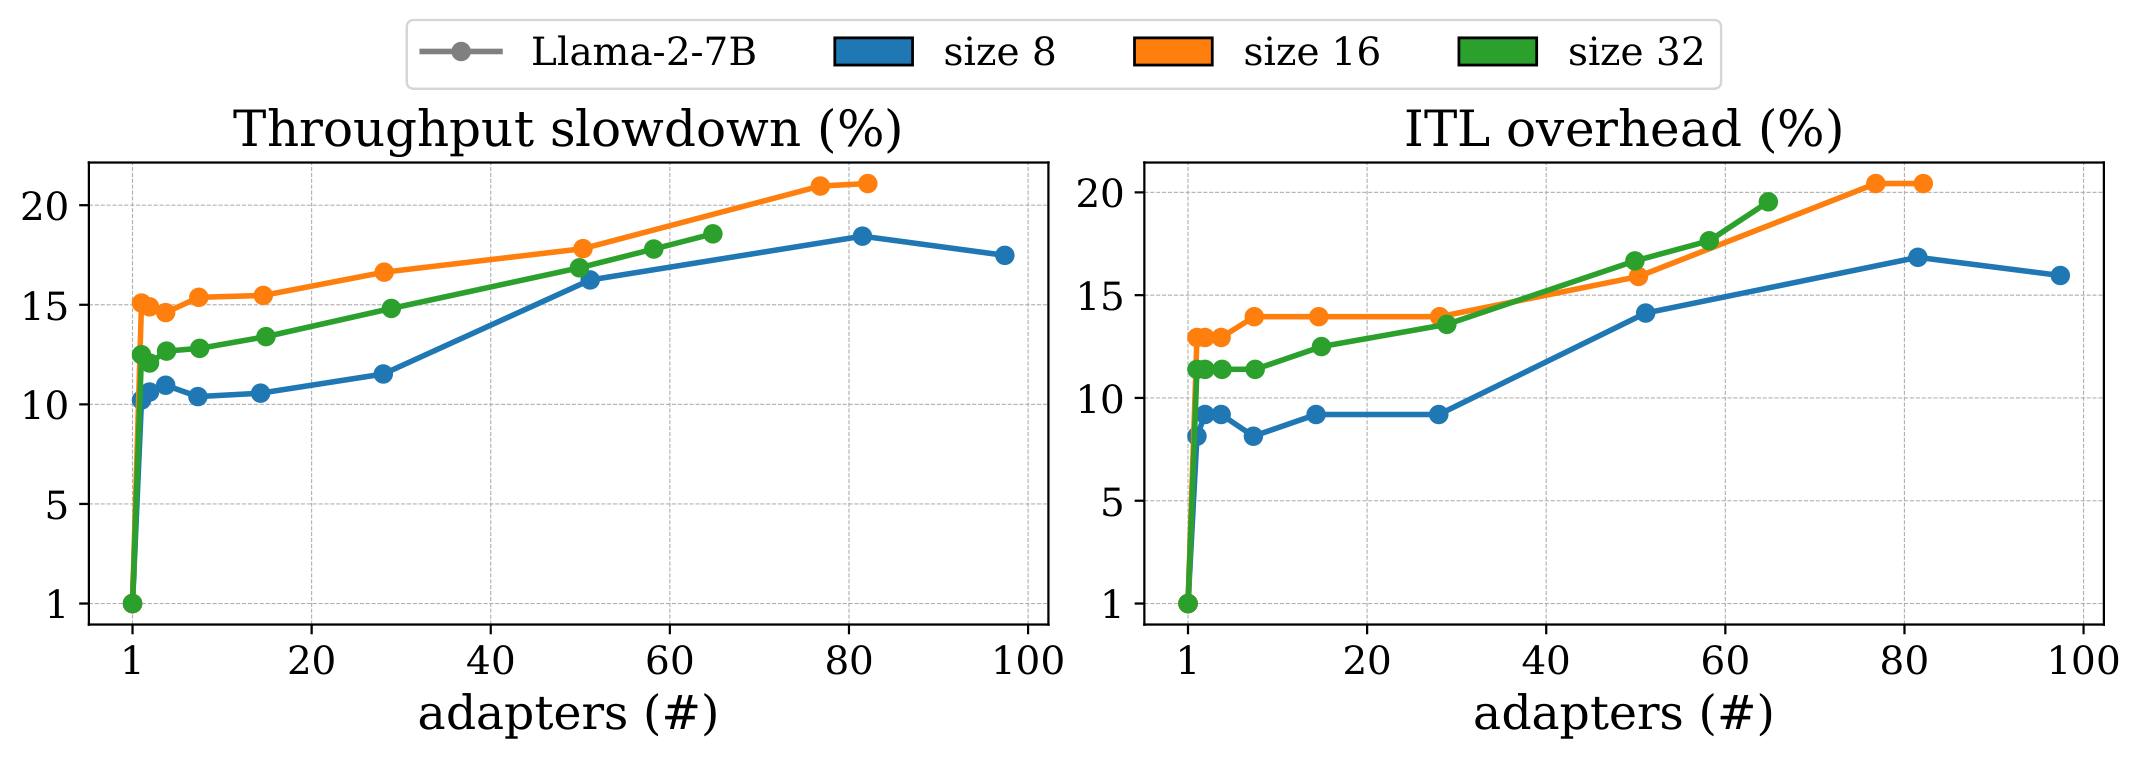
论文 Figure 5(caption: "Throughput slowdown and ITL overhead for increasing adapters across three adapter sizes... relative to backbone-only execution.")。
两条曲线在 0→1 个 adapter 处有陡降(从纯 backbone 切到必须算 adapter 激活并做额外 GPU 内传输),此后近似线性。这是 $Overhead_A = K_6A + K_7$ 的直接来源,$K_7$ 就是那个跳变。注意 adapter 尺寸影响很小(size 32 偶尔还优于 size 16)——这与 Toppings 把 adapter 计算延迟建模为 batch size × adapter 尺寸的做法冲突,论文据此明确偏离了前人的模型形式。
5.2 DT 保真度 #
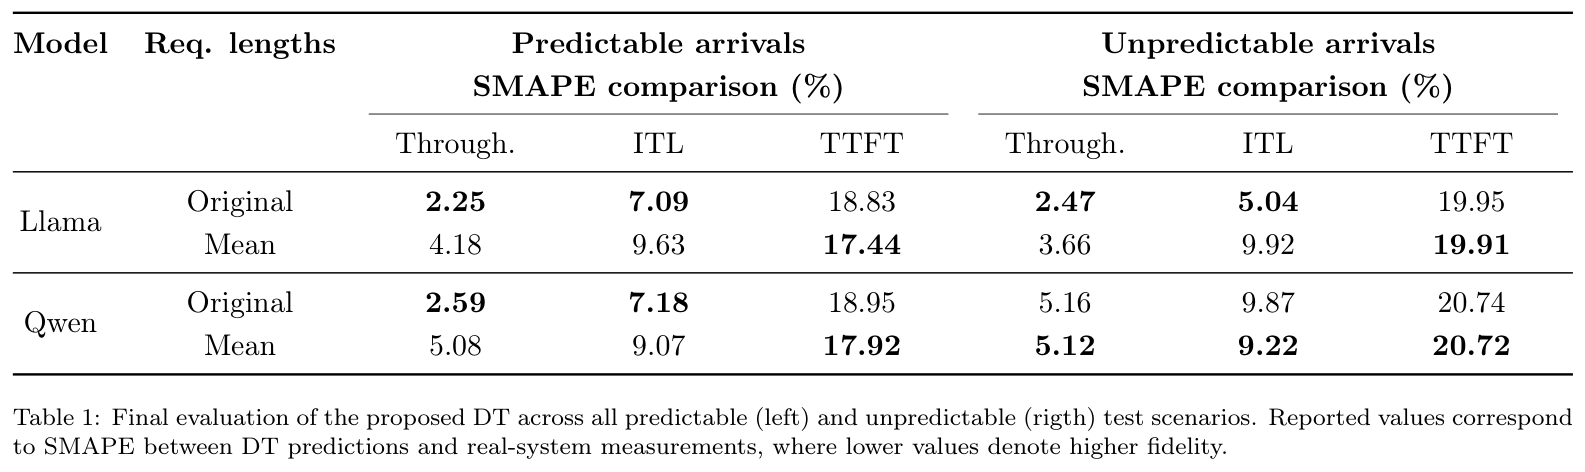
论文 Table 1(caption: "Final evaluation of the proposed DT across all predictable (left) and unpredictable (rigth) test scenarios.",原文拼写保留)。
吞吐 ≤5.08%、ITL ≤9.63% 是可信的;TTFT ~19% 是明确的短板。这个误差结构与 §4 检查 8 的分析一致:DT 复现的是累积吞吐动力学而非单请求准入时刻。对下游用途影响不大——ML 阶段只学吞吐与 starvation,都不依赖 TTFT——但也意味着这个 DT 不能直接拿去做 TTFT SLO 相关的调度研究,尽管 §9 讨论里暗示了这类扩展。
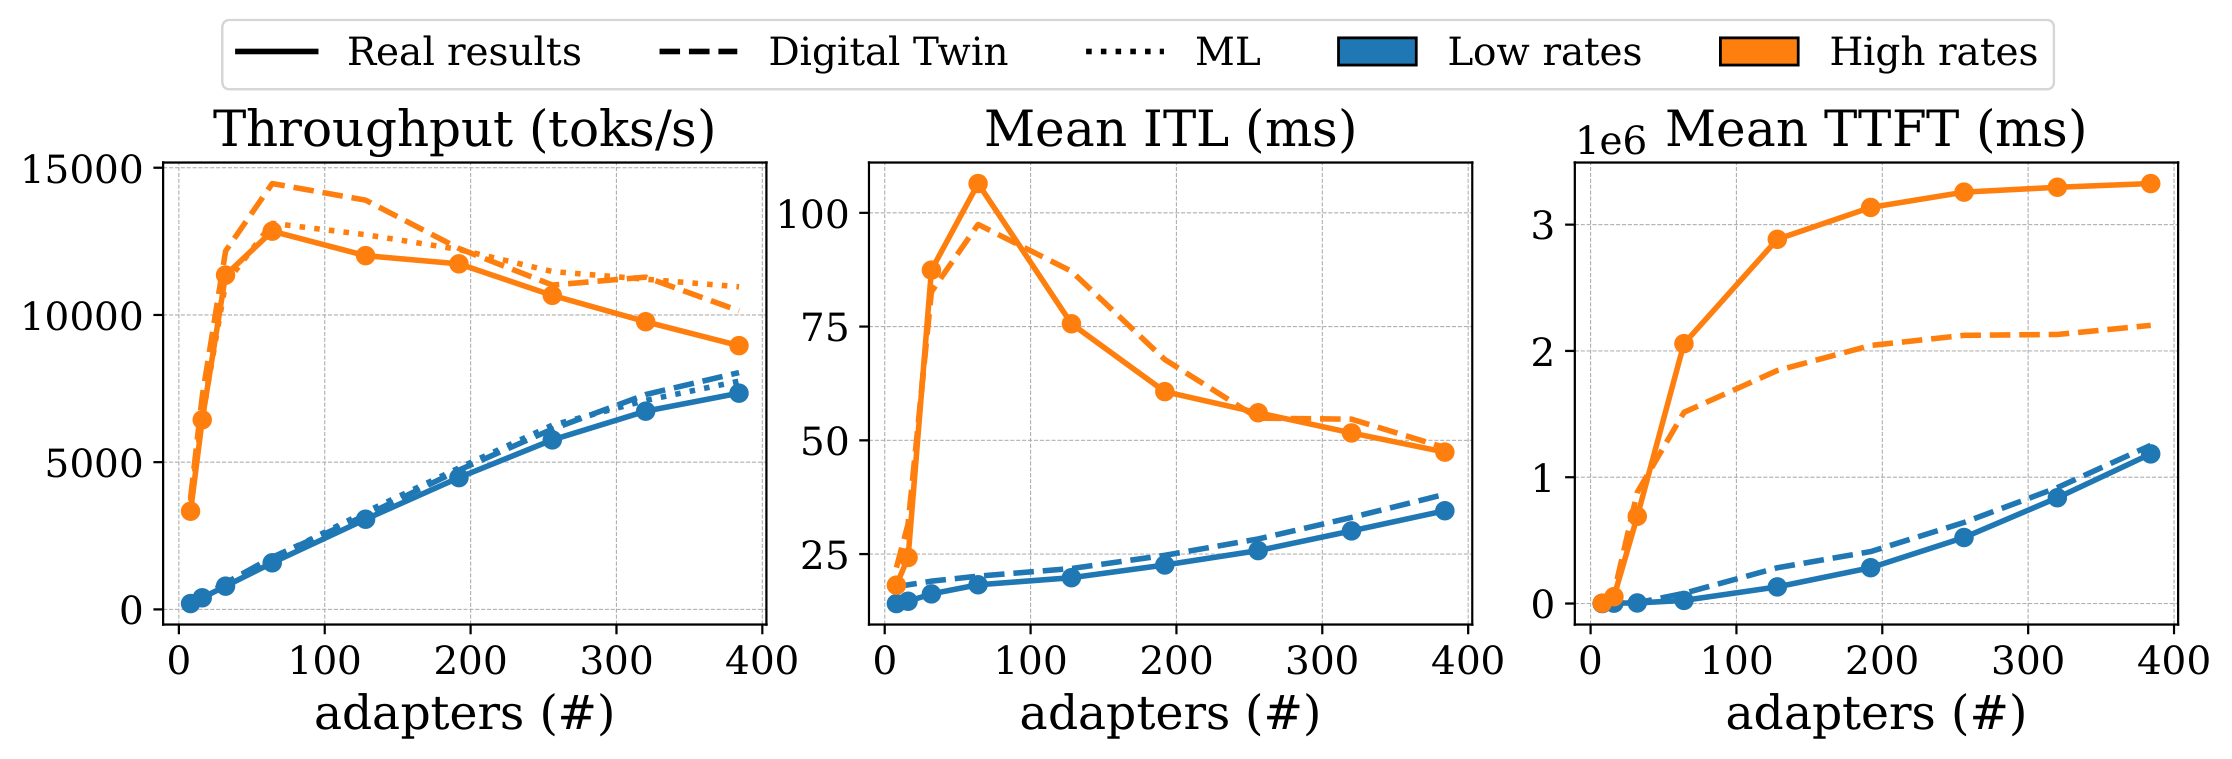
论文 Figure 8(caption: "Comparison between DT predictions and real-system measurements for throughput, ITL, and TTFT under varying numbers of adapters and arrival rates... For throughput, predictions produced by the ML model are also reported.")。
吞吐与 ITL 曲线贴合良好,TTFT 在高到达率下发散——再次指向排队/准入建模的偏差,且偏差随 $\rho$ 增大而放大,与检查 5 的 $1/(1-\rho)$ 敏感性一致。
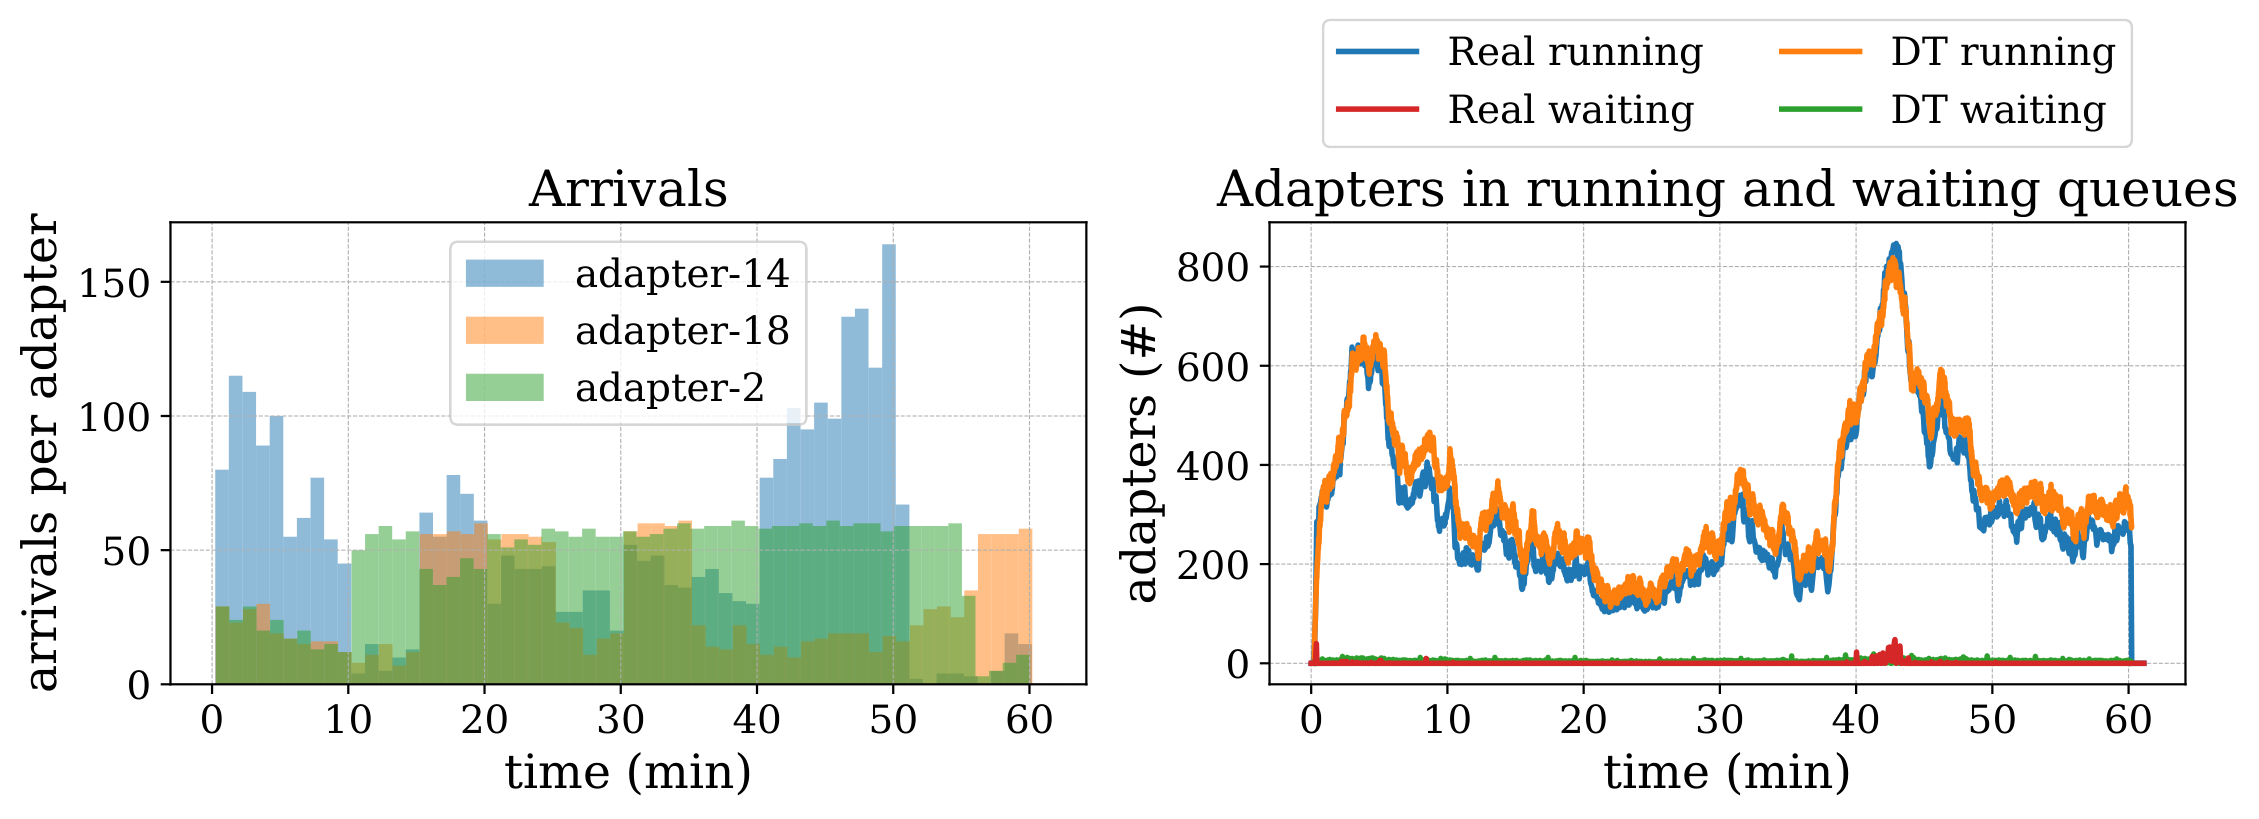
论文 Figure 9(caption: "(Left) Non-stationary arrival traces for randomly sampled adapters. (Right) Comparison of running and waiting requests over time between the DT and the real system.")。
这是全文最有说服力的一张保真度证据。每 5 分钟随机在 Poisson / log-normal 之间切换分布、并把速率随机 ×2 或 ÷2,属于刻意构造的对抗性非平稳流量;DT 的 running/waiting 队列长度时间序列仍与真机贴合,说明它复现的不只是稳态平均值,而是 scheduler、KV 分配、adapter 换入换出的瞬态耦合。这比 Table 1 的聚合 SMAPE 更能支撑"code-based 而非公式拟合"的设计主张。
5.3 端到端放置结果 #
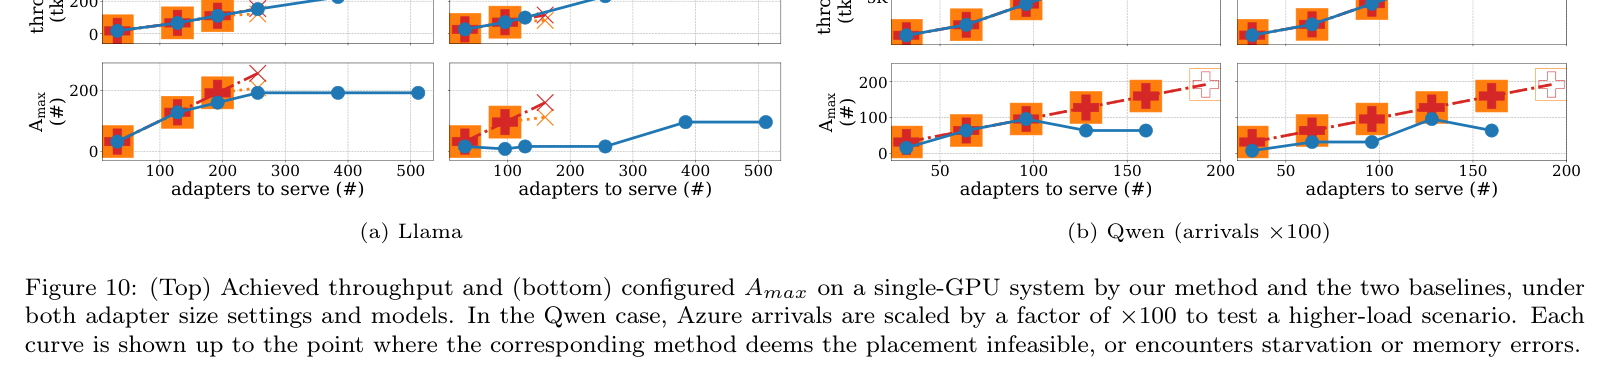
论文 Figure 10(caption: "(Top) Achieved throughput and (bottom) configured $A_{max}$ on a single-GPU system by our method and the two baselines... Each curve is shown up to the point where the corresponding method deems the placement infeasible, or encounters starvation or memory errors.")。
下排的 $A_{max}$ 曲线是理解全文的关键:Proposed 一开始让 $A_{max}$ 贴近 adapter 数(要并行度),随着 adapter 增多主动收紧,在含 rank-32 的场景收得更狠。两个 baseline 是水平/线性上升的直线($A_{max}$ = 每卡 adapter 数),撞上显存墙即终止。低到达率场景下 Proposed 服务 >500 adapter 而 baseline <200,吞吐 >2×;高到达率场景(Qwen ×100)则相反——Proposed 提前停下,把超出的负载留给别的卡,而 baseline 继续塞直到饿死。同一个算法在两种瓶颈(adapter 权重显存 vs KV 显存)下表现出相反的行为方向,这正是"可行性 oracle"而非固定启发式带来的能力。
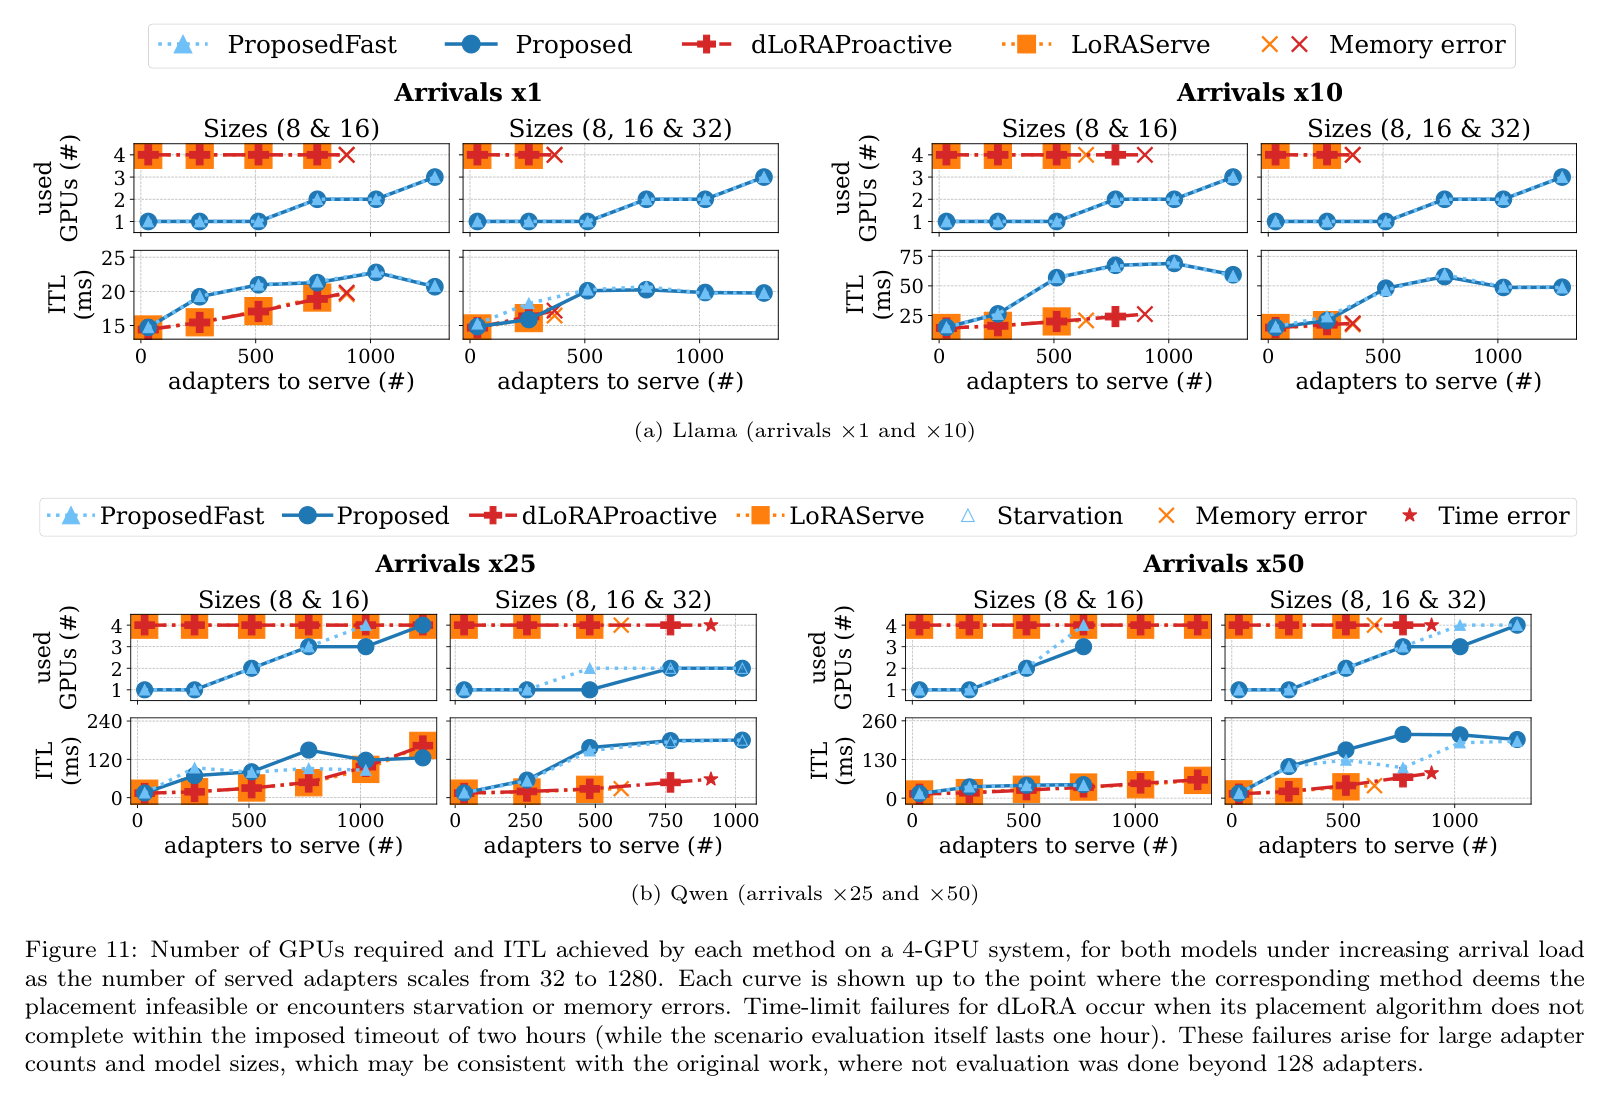
论文 Figure 11(caption: "Number of GPUs required and ITL achieved by each method on a 4-GPU system, for both models under increasing arrival load as the number of served adapters scales from 32 to 1280...")。
主结果图。GPU 数面板:baseline 恒为 4,Proposed / ProposedFast 在多数场景为 2–3。ITL 面板:Proposed 系统性更差——按检查 5,这是 $\rho=0.9$ 目标的必然结果而非可调优的实现缺陷。caption 里还藏着一个 baseline 侧的实际限制:dLoRA 的放置算法在大 adapter 数下两小时超时(而被规划的场景本身只有一小时),论文指出这与原作只评测到 128 adapter 相符——即 dLoRA 的 proactive 放置在 1280 adapter 规模上算法本身不可用。
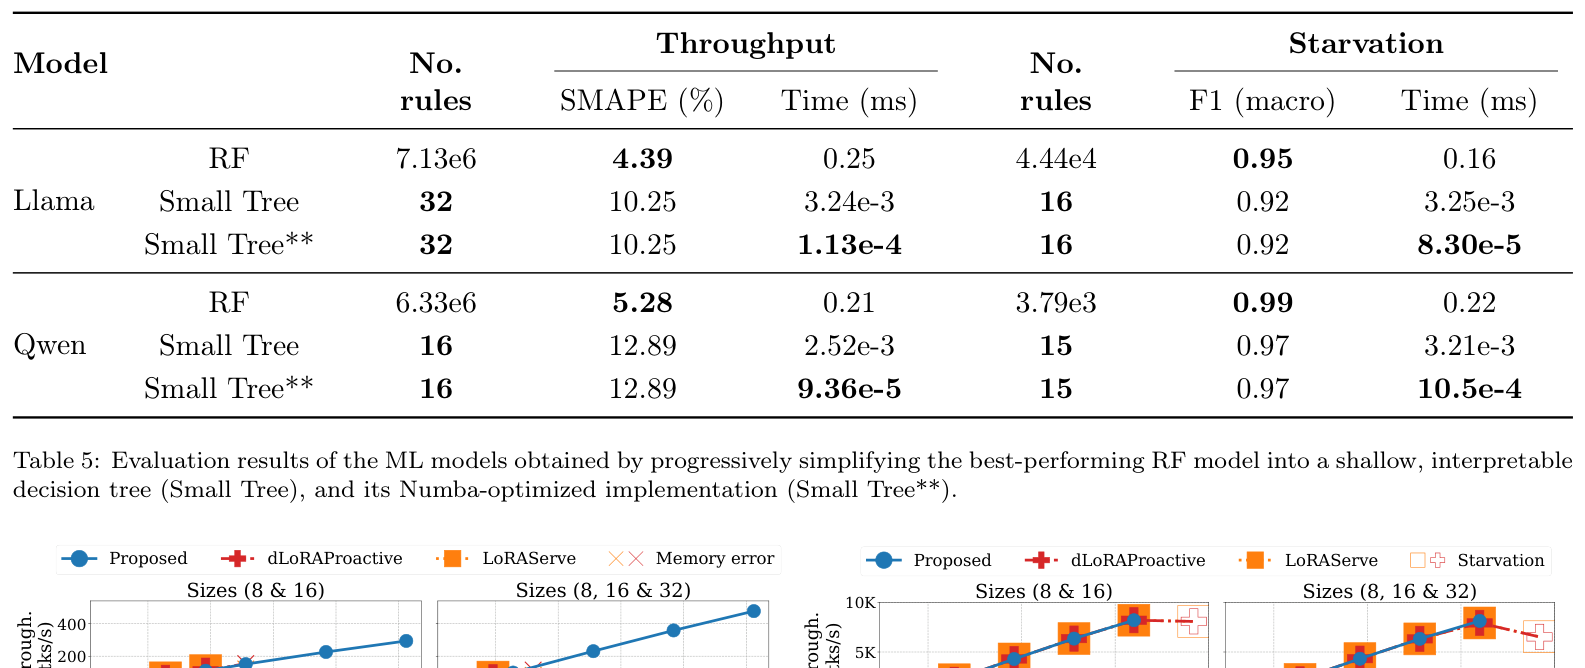
论文 Table 5(caption: "Evaluation results of the ML models obtained by progressively simplifying the best-performing RF model into a shallow, interpretable decision tree (Small Tree), and its Numba-optimized implementation (Small Tree).")。
规则数从 7.13e6 降到 32,时延降到百纳秒级,代价是吞吐 SMAPE 平均 +6.74%、starvation macro-F1 −0.025。表面上是划算的交易,但要看清楚退化落在哪个头上:starvation 分类器正是安全性保证的载体,而 §8.4.2 报告 ProposedFast 确实产出了导致饿死的放置(Qwen left-center 子图)。蒸馏在这里削弱的恰好是它唯一必须守住的性质。
§6 论证链 #
| # | 步骤 | 依据(论文内部) | 交付给下一步的东西 |
|---|---|---|---|
| 1 | 多租户 LoRA 服务中存在一个吞吐最优堆叠点 $Max_{pack}$,越过即 starvation 或 OOM;其位置随 adapter 尺寸、到达率、$A_{max}$ 剧烈漂移 | Fig. 1 三面板 + 叉号标记的 OOM 点;Appendix A 的 Fig. 13 在 S-LoRA 上复现同一现象 | 一个需要按工作负载逐例求解的、有硬约束的最优化问题 |
| 2 | 该漂移可归因于四类可测量的开销:权重占显存、adapter 计算/传输、加载时延、vLLM 调度器扫描 | Fig. 4(显存 + throughput plateau)、Fig. 5(计算,0→1 跳变 + 线性)、Fig. 6(加载,随请求长度摊薄)、Fig. 7(调度器,$A_{max}$ 小时达 6%) | 四条可参数化的函数形式 |
| 3 | 把四类开销写成 Eq. (1) 的四个估计器,嵌入一个重实现 vLLM continuous-batching 主循环的代码级仿真器,即得到 DT | Eq. (1) 各项与步骤 2 的开销一一对应;常数用非线性最小二乘拟合 | 一个纯 CPU、~39s/场景的行为等价体 |
| 4 | 该 DT 对真机保真:吞吐 SMAPE ≤5.08%,且在刻意构造的非平稳到达下队列动力学仍贴合 | Table 1 两组列;Table 2 的资源占用;Fig. 9 右图的 running/waiting 时序 | 许可用 DT 输出作为训练标签,而无需真机穷举 |
| 5 | 用 DT 在 (尺寸集 × 到达率集 × adapter 数 × $A_{max}$) 的笛卡尔网格上生成数据,训练吞吐回归 + starvation 分类两个头 | Table 3(6–9 小时,80 核并行);Table 4(SMAPE <8%,macro-F1 0.93–0.99,时延 <0.3ms) | 一个亚毫秒级、可在线反复查询的可行性 + 性能 oracle |
| 6 | 将 adapter 放置形式化为 bin packing 变体,用 FFD 变体贪心 + 该 oracle 联合搜索放置与每卡 $A_{max}$,在测试点处试探-提交-回滚 | Algorithm 1(尺寸降序 + 到达率 zigzag,测试点数组);Algorithm 2(两候选 $A_{max}$ 择优 + starvation 校验) | 每 adapter 的 GPU 归属 $g[a]$ 与每卡 $A_{max}[g]$ |
| 7 | 该放置在单卡上确实把系统压到 $Max_{pack}$:低到达率下服务 >500 adapter(baseline <200,吞吐 >2×),高到达率下主动停在可行边界 | Fig. 10a / 10b 的吞吐与 $A_{max}$ 双排面板 | "每卡吃满且不越界"的能力 |
| 8 | 把每卡吃满的能力汇总到 4 卡系统,即得到 GPU 数量的净削减:平均 2.4 张(60%),代价是 ITL 上升 | Fig. 11 的 GPU 数面板与 ITL 面板;Table 6 的放置耗时(Proposed 1.6s / ProposedFast 4ms) | 主结论:可预测负载下用更少的卡承载同样工作量 |
| 9 | 该结论的成立范围由作者自行收窄:单一数据集(ShareGPT)、训练仅用 Poisson 到达而评测用 Azure trace,后者被指为唯一一处过保守失败的成因 | §9.1 两段 limitation;§8.4.2 中 Qwen center-right 的自曝回归 | 边界条件与后续工作方向 |
§7 实现 cross-reference #
[实现未公开] —— 论文脚注承诺 "Code will be available at: https://github.com/FerranAgulloLopez/DistributedEfficientAdapterLLMServing",截至 L1 抓取时该仓库无可引用内容。DT、ML 流水线、贪心算法均无法给出 file:line 引证。LoRAServe baseline 亦无官方实现,由作者按论文描述重写;dLoRA baseline 用了原始代码库但只保留 proactive placement 部分。因此三方对比中有两方是重实现,这是评估可信度上必须记住的前提。
可复现的外部锚点只有环境本身:vLLM v0.8.5(§5.1 的性能刻画则用更早的 v0.5.0.post1),scikit-learn(RandomForestRegressor / SVR / KNeighborsRegressor 及对应分类器,HalvingGridSearchCV + 5-fold CV),SciPy 非线性最小二乘用于拟合 $K_1 \ldots K_7$,Numba 用于蒸馏树的机器码化。作者声明对 vLLM server 组件做了"minor modifications"以采集辅助指标并支持额外参数,并"substantially update"了 benchmark 脚本——这两处改动未量化,而 DT 参数化完全依赖这些采集到的内部指标,是复现路径上的实际缺口。
核心技术壁垒(展开) #
真正难复制的不是任何单个组件,而是「便宜且准的可行性 oracle」这条依赖链的闭环。要联合搜索 $(placement, A_{max})$,必须能在毫秒级判断一个候选配置会不会饿死;这个判据无法解析推导($Lat_{load}$ 和 $Mem_{max}$ 都只能查表,见检查 6 的分析),只能学;要学就要标注数据;真机每个数据点一小时,而训练网格是 (尺寸三元组 × 到达率十元组 × adapter 数 × $A_{max}$) 的笛卡尔积——真机路线在时间上不成立。DT 把单点成本压到 39 秒才让整条链条闭合(Llama 6 小时、Qwen 9 小时的数据集生成,80 核并行)。换言之,DT 不是一个可有可无的加速器,它是唯一使这个优化问题在数据上可解的环节。第三方要复现,必须先复现 DT 的四个估计器在自己框架版本 / 硬件上的参数化,而 §5.2 的常数拟合依赖的正是那些未公开的 vLLM 插桩指标。
关键实现细节(易被忽略的两处) #
1. PrioritySorting 的 zigzag 排序是全文唯一没有任何消融支撑的载荷设计。 排序策略是:先按 adapter 尺寸降序(这一步有明确理由——$S_{max}$ 取同卡最大值,先放大的可以防止后来者抬高整卡的槽位尺寸,从而回溯性地吃掉已放 adapter 的显存),组内再按到达率高低交替排列。zigzag 的作用是让每张卡拿到的到达率分布均衡,避免高速率 adapter 集中在前几张卡上过早触发 starvation 判定、把负载全推给后面的卡。论文对此只写了一句 "selected empirically, as it consistently improved throughput in our experiments",正文与附录均无对比数据。复现者若换成朴素的到达率降序,很可能得不到 60% 这个数字。
2. 测试点数组 [8, 16, 32, 64, 96, 128, 160, 192, 256, 320, 384] 被复用为两个语义完全不同的东西。 它既是"每卡累计 adapter 数达到多少时触发一次 TestAllocation"的检查点,也是 NextGPUConfig 返回的 $A_{max}$ 候选集合。这个复用是隐式的(论文只在 §7 用一句 "which reuses the same array of adapter counts defined earlier" 带过),但后果具体:$A_{max}$ 的可行取值被离散化到这 11 个值上,而检查 4 推出的物理最优阈值 ~144 恰好落在 128 与 160 之间——算法结构性地无法选中它。同时因为搜索是"当前值 vs 下一候选"的局部两点比较而非全集扫描,$A_{max}$ 只能单调地沿数组前进,一旦早期选定就无法回退到更小的值(除非整批回滚)。这两点共同解释了为什么会出现 Qwen center-right 那种过保守的误判。