Code as Agent Harness: Toward Executable, Verifiable, and Stateful Agent Systems
Code as Agent Harness — 作者意图蒸馏 #
1. TL;DR #
把 code 从「agent 的输出物」重定义为「agent 的运行底座」:可执行 / 可检视 / 有状态三性质让 code 成为 harness 接口本身。全篇最硬的诊断是——多数多智能体编码系统根本没有形式化、可查询的共享程序状态表示,这才是系统脆弱性的技术根源,而不是规模问题。478 篇引用,零自有实验。
2. Q1 / Q2 / Q3 #
Q1 — 痛点:自主性的瓶颈被错误归因给了模型 #
作者的起手式是一次归因转移。业界默认「agent 不可靠 = 基础模型推理不够强」,§1 para 2 明确否定:agent harness 指的是包住 LLM 的那层软件——工具、API、sandbox、memory、validator、权限边界、执行循环、反馈通道——「自主性的瓶颈不只是基座模型的推理能力,也是把模型输出连接到长程动作与持久状态的那套系统的可靠性」。
在这个框架下作者切出三个耦合但不同的东西,这个三分是全篇的概念地基:
| 元素 | 内容 | 研究现状 |
|---|---|---|
| model-internal capabilities | 推理、感知、规划、模拟、评估 | 被研究得最充分 |
| system-provided harness infrastructure | 预定义工具、API、sandbox、memory、validator、权限、遥测、workflow | harness engineering 的主战场 |
| agent-initiated code artifacts | agent 在任务循环内自己创建、执行、观察、修订、持久化、共享的代码对象(回归测试、临时工具、DSL 程序、可执行 workflow、可复用 skill、中间程序状态) | 作者称「relatively underexplored」,本篇的靶心 |
三个更具体的痛点,分别对应后面三层:
- 纯文本推理无法被 harness 检验(§2.1)。CoT 让模型同时负责分解问题和执行中间运算,而 LLM 对符号 / 逻辑 / 算术执行是不可靠的;更关键的是文本推理「几乎不给 harness 任何能力去验证中间状态、检视执行行为、跨步持久化计算进度」。
- 单步生成之外没有可靠机制(§3)。code 进入 agent loop 之后,问题从「生成正确程序」变成「模型判断 + 可变任务状态 + 人设计的 harness 基础设施」三者的交互。
- 多智能体的共享状态是隐式的(§4)。这是全篇最尖锐的一击,见 Q2 的技术壁垒段。
- implicit convergence 最盛行(§4.3.2)→ 没有客观状态表征,就没有原则性停机判据;
- 拓扑越来越复杂(§4.4 Trend 5)→ 底座不可查询,agent 只能靠更丰富的交互模式来补状态信息;
- context 管理机制层出不穷(§4.4 Trend 6)→ L2MAC 的 Control Unit、MetaGPT 的 pub-sub 池、SoA 的 agent 池扩缩、Cogito 的三层记忆,都是同一个问题的不同代偿。
Q2 — 方法:三层脚手架 + 一个诊断 #
这是 survey / position paper,「方法」= 一套分类学 + 一个规范性立场。三层的排列顺序对应 code 进入 agent loop 的先后:
Layer 1 — Harness Interface(§2):code 作为模型与环境之间的介质。作者论证 code 的三个性质是功能性的而非记法性的——executable 意味着 harness 能验证模型意图;inspectable 意味着失败可被诊断并回灌;stateful 意味着交互历史不会在步与步之间丢失。同时钉死了 code 的非隐喻边界:程序、脚本、形式规范、证明脚本、API schema、工具定义、测试、仓库、模拟器、配置文件,以及由可执行系统产生 / 消费的 trace 和 log 都算 code;而原始感知、物理状态、人类意图、模型内部隐式推理不是 code——它们可以被 code 序列化、估计、验证或作用,但不能被混为一谈。
Layer 2 — Harness Mechanisms(§3):五个控制面 —— planning(轨迹控制)、memory & context engineering(状态管理)、tool use(受治理的动作/观测层)、PEV loop(Plan–Execute–Verify 控制回路)、Agentic Harness Engineering(对 harness 本身的测量与改写)。其中 PEV 是把前三者缝成一个闭环的统一框架:plan 阶段产出一份关于下一次状态转移的 contract(涉及哪些文件、要保持什么不变量、用什么命令验证、回滚点在哪、哪些操作有风险),execute 阶段在 sandbox + 权限分层里执行,verify 阶段用确定性传感器和人审 gate 判定状态是否可接受。
Layer 3 — Scaling(§4):从单 agent 扩到多 agent,共享的 code artifact 成为协调、评审、验证的公共工作台。
核心技术壁垒(详见 §7):把 §4.1–§4.2 三张表的 Harness Substrate 列当作一个分布来读,而不是当作一份清单——由此得出「多数文献停留在 implicit / file-only」的中心 gap,再把三个看似无关的现象(implicit convergence 最盛行、拓扑复杂度反而更高、context 管理机制层出不穷)全部归因到同一个缺失的抽象上。这个诊断动作本身,而不是分类学,是本篇不可替代的部分。
Q3 — 结果:一个立场,加一串自我削弱的证据 #
作者的新立场是 shared code-centric harness substrate:程序是多智能体领域里唯一「会执行」的产物,它产生客观的、非语言的信号,原则上足以锚定一个形式化的共享底座;但绝大多数系统在架构层面没有利用这个性质,反而让 agent 用自然语言去揣测代码质量。
诚实之处在于,作者同时把削弱自己论点的证据摆了出来:QualityFlow 的 Imagined Execution(LLM 逐步模拟 Python 解释器、不真跑代码)在 MBPP 上达到 98%+ precision / recall;Self-Collaboration 的模拟 tester 与真编译器 ablation 表现几乎一致。作者称之为「a provocative empirical question」,并没有把它压下去。最终的处方是分流:语言推理走快路径,执行只在语言模拟结构上想象不出的失败模式(runtime crash、资源耗尽、边界条件、性能回退)上作为验证 oracle。
3. 架构 / 方法图 #
3.1 全局分类学 #
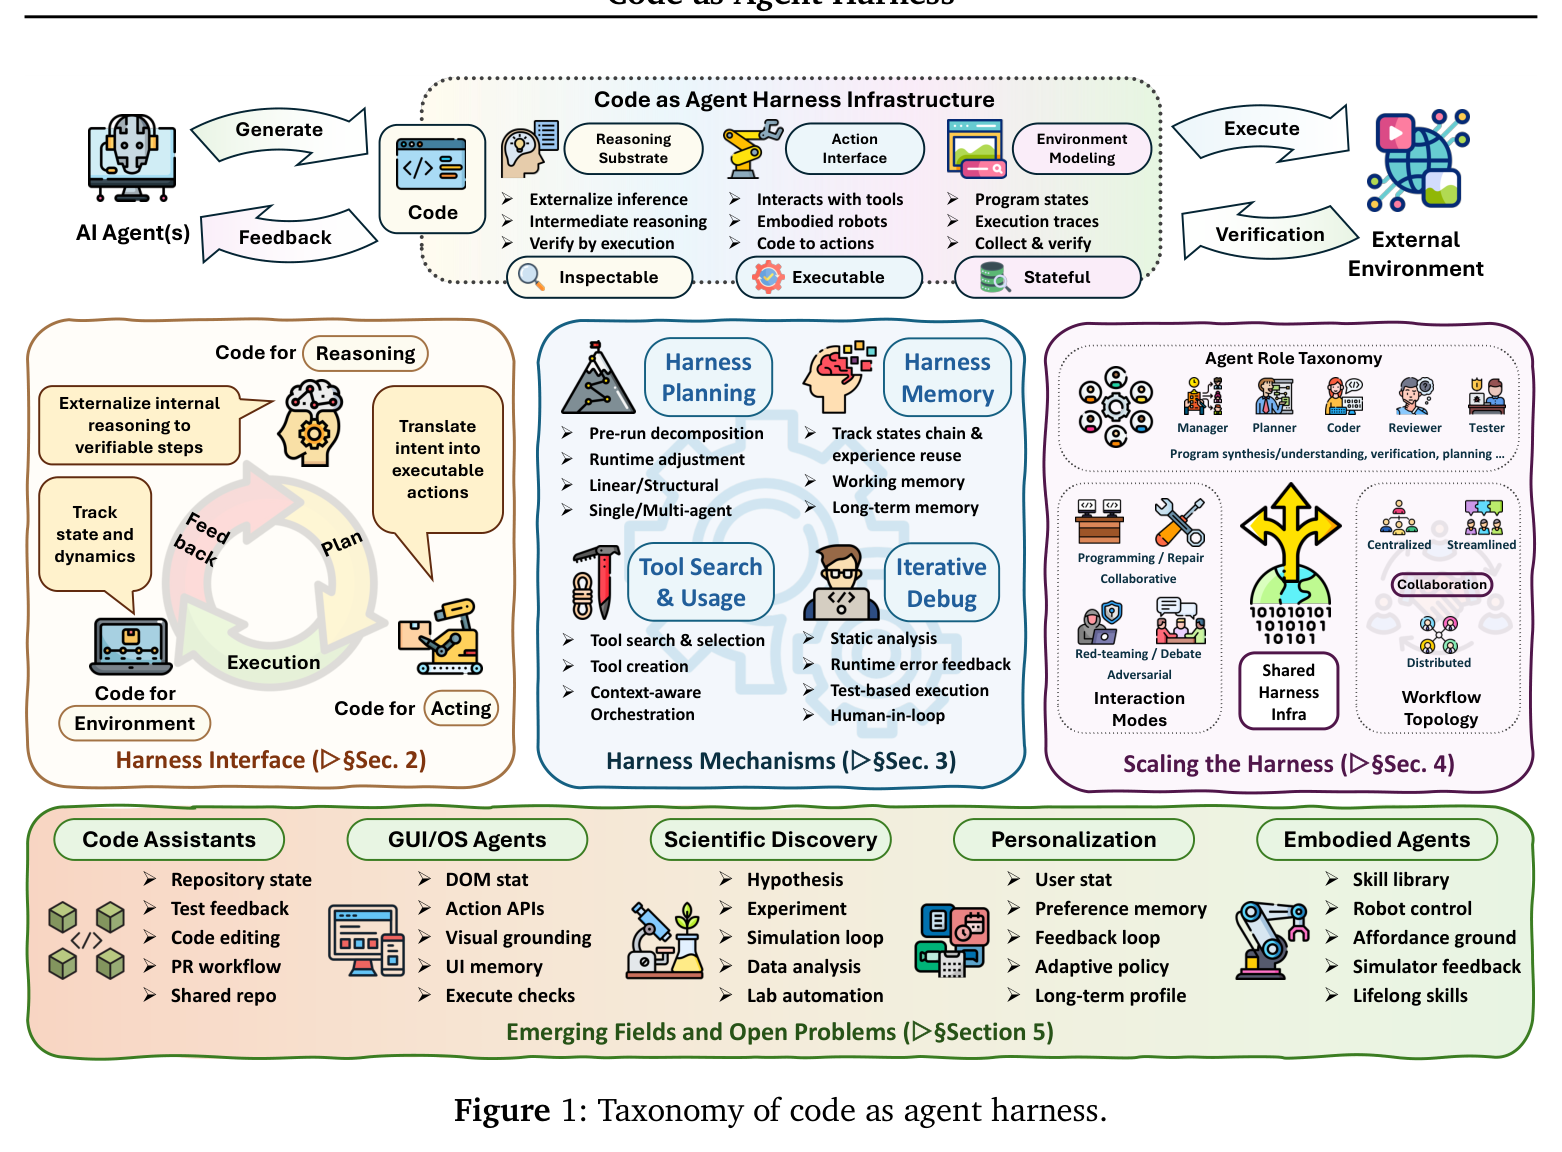
Paper 的 Figure 1(caption: "Taxonomy of code as agent harness.")。
这是一棵分类树而非曲线图,三条主干与 §2 / §3 / §4 一一对应。值得注意的是树的形状本身在传达论证顺序:interface 在最前(code 先要能进入 loop),mechanisms 在中间(进来之后要能撑过单步),scaling 在最后(撑住了才谈多 agent 共享)。
3.2 Layer 1:code 作为 harness 接口 #
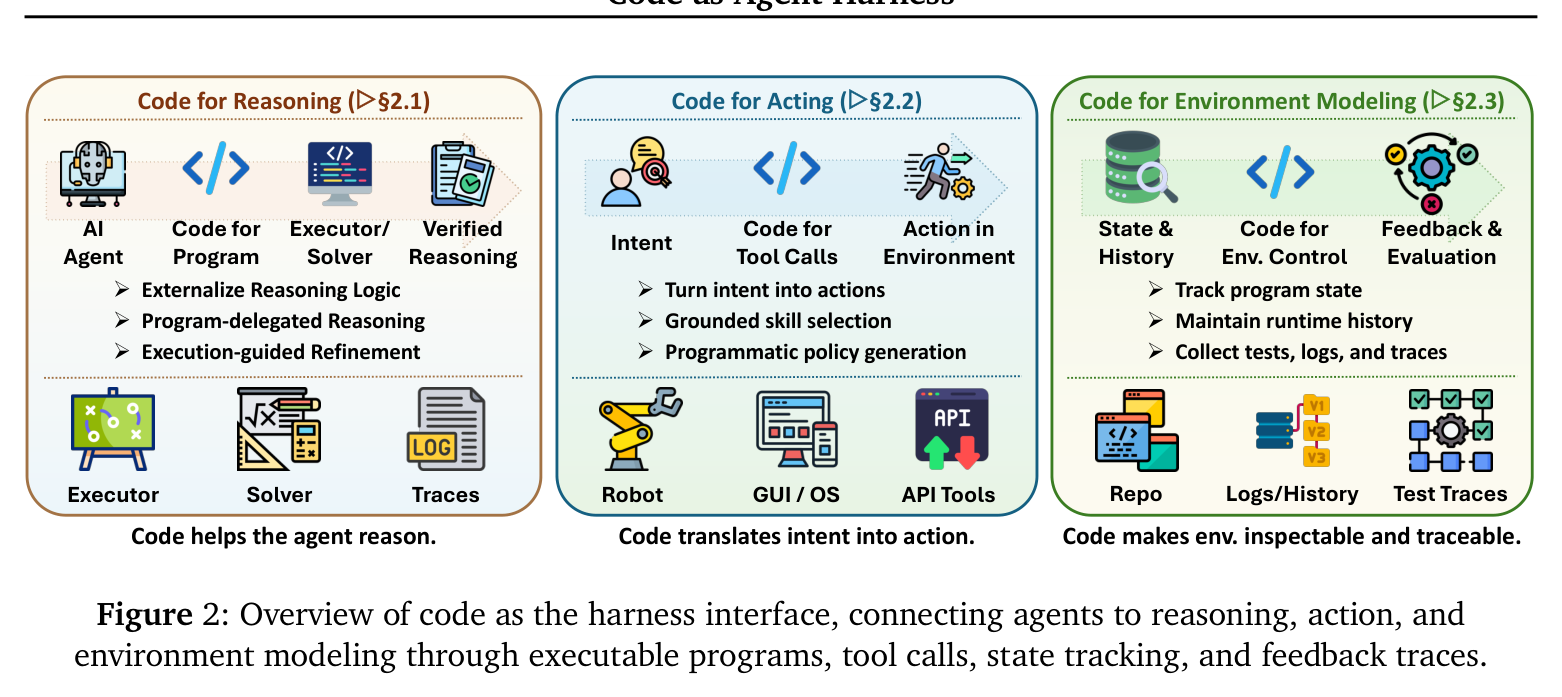
Paper 的 Figure 2(caption: "Overview of code as the harness interface, connecting agents to reasoning, action, and environment modeling through executable programs, tool calls, state tracking, and feedback traces.")。
三栏分别是 §2.1 / §2.2 / §2.3。读这张图要看每栏底部那行小字——它们是三种角色各自的验证方式:「Code helps the agent reason」靠 Executor / Solver / Traces,「Code translates intent into action」靠 Robot / GUI-OS / API Tools,「Code makes env. inspectable and traceable」靠 Repo / Logs-History / Test Traces。作者在 §2.2 特意指出中间这栏的困难与左栏本质不同:reasoning 里解释器能直接判对错,acting 发生在部分可观测、动态演化的环境里,失败可能表现为无效状态转移、延迟反馈或静默执行错误——机器人去抓一个够不着的物体,不会抛任何 runtime exception。
3.3 Layer 2 的控制回路:PEV #
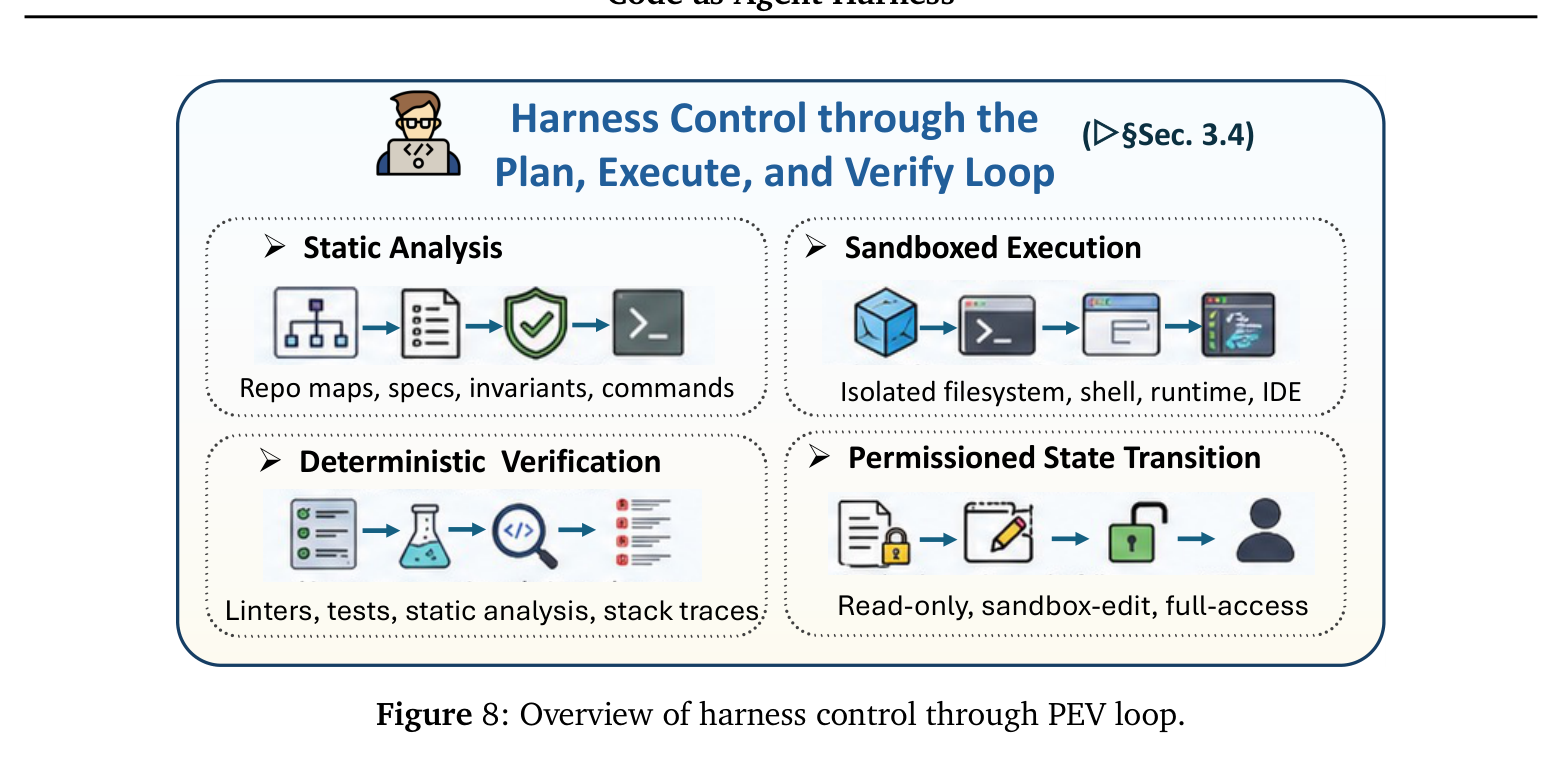
Paper 的 Figure 8(caption: "Overview of harness control through PEV loop.")。
四个象限对应 §3.4.1–§3.4.4:Static Analysis(repo maps, specs, invariants, commands)→ Sandboxed Execution(isolated filesystem, shell, runtime, IDE)→ Deterministic Verification(linters, tests, static analysis, stack traces)→ Permissioned State Transition(read-only / sandbox-edit / full-access)。右下角那三级权限是全篇少数几个可以直接照搬进工程实现的东西:read-only 层做仓库浏览、检索、静态检视、日志分析;sandbox-edit 层做局部打补丁、跑测试、临时装依赖;full-access 层覆盖网络访问、凭证、部署命令、发包、破坏性文件操作、Git 历史改写——最后一层必须挂强制 HITL gate,因为它的后果会溢出 sandbox。
作者把 harness 类比为 cybernetic governor:一个观察 agent 动作后果、并据此调节后续状态转移的控制层。它不是把错误信息转发给模型,而是通过 linter / parser / compiler / type checker / unit test / integration test / static analyzer / fuzzer / runtime monitor / CI 这一组确定性传感器观察仓库和执行环境,把轨迹变成 pass/fail、诊断、失败 trace、覆盖率缺口、安全告警、资源上限、策略违规这些可检视信号,然后在「继续执行 / 修补丁 / 要更多上下文 / 转交别的模块 / 降权限 / 升级给人」之间做决策。
一轮 PEV 的状态机形态:
(read set / write set / invariants /
validation commands / rollback point) Execute --> Verify : 在 sandbox + 权限层内
完成有界状态转移 Verify --> Accept : 所有必需检查通过 Verify --> Plan : 传感器证据指向计划错误
(缺依赖 / 定位错误 / 违反约束) Verify --> Execute : 局部重生成补丁 Verify --> Escalate : 风险层级上升 or 证据不足 Escalate --> Plan : 人审给出新约束 Escalate --> [*] : 人审否决 / 回滚 Accept --> [*] note right of Verify 终止由验证决定,不由模型置信度决定: 检查通过 / 再试也不改善 / 风险层级变化 / 需要人审 end note
这张状态机里有两条作者反复强调的边。第一,Verify --> Plan 的存在就是他们主张「planning 与 debugging 不能分开」的理由——失败的验证会更新计划,而计划决定了哪些验证证据是有意义的。第二,repair / reflection / termination 都是 Verify 的后果而非独立阶段;reflection 只有在锚定于可执行证据时才可靠,agentic critique 应当解读传感器输出而不是替代它。
3.4 Layer 3:多智能体扩展 #
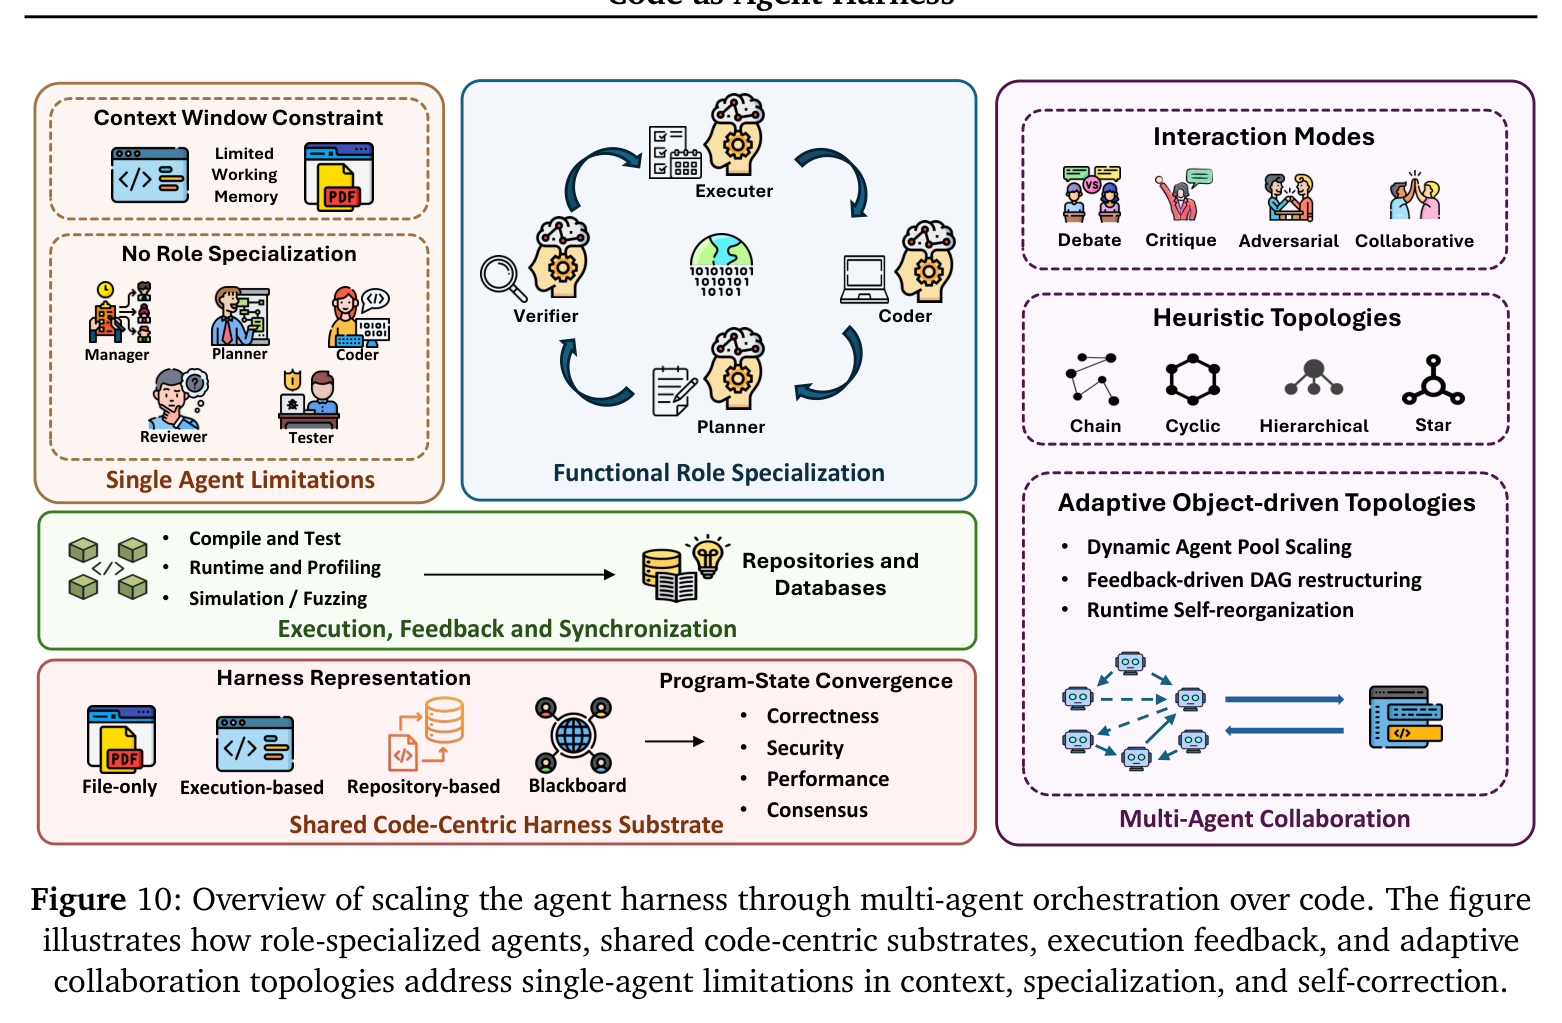
Paper 的 Figure 10(caption: "Overview of scaling the agent harness through multi-agent orchestration over code. The figure illustrates how role-specialized agents, shared code-centric substrates, execution feedback, and adaptive collaboration topologies address single-agent limitations in context, specialization, and self-correction.")。
左上角列出三条单 agent 限制(context window 装不下整个 codebase + 交互历史 + 执行 trace;一个通才 agent 同时做规划/合成/测试/评审/调试效率低;缺少独立的协调与验证通道导致无法可靠自查),右侧是应对:四种交互模式(Debate / Critique / Adversarial / Collaborative)、四种启发式拓扑(Chain / Cyclic / Hierarchical / Star)、三种自适应拓扑(动态 agent 池扩缩 / 反馈驱动 DAG 重构 / 运行时自组织)。
左下角那块红色区域是全篇的诊断落点:Harness Representation 的四个层级——File-only / Execution-based / Repository-based / Blackboard,以及它们各自导向的 Program-State Convergence 判据(Correctness / Security / Performance / Consensus)。作者要论证的是:绝大多数系统落在最左边的 File-only,而右侧那些花哨的自适应拓扑,是缺少形式化底座之后的代偿而非进步。
4. 作者证明 #
无形式化作者证明 — 仅实证;且实证亦非自有数据。
本篇 0 个编号显示公式、0 个自有实验、0 个 ablation、0 个自己跑出的 baseline 对比;正文所有数字都归属于被引文献。全部形式化记号都是从被引系统借来的。因此这一节做两件事:把借来的记号说清楚,然后对作者推理链本身做检查。
4.1 记号表(全部借自被引系统) #
| 记号 | 出处 | 含义 | 为什么 load-bearing |
|---|---|---|---|
| $S_k$ / $B_k$ | SyncMind(§4.3.1) | 第 $k$ 步的仓库真值状态 / agent 的信念状态 | 把「agent 悄悄基于过期快照工作」从不可见 bug 变成可监控量;本篇关于状态的中心论断的唯一形式化支点 |
| $\lvert B_k - S_k \rvert$ | SyncMind(§4.4 Trend 7) | 信念偏离的标量摘要 | 用幅度而非 stale/fresh 布尔量,才谈得上「测量」与「同步协议」 |
| $s(r) = 1 - m(r)/tc(r)$ | MAGE(§4.3.2) | 候选程序 $r$ 的仿真失配分数,$m$=失配数,$tc$=测试用例数 | 全篇唯一的代数公式;score-based convergence 类的具体停机判据 |
| $D$ | L2MAC(§4.2.2) | 外部持久 file store,「never overwritten but extended and revised」 | 因为不覆盖写,它同时是版本历史,Control Unit 才能给每次 fresh-context 调用切出精确的一片 |
| $M_{rs}$ | L2MAC(§4.2.2) | 交给每次新 agent 调用的既往进度摘要 | 完整对话史的压缩替身;fresh-context agent 链能成立的关键(状态住在 $D$,$M_{rs}$ 是指针加摘要) |
| $E(D)$ | L2MAC(§4.2.1) | evaluator 模块作用于整个 file store | 作用对象是全库而非单个 snippet,所以语法失败能阻塞整条指令流水线而不只是标注一个文件 |
| $M$ | MAGIS(§4.2.2) | 仓库演化记忆,file version → LLM 摘要的 KV store | 键是文件版本而非路径,才能跨 issue-resolution episode 用 git diff 增量更新 |
| $\langle \mathcal{S}, \mathcal{A}, \mathcal{O}, T, R \rangle$ | §5.1.2 GUI/OS | 部分可观测 MDP;$\mathcal{S}$ 是进程完整程序状态,$\mathcal{A}$ 本身就是代码 | 作者的关键一步是 $T$「is not learned but executed」——浏览器引擎 / Android runtime / 宿主 OS 就是转移函数 |
| $\pi(a \mid h)$ | §5.1.2 | 给定历史 $h$ 的策略 | 被重读为「a program synthesizer that emits the next snippet of executable code; the environment is the interpreter」 |
4.2 最小检查 #
Check 1 — $s(r)$ 的边界行为自洽。 $m(r)=0 \Rightarrow s(r)=1$,$m(r)=tc(r) \Rightarrow s(r)=0$。§4.3.2 描述的停机规则「continues iterating until the maximum score reaches 1.0」因此等价于零观测失配,不是一个宽松阈值。这一点作者没写,但公式与停机语句是一致的。
Check 2 — $s(r)$ 的归一化有未讨论的副作用。 用比率而非绝对失配数,好处是不同 $tc$ 下的候选可比;代价是一个只被 2 条用例测过且 0 失配的候选,与被 100 条用例测过且 0 失配的候选得分完全相同(都是 1.0)。当 $tc(r)$ 随候选变化时,$s$ 并不单调反映真实正确性。作者引用该公式时未讨论这一点。
Check 3 — $\lvert B_k - S_k \rvert$ 的量纲未定义。 仓库状态是离散结构(文件树 + 内容 + 版本),论文没有给出 $S_k$ 所处的度量空间,因此绝对值号在此是隐喻性的。SyncMind 实际报告的是 out-of-sync recovery 类指标。本篇原样沿用了符号而没有补上度量定义——考虑到这是全篇关于状态的唯一形式支点,这是个可被追问的薄弱处。
Check 4 — 三处属性列表互不一致。 标题承诺 executable / verifiable / stateful;§2 para 2 论证的是 executable / inspectable / stateful;§5.2.7 收尾给出四条 executable / inspectable / stateful / governed。verifiable 被静默换成了 inspectable 与 governed,全篇未做说明。这不是笔误级别的问题:verifiable 与 inspectable 在作者自己的框架里恰恰是两件事(§5.2.2 的整节就在论证「有可执行反馈 ≠ 验证充分」)。
Check 5 — 中心 gap 缺少可证伪的计数。 「the majority of the literature resides in the implicit/file-only category」是全篇最重的经验主张,但没有给出任何计数或百分比。可核对的证据只有 Implicit/File-only 子块里点名的 7 个系统(ChatDev、MetaGPT、FlowGen、MapCoder、CodeCoR、SEW、CodePori),加上 Table 9/10/11 的 Harness Substrate 列(合计约 25 个系统,且三表有重叠)。读者要自己去数,而分类边界(例如「Execution, implicit」算哪一类)由作者定义。
Check 6 — Trend 5 的因果方向被作者主动弱化。 「拓扑复杂度与 harness 状态形式化程度反相关」的证据是:L2MAC(最清晰的形式化底座)用最简单的顺序链;EvoMAC / SEW(隐式状态)发展出复杂自适应 DAG。样本 $n=4$,且是相关性观察。作者用的措辞是「topology complexity is partially a symptom」——已经把因果强度调低了,这个自我限制是诚实的。
Check 7 — Trend 3 是对自身论点的反向证据,作者承认但未量化。 98%+ 的 imagined-execution 精度直接冲击「可执行反馈是差异化优势」这一核心论点。作者的化解是「执行反馈的价值在各失败模式上不均匀」,并列举了语言模拟结构上想象不出的四类(runtime crash / 资源耗尽 / 边界条件 / 性能回退)。但这四类在真实失败分布中占多大比例,全篇没有任何数据。处方(快路径 + 按需 oracle)因此是合理的猜想而非被证实的结论。
可以被界定但作者没做的量:给定四个表征层级和六种收敛判据,完全可以报告一个 systems × representation-level 的列联表,以及「实现 X 层级表征的系统在 Y 判据下的收敛率」。这是把中心 gap 从修辞变成可证伪主张所需的最小工作量,本篇没有做。
5. 实验与数据 #
本篇没有实验。 作者自己没跑任何 baseline、ablation 或 sweep。功能上等价于「实验」的产物是 §4.1–§4.4 对约 25 个多智能体系统沿统一维度的表格化拆解——中心 gap 与七条 trend 全部是从这几张表的列上读出来的。因此这一节展示的是表本身,以及本篇转述的(全部有出处的)数字。
5.1 PEV 控制面的实例分布 #
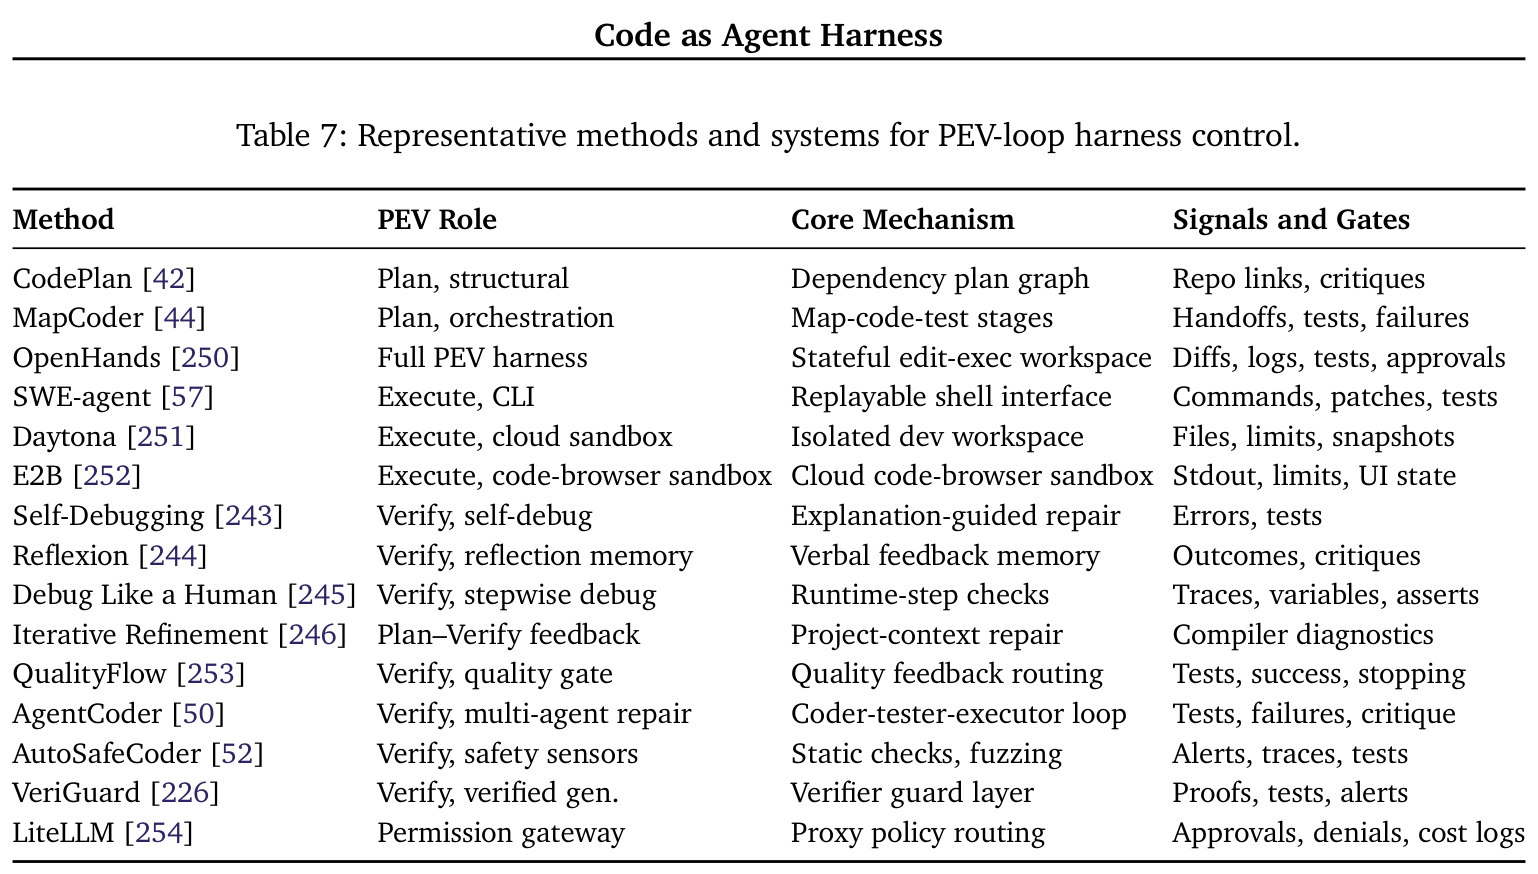
Paper 的 Table 7(caption: "Representative methods and systems for PEV-loop harness control.")。
15 行里有两个信息量很大的观察。第一,只有 OpenHands 一行被标为「Full PEV harness」——即便在作者自己挑选的代表性集合里,端到端覆盖 Plan+Execute+Verify 三段的系统也只有一个。第二,Verify 角色占了 15 行中的 8 行:研究注意力压倒性地集中在「怎么判对错」,而 Plan(2 行)与 Execute(3 行)相对稀疏;唯一的 Permission gateway 行是 LiteLLM,一个生产网关而非研究系统。这条分布本身支撑了 §5.2.5「安全治理原语在实践中仍然罕见」的判断。
5.2 多智能体协作设计的三轴拆解 #
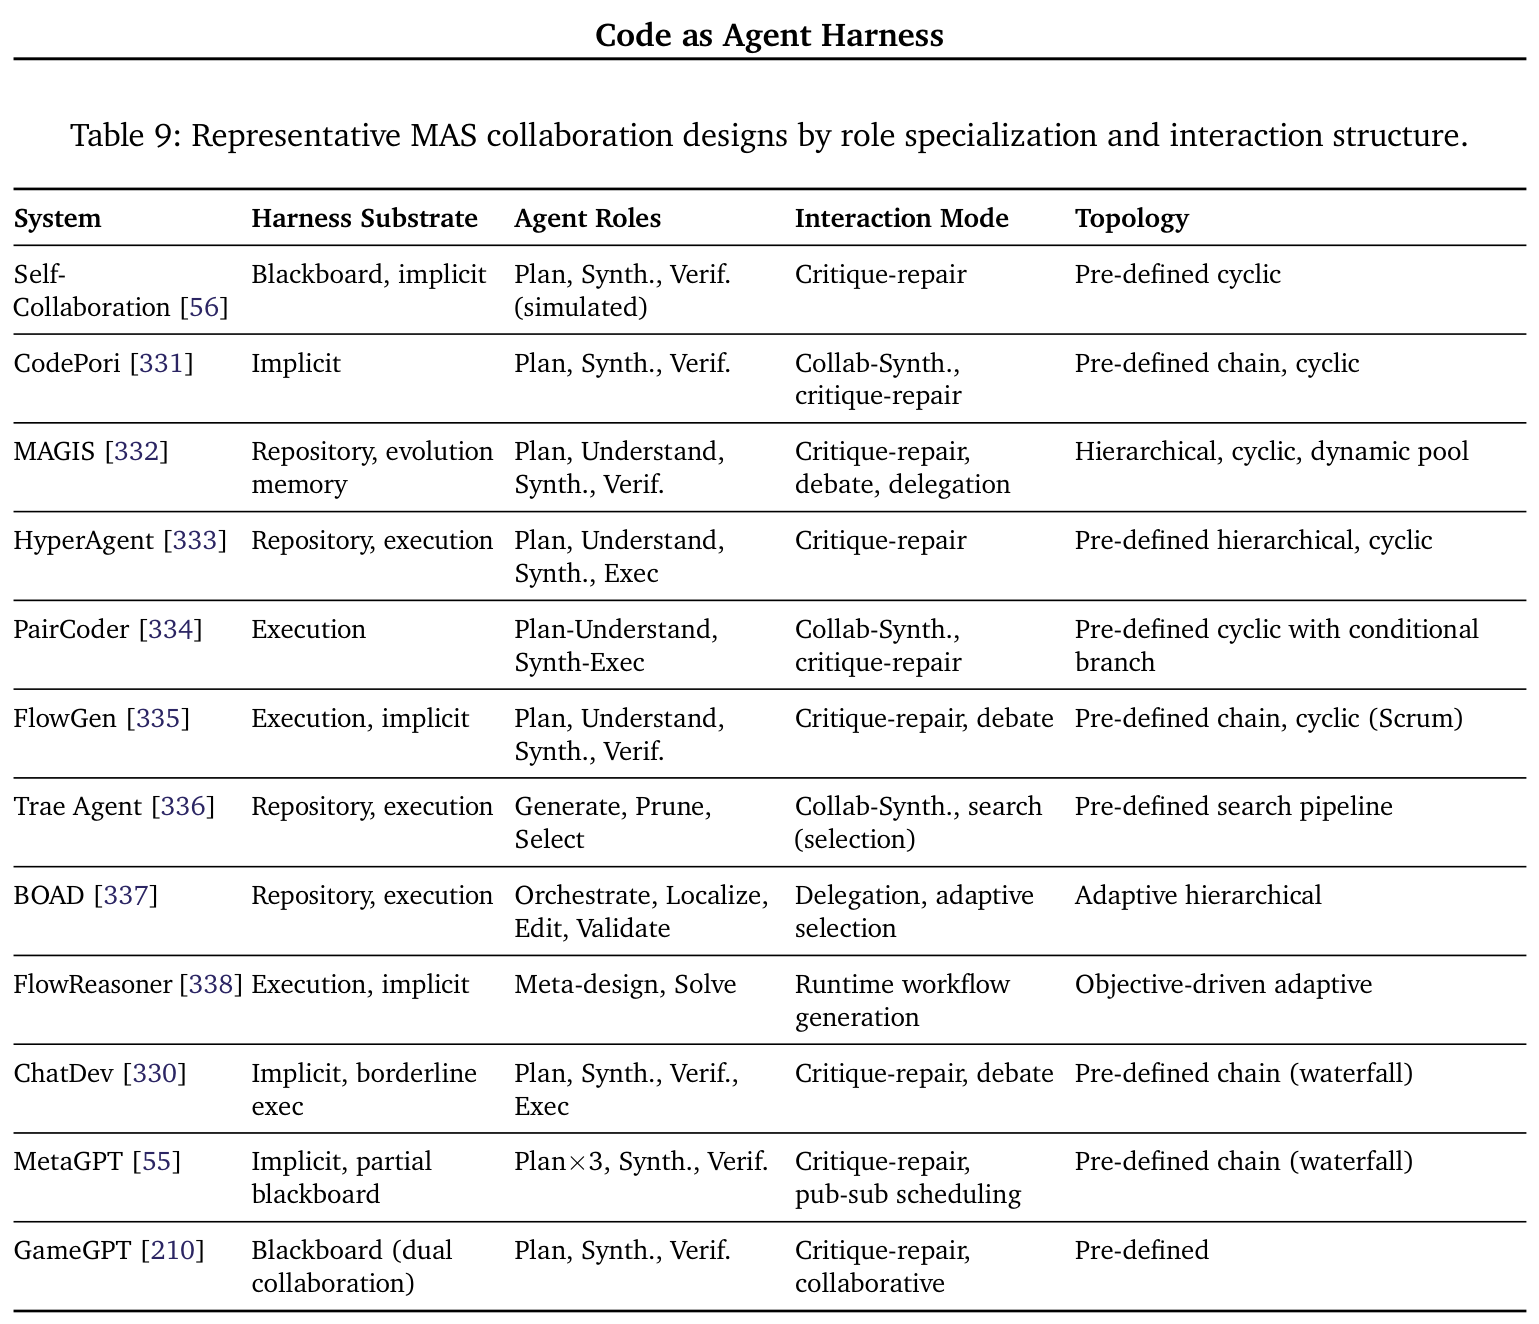
Paper 的 Table 9(caption: "Representative MAS collaboration designs by role specialization and interaction structure.")。
要看的是 Interaction Mode 这一列:12 行里有 11 行含 "Critique-repair"。作者在 §4.1.2 断言 critique-and-repair 是主导交互模式——这个断言可以直接从这一列数出来,是全篇少见的「结论可从表面直接核对」的例子。相比之下 Collaborative synthesis(真正的双 agent 共同构造,如 PairCoder 的 Navigator–Driver、CodePori 的 Dev_01/Dev_02)明显稀少,作者的解释是多数系统偏好顺序交接而非共同构造。
5.3 执行反馈与收敛判据 #
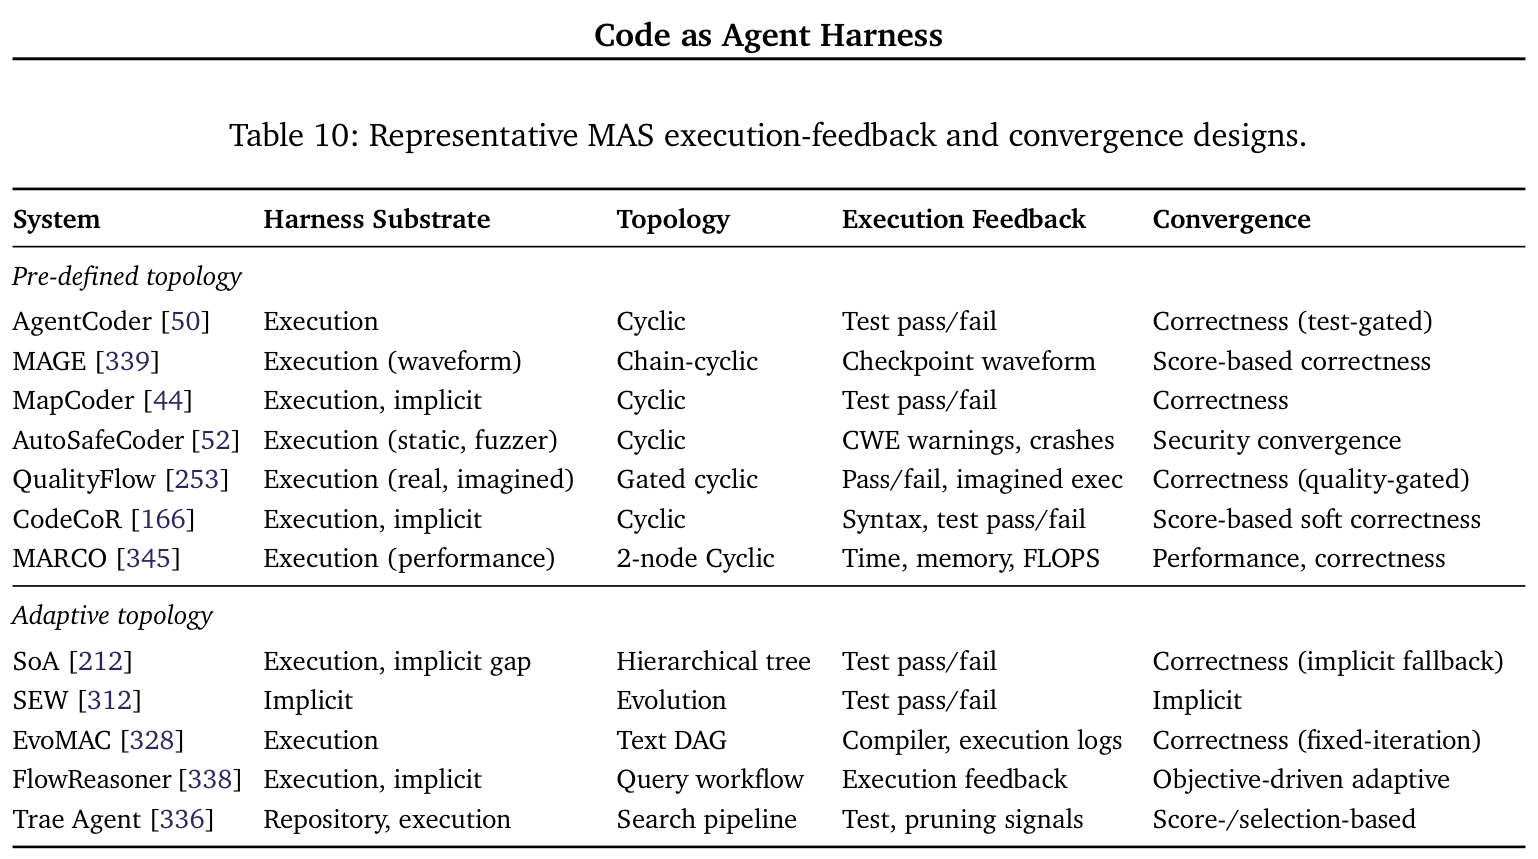
Paper 的 Table 10(caption: "Representative MAS execution-feedback and convergence designs.")。
表被显式分成 Pre-defined topology 与 Adaptive topology 两段。关键看 Convergence 列的措辞分布:SEW = "Implicit",SoA = "Correctness (implicit fallback)",EvoMAC = "Correctness (fixed-iteration)"——自适应拓扑那一段恰恰是收敛判据最弱的一段。这正是 §4.4 Trend 5 的表格证据:拓扑越花哨,底层状态表征越弱。
本篇转述的执行反馈相关数字(全部归属被引工作):
| 数字 | 出处 | 含义 |
|---|---|---|
| 98%+ precision / recall on MBPP | QualityFlow | LLM 逐步模拟 Python 解释器预测测试结果,不真跑代码 |
| 75–84% 问题在首次生成后即退出 | QualityFlow | 单一 quality checker 同时充当收敛 oracle 与系统控制器 |
| 5 iterations | AgentCoder | programmer → test executor → programmer 循环上限 |
| $n=4$ iterations | Self-Collaboration | tester 始终不批准时的隐式收敛回退 |
| 10 rounds | ChatDev | 固定轮次终止,无客观质量判据 |
| clock-edge 粒度 | MAGE | State Checkpoint 记录每个时钟沿信号值,交给 Debug Agent 首个失败时钟周期附近的波形窗口——被称为全文献最细粒度反馈 |
5.4 共享程序状态表征 #
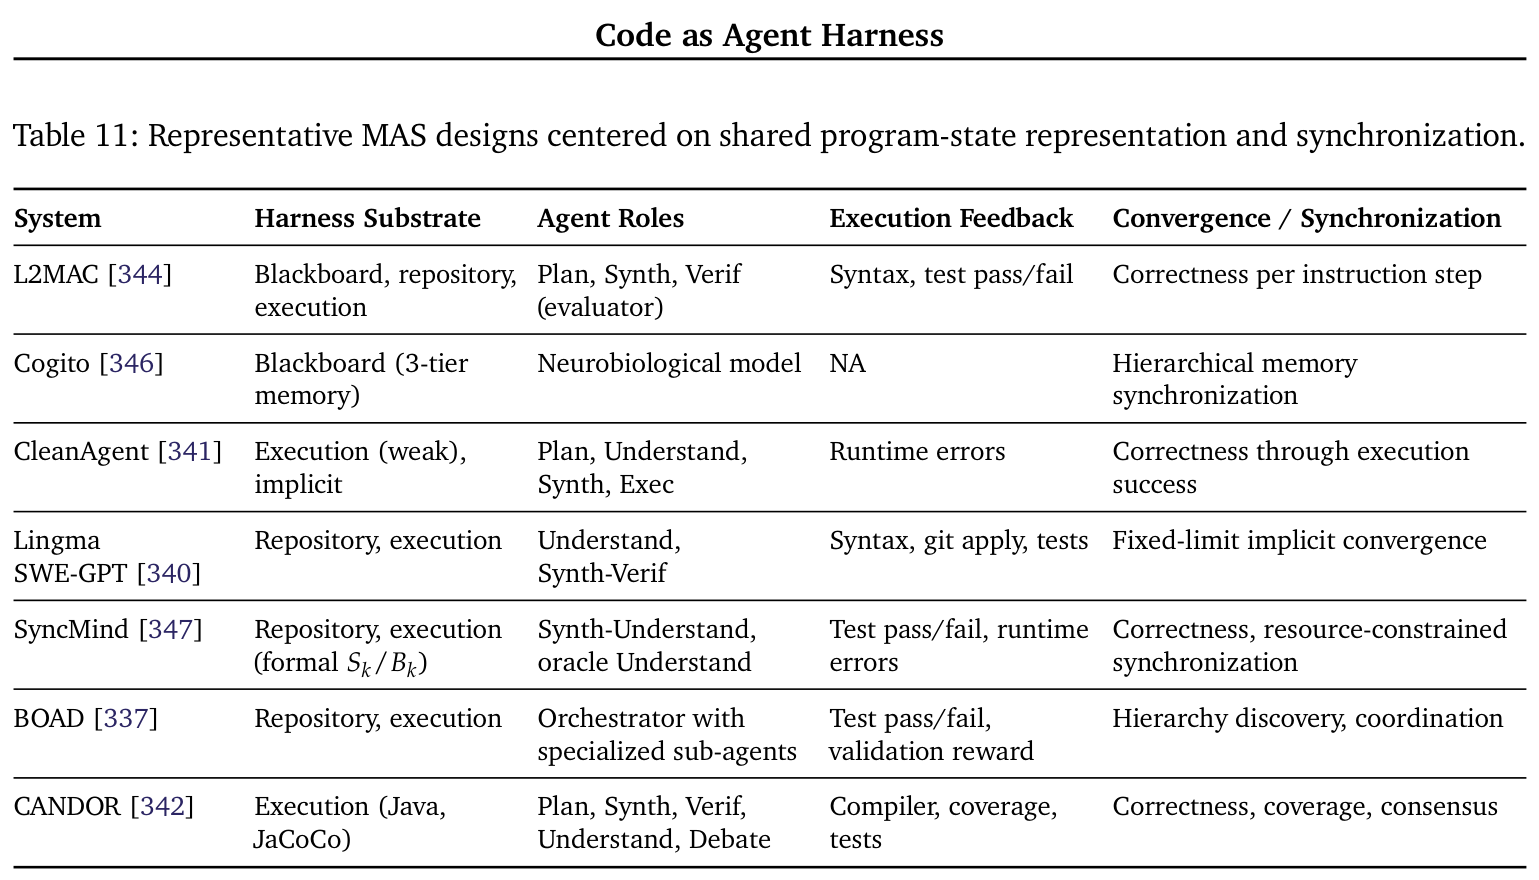
Paper 的 Table 11(caption: "Representative MAS designs centered on shared program-state representation and synchronization.")。
7 行里,只有 SyncMind 一行的 Harness Substrate 单元格带形式记号(印作 Repository, execution (formal $S_k/B_k$))。一篇论文,在 478 条参考文献里,撑起了本篇关于状态的全部形式化根基。Cogito 是唯一 Execution Feedback = NA 的行——三层记忆架构再精巧,没有执行反馈就没有客观收敛判据,这一行本身就是中心 gap 的一个实例。
5.5 落地域与生产侧数字 #
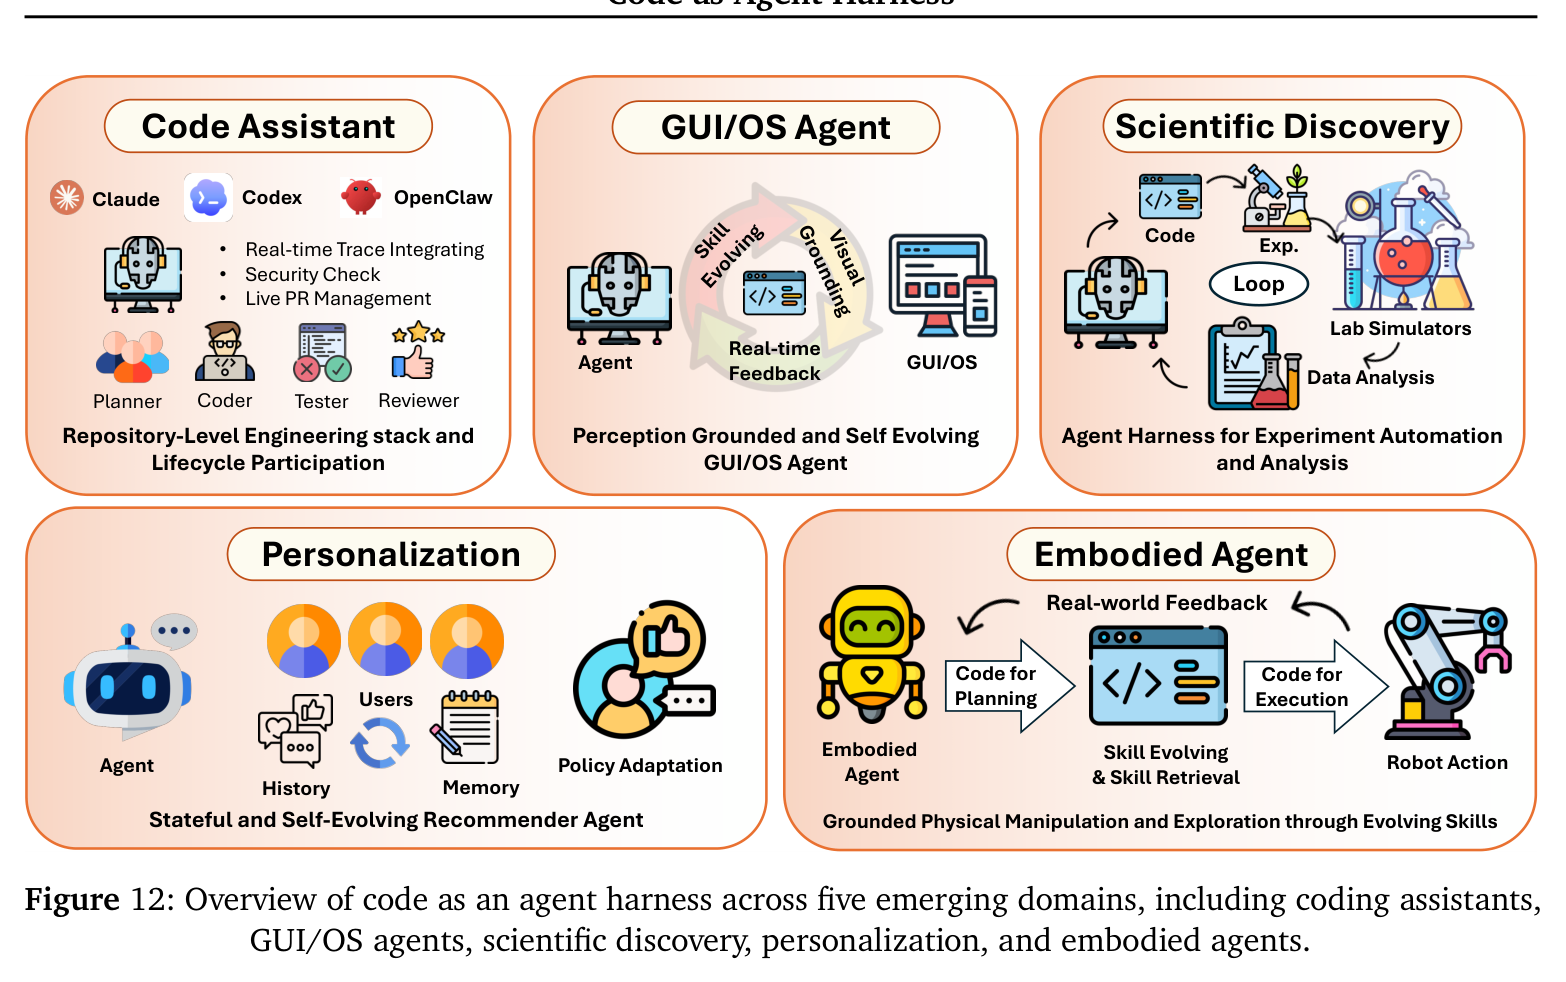
Paper 的 Figure 12(caption: "Overview of code as an agent harness across five emerging domains, including coding assistants, GUI/OS agents, scientific discovery, personalization, and embodied agents.")。
注意 abstract 承诺了七个应用领域(含 DevOps 与 enterprise workflows),而这张图与整个 §5.1 只覆盖五个;DevOps 自始至终没有获得独立章节。
生产与评测侧转述的数字:
| 数字 | 出处 | 为什么值得记 |
|---|---|---|
| 16.9% 完全自主 / 43.3% 需人工介入 | LingmaAgent @ 阿里云 in-house issue | 目前公开的生产级 issue-resolution 自主率参照点 |
| 14–53% 最佳 step-level 失败归因准确率 | 四项专门研究/数据集 | 遥测机制堆了这么多,仍无法可靠指出长轨迹中是哪一步坏的 |
| SWE-bench 上具竞争力且不需要复杂 agentic 控制 | Agentless | 直接削弱「harness 越精巧越好」的叙事 |
| OSWorld 369 任务 / AndroidWorld 116 / WebShop 1.18M 商品 / WorkArena 23,150 实例 | GUI/OS 基准群 | 支撑「环境动力学被写成代码,因而可 fork、可 diff、可版本控制、可复现」 |
| A-Lab 17 天无人值守合成 41/58 目标无机化合物 | A-Lab | 一篇代码/agent 综述里出现的物理世界结果 |
6. 论证链 #
| # | 命题 | 依据(篇内) | 强度 |
|---|---|---|---|
| 1 | agent 自主性的瓶颈不只在基座模型,也在把模型输出连到长程动作与持久状态的那层系统 | §1 para 2 的 harness 定义 + 7 条引用;无实验 | 断言 + 引用;构成全篇前提 |
| 2 | code 是这层介质的正确答案,因为它同时 executable / inspectable / stateful,且这三条是功能性而非记法性属性 | §2 para 2:executability → harness 能验证模型意图;inspectability → 失败可诊断并回灌;statefulness → 交互史不丢 | 概念论证,可反驳但自洽 |
| 3 | 单步之外的可靠性需要五个控制面(planning / memory / tools / PEV / AHE),且它们是协调的控制面而非可插拔模块 | §3 para 1–2;每个控制面各配一节 + 一张表 | 分类学,靠覆盖度而非证据支撑 |
| 4 | PEV 把 planning、execution、debugging、verification、escalation 统一为一个harness 级控制过程;终止应由验证而非模型置信度决定 | §3.4.1–§3.4.4;Table 7 的 PEV Role 列 | 框架整合;Table 7 显示实际只有 1 个系统覆盖全循环 |
| 5 | 把 agent 扩到多 agent 后,防御性设计必须靠共享 artifact,而非消息传递——code-centric MAS 的定义性特征是 artifact-mediated communication | §4.1.2;Table 9 的 Interaction Mode 列(12 行中 11 行含 critique-repair) | 可从表面直接核对 |
| 6 | 多数系统落在 implicit / file-only 表征层级,缺少任何形式化的共享 harness 底座 | §4.3.1 The Central Gap;点名 7 个系统 + Table 9/10/11 的 Harness Substrate 列 | 无计数、无百分比;需读者自行统计 |
| 7 | 由 #6 直接推出:implicit convergence(固定轮次停机、无质量判据)之所以最盛行,是因为没有客观的程序状态表征就没有原则性的收敛判据 | §4.3.2 Implicit convergence;ChatDev 10 轮、MetaGPT 固定 SOP、Self-Collaboration $n=4$、EvoMAC 固定 $K$ | 因果链清晰,但仍是从少量例子推全域 |
| 8 | 同样由 #6 推出:复杂自适应拓扑与繁复的 context 管理机制都是代偿而非进步——L2MAC 有最清晰的形式底座却用最简单的链式拓扑 | §4.4 Trend 5、Trend 6 | $n=4$ 的相关性观察;作者用「partially a symptom」自我弱化 |
| 9 | 但可执行反馈的价值并不均匀:LLM 模拟执行可达 98%+ 精度,故成熟 harness 应以语言推理为快路径、仅在特定失败模式上调用执行 oracle | §4.2.1、§4.4 Trend 3;QualityFlow + Self-Collaboration | 自我削弱证据;作者承认但未量化失败模式分布 |
| 10 | harness 本身应成为被测量、被演化、被治理的对象(AHE);但 harness 变更必须当作对安全关键 runtime 的改动来管——每次变更携带 change contract | §3.5.1–§3.5.3、§5.2.3;Evolution Agent 的五阶段循环递归受 PEV 约束 | 规范性主张;反例(新检索策略提升准确率却增加幻觉证据等三个「反常改进」)由作者自己给出 |
| 11 | 终局:下一代系统要同时 executable / inspectable / stateful / governed | §5.2.7 para 2 | 与标题承诺的三属性不一致(见 §4 Check 4) |
7. 实现 cross-reference #
7.1 代码可得性 #
[实现未公开] —— 本篇是 survey / position paper,没有可运行的方法实现。唯一的配套产物是一份论文清单仓库 https://github.com/YennNing/Awesome-Code-as-Agent-Harness-Papers(arXiv comment 中给出),不含系统代码、不含复现脚本、不含基准。全篇 12 图 11 表 478 条引用、无附录、无补充材料。
因此「实现」的落点在被引系统上:作者反复用作正面范例的是 L2MAC(最有原则的 blackboard 实现)、SyncMind(唯一的形式化状态模型)、OpenHands(Table 7 中唯一被标为 Full PEV harness 的系统)、AgentCoder(执行接地的 MAS 范式)。
7.2 核心技术壁垒 #
最难复制的不是三层分类学——分类学任何人读完 478 篇都能画出一个版本。真正难的是把 Harness Substrate 这一列当成一个分布来读这个动作,以及随之而来的三重归因收束。
具体说:作者先把约 25 个多智能体系统按 Harness Substrate / Agent Roles / Interaction Mode / Topology / Execution Feedback / Convergence 六个维度拆成 Table 9/10/11——这个粒度是刻意的,不是描述性的。然后不去逐系统评优劣,而是回头统计这些列的取值分布,得出「多数落在 implicit / file-only」。最后——这一步才是壁垒——把三个表面上毫不相干的现象全部归因到同一个缺失抽象上:
这个「三症一因」的收束要求先以正确的粒度建好表,再抵住逐系统点评的诱惑。它无法从任何单篇被引论文里读出来,只能从横向比较中浮现——这是本篇不可替代的部分,也是它作为 position paper 而非 literature list 的全部价值所在。
副产品是一个可直接使用的诊断问题:看一个多智能体编码系统,先问「它的共享程序状态是什么,agent 能不能查询它」——如果答案是「最近一次对话上下文里的那份代码」,那么它后续所有的拓扑创新与 context 工程都应被读作代偿而非进步。
7.3 关键实现细节 #
三个容易被读过去但直接决定系统行为的点:
(1)AgentCoder 的 Test Executor 不是 LLM,是一个确定性 Python 脚本。 作者把这一点单独拎出来作为该设计的关键属性——在一篇讲 LLM agent 的综述里,承重构件是一段普通脚本。它干净地把推理与执行分开,让反馈信号锚定在客观程序行为上。与之配套的是 Test Designer 独立于代码生成测试,针对的是 mode collapse:agent 有偏的测试会放过它自己有 bug 的代码。QualityFlow 的 Test Quality Checker 把这个防护提到元层(在合成测试被当作反馈使用之前先过滤它们),CANDOR 的 Panelists 则对着自然语言规范而非代码审计 oracle 正确性,刻意避免被错误实现污染。
(2)L2MAC 靠「不覆盖写 + 精确切片」解决 context 问题,而不是靠扩大窗口。 file store $D$ 永不覆盖、只扩展和修订,因此天然是一份版本历史;Control Unit 在指令步之间重置上下文窗口,给每次新调用的是既往进度的定向摘要 $M_{rs}$ 而非完整对话史;接近容量时把部分结果写回 $D$ 并以压缩视图重新初始化,还会显式告诉 LLM 在剩余上下文余量下该读哪些文件、跳过哪些。加上 evaluator 作用于整个 file store 的 $E(D)$——语法失败因此能阻塞整条指令流水线,而不只是给某个文件加个注记。这套组合是「fresh-context agent 链」能成立的全部原因:状态住在 $D$ 里,$M_{rs}$ 只是指向它的指针加摘要。
(3)QualityFlow 的 revert 机制是被调查系统中唯一显式管理状态历史的。 初始代码产物永不被覆盖,因而当调试轨迹开始劣化质量时,系统可以回滚到先前的共享 harness 状态。其余所有系统都只会向前走。这条与 §5.2.3 提出的 change contract(每次变更声明:改了哪个组件、针对哪个失败模式、预测什么改进、必须保持哪些不变量、什么评测能证伪它、怎么回滚)是同一个思路在两个尺度上的体现——一个在任务态,一个在 harness 态。