DECICE: AI-Driven Scheduling and Digital Twin Integration for the Cloud-HPC-Edge Compute Continuum
DECICE: AI-Driven Scheduling and Digital Twin Integration for the Cloud-HPC-Edge Compute Continuum — L2 #
§1 TL;DR #
DECICE 是 Horizon Europe 三年期项目的收官综述:在 Kubernetes 之上做 cloud-HPC-edge 统一调度,两大件是 RNN 预测型 Integrated AI Scheduler(5000×5000 job×node 内 300 s)与融合碳强度/异常预测的 Digital Twin,并用 KSI 桥接 Slurm。
§2 Q1 / Q2 / Q3 #
Q1 痛点:连续体上"资源约束"与"目标函数"不在同一个编排器里 #
论文给出的问题陈述极为紧凑:现代 workload 横跨 IoT 设备、边缘节点、云平台到 HPC 集群,而"workload 必须被匹配到满足计算、内存、数据局部性约束的资源上,同时满足能耗、延迟、成本要求"。这句话里藏着本文真正的工程痛点,值得拆开:
- 约束侧(硬):computational / memory / data locality — 这三项都是 Kubernetes 原生 scheduler 能表达一部分的(requests/limits、node affinity),但 data locality 在跨 HPC-cloud-edge 场景下不再是"同一个 CNI 网段内的拓扑",而是跨机构、跨传输介质的问题。
- 目标侧(软):energy / latency / cost — 这三项 Kubernetes 默认调度器完全不表达。绿电可用性、节点级功耗、碳强度都不是 K8s 的一等公民。
痛点因此不是"调度算法不够好",而是编排面缺少描述这些量的状态源。这解释了为什么本项目的两个核心组件里有一个不是调度器而是 Digital Twin:先要有可查询的实时能耗/碳强度/异常状态,能耗感知调度才有输入。
另一个隐含痛点在 HPC 侧:HPC 集群由 Slurm 管理、通常不给用户 root、不允许运行标准容器运行时,因此 cloud-native 的 workload 无法直接落到 HPC 分区。论文把这一段能力单独归给 WP3 的 KSI(Kubernetes-Slurm Integration,"enabling Kubernetes workloads on rootless HPC systems")。
Q2 方法:一个 K8s 控制面 + 可插拔调度策略池 + 状态孪生 #
论文的方法是分层而非单点,可以按 Fig. 1 的两个平面读:
- DECICE Framework 平面(控制面):两个入口 API(
DECICE API (Job & Telemetry)面向 End User,DECICE API (Control & Security)面向 Admin)→DECICE Control Manager→DECICE Model。DECICE Model内部并列放着Digital Twin与三个调度器:AI Scheduler、Heuristic Scheduler、Gang Scheduler。旁挂DECICE Config Store与Metrics Storage (Prometheus),以及两块Platform Specific Glue Code(Wrapper / Scheduler)。 - Compute Plane (K8s) 平面(数据面):HPC(HPC Nodes + Frontend Nodes 带 Proxy)、Cloud、Master Nodes(
KubeAPI、KubeEdge CloudCore)、Edge(EdgeCore)四个域,每个节点组都挂Kubelet+Monitoring。 - HOSHMAND:RNN-based,从历史 job-resource state pair 学习最优分配,目标是"eliminate redundant scheduling computations" —— 即把重复出现的调度决策变成一次前向推理而不是一次重新求解。
- GrapheonRL:GNN + RL,把 workflow 建成 dependency-aware graph,声称能做 constraint-aware scheduling "without mathematical reformulation"(即不需要每换一组约束就重写 MILP 模型)。
- workflow-driven modeling framework:把异构 HPC 调度形式化分解为 task-node mapping 与 schedule derivation 两步,并在这个框架下横向 benchmark 精确解算器(PuLP / SCIP / Gurobi / OR-Tools)、约束规划(CP-SAT)与启发式(GA / PSO / ACO / SA / HEFT / OLB)。
- IAIS 可扩展性:从 10 jobs×10 nodes 到 5000×5000,最大规模 100% 利用率下模型执行时间仍在 300 s 内(图中最大打印值为 5000×5000 (50%) 的 training 297.974 s)。
- 求解器 benchmark:Workflow 3(高依赖数)下 PuLP 25.46 s、OR-Tools 27.65 s,而 Gurobi 因内部 presolving 仅 1.41 s;HEFT 0.01–0.02 s。
- 项目级产出:>15 篇同行评审论文、全部组件开源(
https://github.com/DECICE-project)、ISC-HPC 2024/2025 tutorial 覆盖 >100 人。 - 用例验证:cloud robotics(Marmara/BIGTRI)、scientific computing(KTH/PDC)、edge inference(未指定 owner)——但这三个用例在本文内没有任何量化数据,只在 §II/§IV 被点名。
- 量纲一致性 — 不适用(无方程)。Fig. 4 / Fig. 5 的 y 轴均为秒,量纲自洽。
- 极限行为 — 可部分检验:$J=N=10$ 时训练 0.703–1.38 s,$J=N=5000$ 时 275.851–297.974 s。规模放大 500× 而时间放大约 200–400×,即经验上呈次二次增长;但只有 4 个规模点(10/100/1000/5000),拟合任何指数都不充分。
- 单调性 — 被数据违反:5000×5000 下 50% 利用率(297.974 s)慢于 100%(275.851 s)与 >100%(285.527 s)。若存在模型,此处需要解释;论文未提。
- 边界条件 — Fig. 4 的 x 轴包含第三档
>100 %利用率,caption 与 §III 正文均未定义"超过 100% 的资源利用率"含义(超订?排队?),属未定义边界。 - 与实验数值的一致性 — §III 称"execution completes within 300 seconds",最大打印值 297.974 s,一致但余量仅 0.7%,该论断对 5000×5000 之外的规模不具外推力。
- 文-图一致性 — 存在不一致:正文称"Heuristics (GA, PSO, ACO, SA, HEFT, OLB) maintain sub-second runtimes throughout",而同一张 Fig. 5 中 PSO 为 3.89 / 4.59 / 4.13 s、SA 为 3.92 / 4.71 / 4.65 s,三个场景全部超过 1 s。该句为 §III 关于启发式的头条论断。
- JSON 是 DT 的对外契约,PromQL 不是。 Fig. 3 中
Monitoring System不直连 DTC,而必须经PromQL-to-Json Wrapper Service转换后才进入 DT client 平面。这意味着监控后端是可替换组件(换掉 Prometheus 只需重写 wrapper),但也意味着所有查询表达能力被压缩到 wrapper 暴露的那一组固定 JSON 字段——PromQL 的即席聚合能力在 DT 侧不可用。任何需要新聚合维度的调度策略都要改 wrapper 而非改查询。 - HPC 域的
Frontend Nodes → Proxy是唯一可控入口。 Fig. 1 中 HPC 子域比 Cloud 子域多出一层:Cloud Nodes 直接跑Kubelet + Monitoring,而 HPC 侧在 HPC Nodes 之外另有 Frontend Nodes 承载Proxy。这是 rootless HPC 的必然产物——计算节点上无法运行需要特权的组件,只能由登录/前端节点代理。实践含义是 HPC 分区的调度延迟与吞吐上限由这个 proxy 决定,它是单点也是瓶颈,而论文既未测量它也未讨论其 HA。
IAIS(Integrated AI Scheduler)内部包含三条技术路线,论文明确它们是并列策略而非替代关系:
Digital Twin(Fig. 3)是一个以 InfluxDB 为中心的状态孪生:Digital Twin Core (DTC) 维护 Digital Twin Cluster Status,通过 TimeSeriesClient 读写时序库;上挂三个 ML 模型(Carbon Intensity Prediction、Node Anomaly Detection、Workload Energy Prediction),下挂 DT Clients(Scheduler Controller、Control Manager、PromQL-to-Json Wrapper Service、VTE)。API Server 只暴露 POST Cluster Snapshot / GET Cluster Snapshot 两个动作。
核心技术壁垒:不是 RNN,也不是 GNN+RL——这两者都在引用文献里,本文只做集成。真正难复制的是把"预测型状态源"做成调度器可同步查询的一等接口,并让它同时服务于真实集群与虚拟测试环境(VTE)。Fig. 3 里 Scheduler Controller 与 VTE 挂在同一个 DT Clients 平面上、共用同一套 snapshot 语义,这意味着 AI 调度器的训练环境与生产环境看到的是同一形状的状态对象。这一点是 sim-to-real 的关键:Fig. 2 里 LB-KAIROS(图内绘制为 LiI-KAIROS)能"simulating several load-balancer and scheduling methods for validation",其可信度完全建立在 VTE 与真实集群共享 DT snapshot schema 之上。任何想复现 DECICE 的团队都得先重建这个双端一致的状态抽象,而这一层论文没有给形式化定义,只给了框图。
Q3 结果 #
§3 架构 / 方法图 #
3.1 整体架构(原图) #
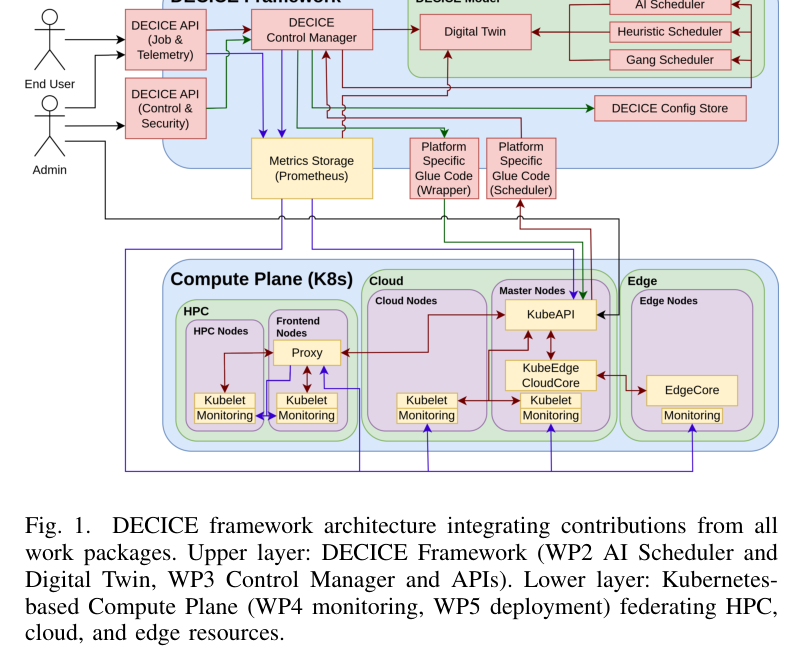
Paper's Figure 1, verbatim (caption: "DECICE framework architecture integrating contributions from all work packages. Upper layer: DECICE Framework (WP2 AI Scheduler and Digital Twin, WP3 Control Manager and APIs). Lower layer: Kubernetes-based Compute Plane (WP4 monitoring, WP5 deployment) federating HPC, cloud, and edge resources.")
读这张图要抓三处结构决定。第一,调度器是三个并列盒子(AI / Heuristic / Gang)而非一个,说明框架的设计立场是策略可选而非算法唯一——这与 §5 的求解器 benchmark 互为因果。第二,Digital Twin 与调度器同处 DECICE Model 内,即状态孪生被当作调度输入而非旁路观测系统。第三,HPC 域独有 Frontend Nodes → Proxy 这条路径,这是 rootless HPC 无法直接跑 kubelet 的妥协产物(KSI 的落点)。注意图中三种颜色的箭头(绿 / 蓝紫 / 深红)没有 legend,控制流与数据流的区分需要读者自行推断。
3.2 请求生命周期(重绘:原文无此视角图) #
原文三张框图都是静态结构图,没有一张给出 job 从提交到落盘的时序。下面按 Fig. 1 + Fig. 2 + Fig. 3 的箱体与边标签还原一次生命周期:
关键在于 GET Cluster Snapshot 出现在调度决策之前、POST Cluster Snapshot 出现在绑定之后:这条闭环是 energy-aware 调度得以成立的结构前提,也是 Digital Twin 不能被降级为监控看板的原因。
3.3 IAIS 数据流(原图) #
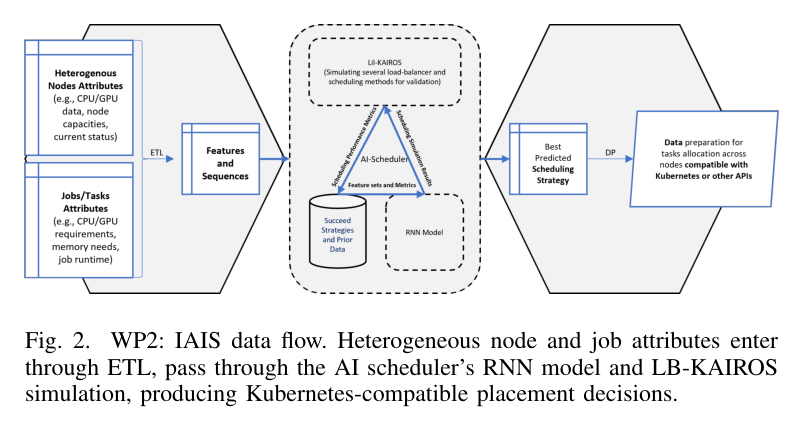
Paper's Figure 2, verbatim (caption: "WP2: IAIS data flow. Heterogeneous node and job attributes enter through ETL, pass through the AI scheduler's RNN model and LB-KAIROS simulation, producing Kubernetes-compatible placement decisions.")
两路输入(节点属性:CPU/GPU 数据、容量、当前状态;作业属性:CPU/GPU 需求、内存、运行时)经 ETL 变成 Features and Sequences,说明 RNN 的输入是序列化的调度历史而非单帧快照——这与 HOSHMAND"从历史 job-resource state pair 学习"的定位一致。虚线框内 Succeed Strategies and Prior Data 是一个数据库柱体,意味着"成功策略"被持久化并回灌训练,这是"消除冗余调度计算"的实现方式:命中历史相似状态则直接复用策略。输出经 DP(data preparation)适配到 Kubernetes 或其他 API,即调度器本身不与 K8s 强绑定。
3.4 Digital Twin 架构(原图) #
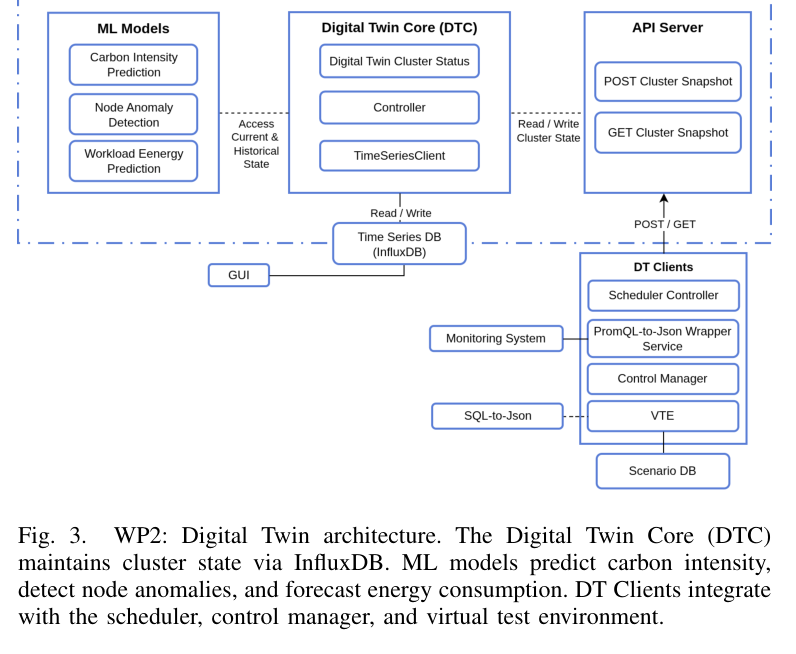
Paper's Figure 3, verbatim (caption: "WP2: Digital Twin architecture. The Digital Twin Core (DTC) maintains cluster state via InfluxDB. ML models predict carbon intensity, detect node anomalies, and forecast energy consumption. DT Clients integrate with the scheduler, control manager, and virtual test environment.")
注意 Monitoring System → PromQL-to-Json Wrapper Service 这条边:Prometheus 的 PromQL 结果被转成 JSON 才进入 DT client 平面,说明 DT 的对外契约是 JSON snapshot 而非 PromQL,监控系统是可替换的。另一处值得留意的是 SQL-to-Json(虚线)→ VTE 与 Scenario DB:虚拟测试环境从场景库回放,走的是与真实 snapshot 相同的 JSON 形状,这正是 §2 Q2 指出的技术壁垒在图上的落点。
§4 作者证明 #
无形式化作者证明 — 仅实证。
本文 5 页正文包含 0 个编号方程、0 张表格。§II(WP2)虽然声称把异构 HPC 调度"formally decomposes ... into task-node mapping and schedule derivation",但该形式化完全存放在引用文献 [1](Sharma et al., COMPSAC 2025)中,本文只给出这一句转述。可复述的 notation table 因此不存在;唯一的数学记号是 Fig. 4 caption 里的 $\times$。
按 framework 类论文常有的吞吐/延迟/成本模型逐项核对,结果如下(这也是这篇论文作为工程参考时最需要警惕的空缺):
| 本应具备的形式化内容 | 本文状态 | 一个模型本会澄清什么 |
|---|---|---|
| notation table(作业数 $J$、节点数 $N$、利用率 $\rho$) | 缺失 | Fig. 4 的 x 轴 Job × Node 到底是笛卡尔积规模还是决策变量数 |
| 调度问题的目标函数 | 缺失 | energy / latency / cost 三目标如何加权或如何做 Pareto 取舍 |
| 复杂度上界 | 缺失 | RNN 推理相对 MILP 求解的渐进优势是 $O(1)$ 摊还还是仅常数因子改进 |
| 单调性 / 凸性 | 缺失 | 为何 Fig. 4 中 $\rho=50\%$ 反而比 $\rho=100\%$ 慢(见 §5.1) |
| 一阶数量代入验证 | 不可执行 | 无法把 5000×5000 的 297.974 s 与任何解析式对照,只能当作实测点 |
| 约束到求解器的映射规则 | 缺失 | "without mathematical reformulation" 究竟省掉了哪一步建模成本 |
六项最小核对(在无形式化模型前提下逐条判定):
结论:这是一篇 project-report 型论文,其可信度建立在引用链([1][2][3][7])而非本文自证之上。任何把 DECICE 数字用于容量规划的做法,都应回溯到 [1] 的形式化与 [2] 的 RNN 评估。
§5 实验与数据 #
5.1 IAIS 可扩展性 #
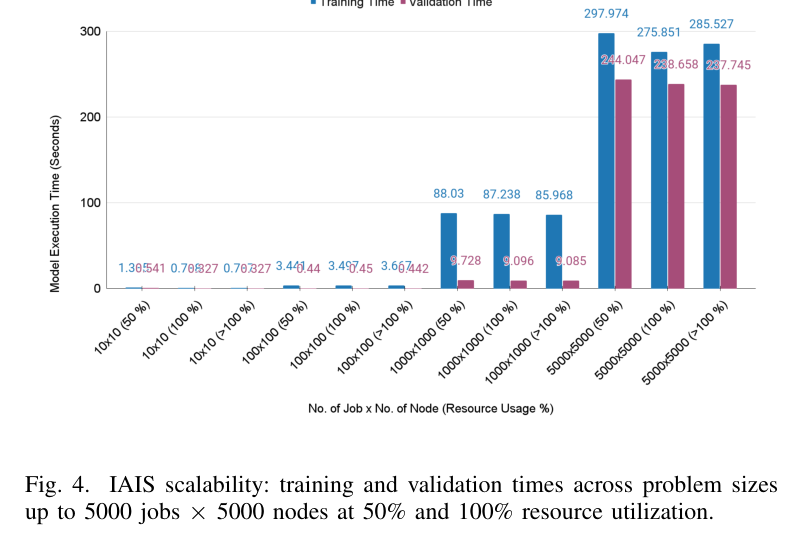
Paper's Figure 4, verbatim (caption: "IAIS scalability: training and validation times across problem sizes up to 5000 jobs $\times$ 5000 nodes at 50% and 100% resource utilization.")
图为分组柱状图,y 轴 Model Execution Time (Seconds),x 轴 12 个类别(4 个规模 × 3 个利用率档)。逐条读数:
| 规模 (Job × Node) | 利用率 | Training (s) | Validation (s) | Val/Train |
|---|---|---|---|---|
| 10×10 | 50% | 1.38 | 0.541 | 0.39 |
| 10×10 | 100% | 0.708 | 0.327 | 0.46 |
| 10×10 | >100% | 0.703 | 0.327 | 0.47 |
| 100×100 | 50% | 3.44 | 0.44 | 0.13 |
| 100×100 | 100% | 3.40 | 0.45 | 0.13 |
| 100×100 | >100% | 3.667 | 0.442 | 0.12 |
| 1000×1000 | 50% | 88.03 | 9.728 | 0.11 |
| 1000×1000 | 100% | 87.238 | 9.096 | 0.10 |
| 1000×1000 | >100% | 85.968 | 9.085 | 0.11 |
| 5000×5000 | 50% | 297.974 | 244.047 | 0.82 |
| 5000×5000 | 100% | 275.851 | 238.658 | 0.87 |
| 5000×5000 | >100% | 285.527 | 237.745 | 0.83 |
读者应注意两处异常。第一,Val/Train 比例在最大规模处跳变:从 1000×1000 的 ~0.11 突然升到 5000×5000 的 ~0.82,即 validation 成本在最大规模上几乎追平 training。这个跳变不可能由"数据量线性增加"解释(那会保持比例恒定),更像是在 5000 规模上触及了某种内存/批处理边界,使 validation 失去了原有的批量优势。论文对此没有讨论。第二,利用率不是单调压力轴:在 1000×1000 与 5000×5000 两个规模上,50% 利用率反而最慢。若 RNN 的输入是节点状态序列,则利用率更高可能意味着可行放置候选更少、序列更"确定",从而收敛更快——但这只是推测,论文未给机制解释。
对工程读者的真实含义:< 300 s 这个数字是模型训练+验证时间,不是单次调度决策延迟。Fig. 2 的推理路径(ETL → RNN 前向)才是在线调度延迟,而本文没有报告它。这是把 IAIS 用于生产前必须自行测量的量。
5.2 求解器与启发式 runtime 对比(本文唯一的横向 benchmark) #
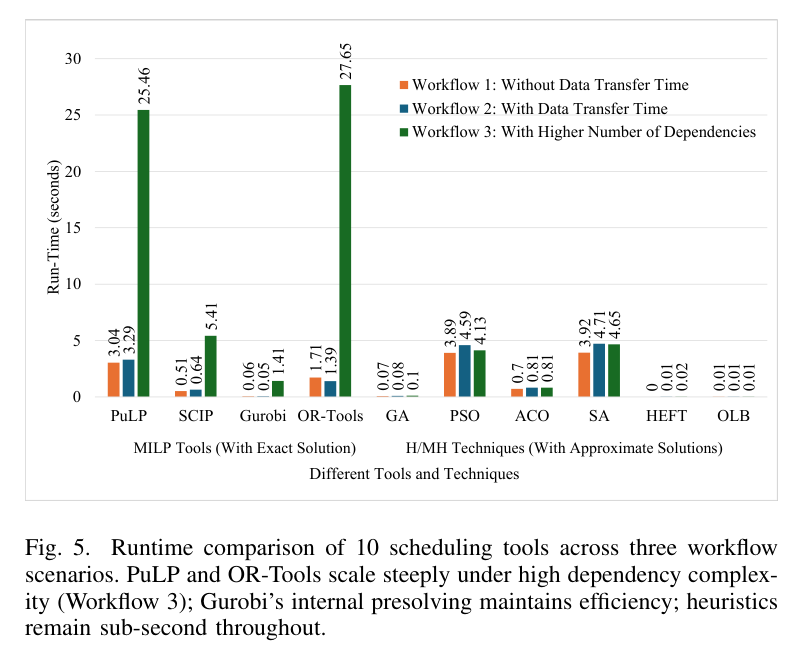
Paper's Figure 5, verbatim (caption: "Runtime comparison of 10 scheduling tools across three workflow scenarios. PuLP and OR-Tools scale steeply under high dependency complexity (Workflow 3); Gurobi's internal presolving maintains efficiency; heuristics remain sub-second throughout.")
三个场景由 legend 定义:Workflow 1 不含数据传输时间,Workflow 2 含数据传输时间,Workflow 3 提高依赖数量。
| Tool | 类别 | WF1 (s) | WF2 (s) | WF3 (s) | WF1→WF3 倍率 |
|---|---|---|---|---|---|
| PuLP | MILP 精确 | 3.04 | 3.29 | 25.46 | 8.4× |
| SCIP | MILP 精确 | 0.51 | 0.64 | 5.41 | 10.6× |
| Gurobi | MILP 精确 | 0.06 | 0.05 | 1.41 | 23.5× |
| OR-Tools | MILP 精确 | 1.71 | 1.39 | 27.65 | 16.2× |
| GA | 启发式 | 0.07 | 0.08 | 0.1 | 1.4× |
| PSO | 启发式 | 3.89 | 4.59 | 4.13 | 1.06× |
| ACO | 启发式 | 0.7 | 0.81 | 0.81 | 1.16× |
| SA | 启发式 | 3.92 | 4.71 | 4.65 | 1.19× |
| HEFT | 启发式 | 0.01 | 0.02 | 0.01–0.02 | ~1× |
| OLB | 启发式 | 0.01 | 0.01 | 0.01 | 1× |
这张图真正支撑的结论不是"启发式比精确解快",而是"依赖数量是精确解算器的敏感轴,而启发式对依赖数量几乎不敏感":精确解一列的 WF1→WF3 倍率是 8.4–23.5×,启发式一列是 1.0–1.4×。这个对比才是 IAIS 内部"按 workload 特征选策略"的依据——如果 workflow 依赖稀疏,Gurobi 的 0.05 s 比 PSO 的 4.59 s 好两个数量级且给出最优解;只有依赖稠密时才需要退到启发式。
两个必须指出的读图陷阱:(1)Gurobi 在最难场景(1.41 s)仍快于 PSO(4.13 s)与 SA(4.65 s),即精确解在此 benchmark 中并未被启发式全面压制,这与 caption 建立的叙事相反;(2)§II 列举的 CP-SAT 未出现在 Fig. 5 的 10 个类别中,约束规划这一整类在图上缺席。此外全图只报 runtime,不报解质量——精确解与启发式的目标值差距(makespan / energy)无从比较,这使"该选哪个"的决策实际上仍缺一半信息。
5.3 调度与资源管理的具体形态 #
按框图与正文可确定的调度面事实:
| 维度 | 本文可确定的内容 | 来源 |
|---|---|---|
| 调度粒度 | job / task 级(task-node mapping + schedule derivation 两步分解) | §II WP2 |
| 策略池 | AI Scheduler / Heuristic Scheduler / Gang Scheduler 三者并列 | Fig. 1 |
| Gang 语义 | 存在独立 Gang Scheduler 盒子,说明支持全或无成组调度(MPI 类作业必需) | Fig. 1 |
| 抢占策略 | 未描述 | — |
| 准入控制 / 过载丢弃 | 未描述;>100 % 利用率档暗示存在超订但无定义 | Fig. 4 |
| 公平性 / 多租户 | 未描述(DECICE API (Control & Security) 暗示有 admin 侧策略面) | Fig. 1 |
| 状态存储 | 双库:Prometheus(Metrics Storage)+ InfluxDB(DT 时序库) | Fig. 1 / Fig. 3 |
| 监控指标 | CPU/GPU utilization、memory pressure、network throughput、storage I/O | §II WP4 |
| 工作流摄入格式 | Kubernetes、Snakemake、Argo Workflows 三种统一入口 | §II WP3 |
| 集群生命周期 | ephemeral cluster management(Warewulf 动态删除/重建) | §II WP3 |
| 容错 | Kubernetes vs Slurm 容错机制对比研究,未集成为框架能力 | §II WP4 |
5.4 Workload regime — 何处赢,何处输 #
| Workload regime | DECICE 路径 | 直接用 K8s / Slurm | 为什么 |
|---|---|---|---|
| 依赖稀疏、单域(纯 cloud)小规模作业 | 不划算:需部署 DT + InfluxDB + Prometheus + Control Manager | K8s 默认调度器足够 | 目标函数只有 CPU/mem 时,DT 提供的碳/能耗状态无处使用 |
| 依赖稠密的科学工作流(WF3 类) | 赢:策略池可退到 HEFT/GA(0.01–0.1 s) | 单一 MILP 路径退化到 25–28 s | 精确解对依赖数敏感(8.4–23.5×),启发式不敏感(~1.2×) |
| 跨 cloud + rootless HPC 混合提交 | 赢:KSI 让 K8s workload 落到 Slurm 分区 | 需人工双栈提交 | HPC 侧无 root、无标准容器运行时,Frontend Proxy 是唯一通路 |
| 能耗/碳强度敏感的长期批处理 | 赢(但未验证):DT 提供碳强度预测 | 无状态源 | 论文自承 longitudinal 真实碳强度评估属 future work |
| Edge 低延迟推理 | 不明:列为用例但零量化数据 | — | edge inference 用例连 owner partner 都未指定 |
| 极大规模(>5000 job)在线调度 | 未知:只测到 5000×5000 且余量 0.7% | — | 论文把"thousands of tasks 的生产 workload"列为 future work |
论文没有给出这张表,也没有任何"我们在何处更差"的陈述——全文无 limitations section、无负结果表。上表中"不划算/不明/未知"三行是从数据缺口反推的。
5.5 Baseline 公平性 #
本文的 baseline 不是竞品框架,而是求解器软件本身(PuLP / SCIP / Gurobi / OR-Tools / GA / PSO / ACO / SA / HEFT / OLB),且这 10 个工具都没有单独引用。因此无法核对:版本号(Gurobi 的 presolving 行为强依赖版本与 license 等级)、超参(GA/PSO/SA 的种群大小与迭代数直接决定其 runtime,PSO 的 3.89 s 很可能只是迭代数设置的产物)、硬件(未报告 CPU 型号、核数、内存)。指标定义同样宽松:Fig. 4 的"execution time"未区分单次 epoch 与全量训练;Fig. 5 的"run-time"未说明是否包含模型构建(build)时间——而对 MILP 而言 build 时间常与 solve 时间同阶。没有 DECICE 与 vanilla Kubernetes 调度器的端到端对比实验。
§6 论证链 #
| # | 论证步骤 | 依据(本文内部) | 支撑强度 |
|---|---|---|---|
| 1 | Workload 横跨 IoT→edge→cloud→HPC,需同时满足计算/内存/数据局部性约束与能耗/延迟/成本目标 | §I-B 动机段(论断,无引用数据) | 弱:作为公认前提陈述 |
| 2 | 因此需要一个统一编排层;选择 Kubernetes 作为底座并向 HPC/edge 双向扩展 | §I-C(Computer Architecture 主题 = "Kubernetes federation across HPC, cloud, and edge");Fig. 1 的 Compute Plane (K8s) | 中:架构图落实,但未论证为何是 K8s 而非 Slurm 为底座 |
| 3 | HPC 侧 rootless 限制使标准 K8s workload 无法直接落地,需专门集成层 | §II WP3 引入 KSI [5];Fig. 1 中 HPC 域独有 Frontend Nodes → Proxy | 中:结构上自洽,量化证据在 [5] 中而非本文 |
| 4 | 能耗/碳感知调度要求可查询的实时能耗与碳强度状态,故需 Digital Twin 而非仅监控 | Fig. 3(三个 ML 模型 + DTC + snapshot API);§II WP4(监控数据同时喂 DT 与调度器) | 中:架构完整,但无一条能耗节省的实测数字 |
| 5 | 单一调度算法不足:精确解在高依赖下代价爆炸,启发式对依赖不敏感 | Fig. 5:PuLP 3.04→25.46 s、OR-Tools 1.71→27.65 s vs GA 0.07→0.1 s | 强:本文最扎实的一环,有逐工具读数 |
| 6 | 故 IAIS 内置策略池(AI / Heuristic / Gang)并按 workload 特征选策略 | Fig. 1 三调度器并列;§III"guides scheduling strategy selection within the IAIS" | 中:机制存在,但选择规则本身未给出(无阈值、无决策树) |
| 7 | AI 路线本身在生产规模上可行:5000×5000 内 300 s | Fig. 4,最大值 297.974 s | 中:单点达标但余量 0.7%,且测的是训练而非在线推理延迟 |
| 8 | 综上:框架已交付、模块可独立采用、开源可续 | §IV;Acknowledgment 中 github.com/DECICE-project | 弱:交付性论断,无采用度或生产部署数据 |
链条的承重点集中在第 5 步:它是全文唯一有完整逐点读数、且结论方向明确的实验。第 4 步(Digital Twin → 能耗感知)在架构上完备但在证据上是空的——本文没有任何一个"节省了多少焦耳/降低了多少 gCO2"的数字,这一环靠引用 [8][9] 的预测模型质量间接承载。
§7 实现 cross-reference #
[实现未公开 —— 论文层面无 file:line 可引]:本文正文与 acknowledgment 只给出组织级入口 https://github.com/DECICE-project 与项目站 https://www.decice.eu,未指明任何仓库名、模块路径、commit hash 或版本号。因此本节无法提供 file:line 级引用;下述内容是从图/文可确定的实现契约,供后续对照代码时定位。
7.1 核心技术壁垒(对应 §2 Q2) #
最难复制的一环是真实集群与虚拟测试环境共享同一 snapshot 契约。Fig. 3 把 Scheduler Controller 与 VTE 并列挂在 DT Clients 平面,二者都通过 API Server 的 POST / GET Cluster Snapshot 与 DTC 交互;Scenario DB 经 SQL-to-Json 喂 VTE,形状与真实 PromQL-to-Json Wrapper Service 的输出对齐。这个设计的后果是:Fig. 2 中 LB-KAIROS 做的调度方法仿真、以及 RNN 的离线训练,都可以在与生产同构的状态对象上进行,训练-部署之间不存在特征漂移。要复制 DECICE,重写一个 RNN 或换一个 GNN 都不难,难的是先把这套双端一致的状态抽象定义出来并保持长期兼容——而这一层论文只给了框图,既无 schema 定义、无字段列表、无版本化策略,也没有说明 snapshot 的采样周期与一致性语义(快照是否跨节点原子)。这是复现该框架时最大的未公开面。
7.2 关键实现细节(易被忽略的两处) #
另有两处命名与一致性问题会在对照代码时造成困扰:Fig. 2 的 caption 写 LB-KAIROS,图内绘制为 LiI-KAIROS,全文未展开该缩写;WP2 的 lead"after transfer from FBU",而 FBU 不在 §I-A 的 12 家伙伴名单中。查找对应仓库时这两个名字都不可靠。