When Do Multi-Agent Systems Help? An Information Bottleneck Perspective
When Do Multi-Agent Systems Help? An Information Bottleneck Perspective — L2 #
1. TL;DR #
MAS 与 SAS 的本质差异不是 agent 数量,而是 worker 间的有界 relay 压缩。无限带宽下 MAS 可逐步模拟任意 SAS,所以真正起作用的是压缩。每个 relay 是一个信息瓶颈:局部增益 $G_i^{\text{MAS}} = H(M_i\mid m_i) - \beta\Delta_i(m_i)$——上游冗余削减收益减去能力加权的信息损失。弱模型受益、强模型受损。
2. Q1 / Q2 / Q3 #
Q1 — 痛点(为什么这个问题值得做) #
MAS 在软件工程、数学推理、科学发现等任务上有经验性收益,但相对 SAS 的优势"时灵时不灵",在不同 setting 下不一致。近期研究发现两个令人不安的现象:(1) 随着基座模型能力增强,MAS 增益缩小甚至消失 [9, 14];(2) 一部分所谓增益其实来自更多的 compute 而非架构本身 [13, 31, 17]。现有对比研究几乎全是经验性的,没人解释"什么结构性机制决定 MAS 何时优于 SAS"。这篇把问题从"经验描述"推到"机制解释"。
Paper's Figure 1(caption: "Predicted MAS gain by relay regime. MAS helps when context reduction outweighs capability-weighted relay loss; stronger models gain less from compression and lose more from information loss.")。 这张图是整篇论文的"预测承诺":横轴 relay regime(从充分到不充分),纵轴预测增益;它把后面所有实验收敛到一个可证伪的形状——充分 relay 区正增益、不充分区转负,且曲线随模型能力整体下移。读者应注意:论文先画出理论预测,再用 18 组实验去逼近这条曲线。
Q2 — 方法(一句话内核) #
把 MAS 设计重新表述为 worker 之间 relay 的信息瓶颈优化:每条 relay $m_i$ 在"压缩上游上下文 $I(M_i;m_i)$"与"保留下游任务相关信息 $I(m_i;Y_{i+1}\mid X_{i+1})$"之间权衡,权衡系数 $\beta$ 是一个由下游 LLM 能力诱导的有效参数。由此导出逐阶段增益分解(Theorem 4.1),并用三个受控原型(SAS / SAS-contextflow / MAS)把"子任务分解"与"relay 压缩"两个混淆因素分离开。
核心技术壁垒(THE single hardest insight):把一个本来没有显式优化目标的工程现象(MAS 的 prompt/通信/模型能力)反向识别为一个隐式 IB 目标,并断言其最优 relay 由该目标刻画——"Although not optimized explicitly, this objective is implicitly induced by the MAS design and characterizes the optimal relay."(§4.1)。真正难复制的不是公式,而是这一步把能力差异 $\beta$ 从一个可调超参降解为"模型本身"的代理,从而让"同一条 relay 帮弱模型、害强模型"成为理论的直接推论而非事后观察。
Q3 — 结果(最强的一句话证据) #
在 5 个 benchmark × 3 个模型尺度上,低复杂度 relay($\delta\approx 0$:ALFWorld、WideSearch、TravelPlanner-CS)产生一致正增益;高复杂度 relay($\delta>0$:WorkBench、WebShop、TravelPlanner-HC)增益缩小或反转。最尖锐的单点证据:TravelPlanner-HC 上,MAS 增益从弱/中模型的 +0.017 / +0.161 翻转为强模型 Qwen3.5-27B 的 −0.233——正是 Theorem 4.1 预测的"强模型下信息损失项 $\beta\Delta_i$ 压过上下文削减项"。
3. 架构 / 方法图 — 三原型与 relay 瓶颈 #
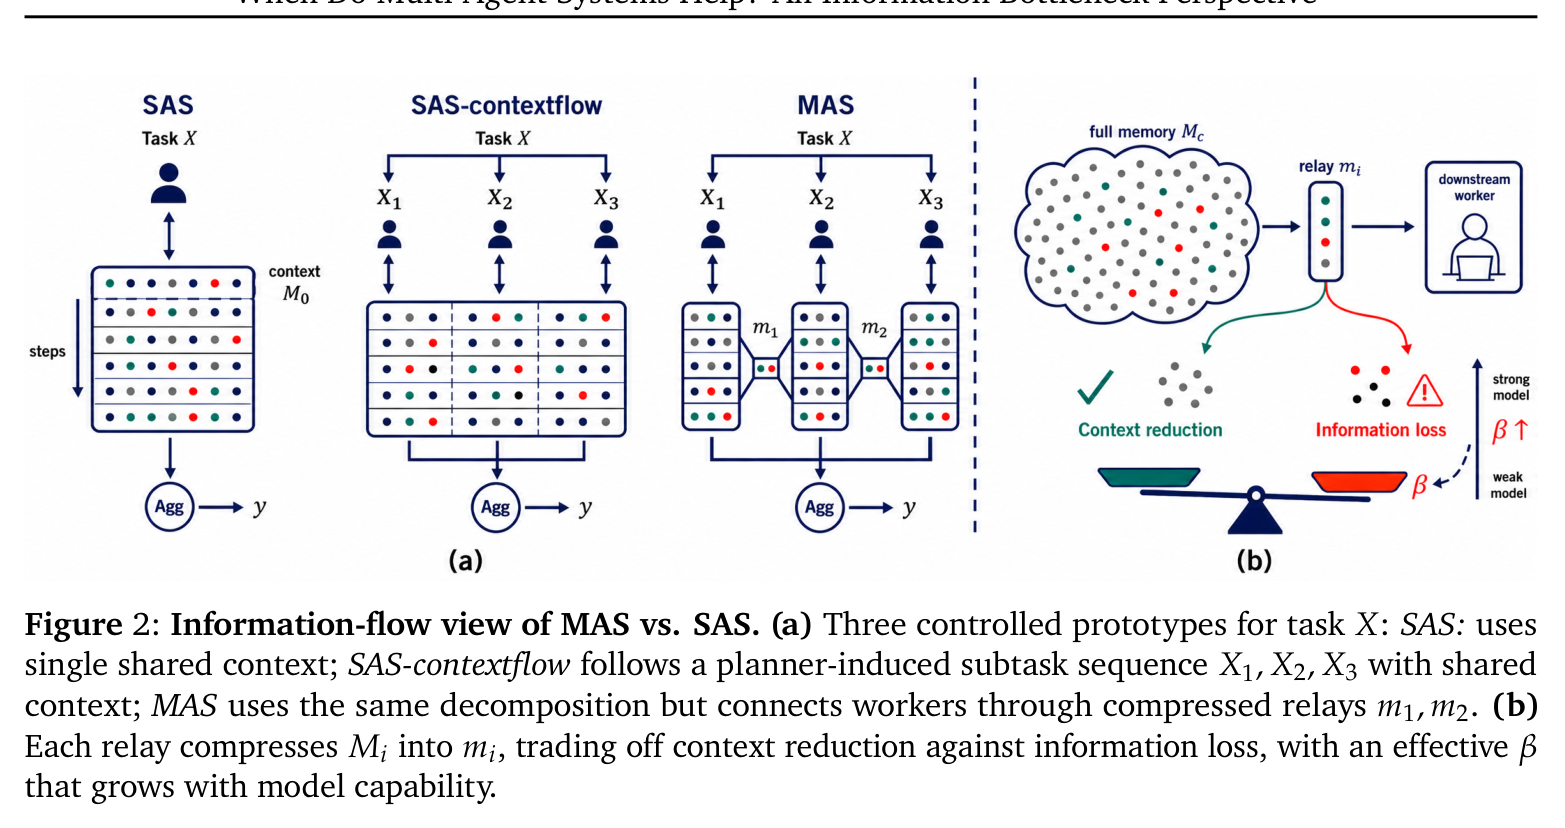
Paper's Figure 2(caption: "Information-flow view of MAS vs. SAS. (a) Three controlled prototypes for task X... (b) Each relay compresses Mi into mi, trading off context reduction against information loss, with an effective β that grows with model capability.")。 (a) 是整个实验设计的核心:三个原型共享同一套 planner 诱导的子任务序列 $X_1,X_2,X_3$,唯一变量是上下文如何流动——SAS 单一共享上下文;SAS-contextflow 按子任务顺序但上下文全可见;MAS 用压缩 relay $m_1,m_2$ 连接隔离 worker。(b) 把单条 relay 画成"$M_i \to m_i$ 压缩"的瓶颈。读者应抓住:MAS 与 SAS-contextflow 只差一个压缩算子,这正是把"分解"与"压缩"解耦的实验杠杆。
Agent 回合状态机。单条 relay 接口上,一个 worker 的内部循环与 relay 产出关系如下:
- 交互模式:多回合、链式(planner → n 个 worker → system aggregator),worker 间仅通过 relay 单向传递;WideSearch 是并行无 relay 的特例。
- 记忆模型:短期 = 单 worker 的累积 context $M_i$(thoughts/actions/observations);worker 之间没有共享长期记忆,这正是信息损失的来源。
- 规划风格:预定工作流(planner 先切分子任务),而非 ReAct 树搜索;每个 worker 内部是 think-then-act 循环。
- 预算:所有原型共享同一 maximum total step budget(见 §5 Table 5),确保增益不来自额外 compute。
- 错误恢复 / 失败隔离:relay 一旦丢失下游所需字段,下游 worker 无法回溯上游 context——这是论文刻意保留的失败面(见 §7 WorkBench 案例)。
4. 作者证明 #
符号表 #
| 符号 | 含义 |
|---|---|
| $\Gamma=\langle S,A,O,P,\Omega,X\rangle$ | agentic task class(状态/动作/观测空间、转移核、观测核、任务实例空间) |
| $M_i$ | worker $i$ 的累积上下文(thoughts+actions+observations) |
| $m_i=\text{Agg}_i(M_i)$ | worker $i$ 产出、传给 $i{+}1$ 的 relay(压缩消息) |
| $Y_{i+1}$ | 子任务 $X_{i+1}$ 诱导的下游目标变量 |
| $B_{\text{sys}}$ | 系统级 relay 带宽上界,$H(m_i)\le B_{\text{sys}}$ |
| $\beta>0$ | IB 权衡系数;本文解释为"下游 LLM 能力"的有效代理 |
| $\Delta_i(m_i)$ | relay 信息损失(Def 4.1) |
| $\delta$ | relay 复杂度 = 下游充分 relay 的最小描述长度(Eq.10) |
方程物理意义 #
- Markov 关系(Eq.1) $m_i \leftrightarrow M_i \leftrightarrow Y_{i+1}\mid X_{i+1}$:给定 $M_i$ 与 $X_{i+1}$,relay 不含额外关于 $Y_{i+1}$ 的信息——因为 $m_i$ 是从 $M_i$ 压出来的,数据处理不等式的直接体现。
- IB 目标(Eq.2) $\min_{p(m_i|M_i)} I(M_i;m_i) - \beta\,I(m_i;Y_{i+1}\mid X_{i+1})$:第一项压缩上游、第二项保留下游相关性,$\beta$ 决定谁赢。
- 中心结果(Theorem 4.1, Eq.7) $G_i^{\text{MAS}} = H(M_i\mid m_i) - \beta\,\Delta_i(m_i)$:MAS 局部增益 = 上游上下文削减收益 − 能力加权的信息损失成本。$G_i^{\text{MAS}}>0 \iff H(M_i\mid m_i) > \beta\Delta_i(m_i)$(Eq.8)。
最小检查(≥6) #
- 量纲一致性:$G_i^{\text{MAS}}$、$H(M_i\mid m_i)$、$\beta\Delta_i$ 均为信息量(bits/nats);$\beta$ 无量纲权重 → 相减合法。✓
- 非负性:$\Delta_i(m_i)\ge 0$ 由 Eq.1 的 Markov 关系 + 数据处理不等式保证(§A.2 证)。✓
- 边界退化(SAS 极限):令 $m_i=M_i$,则 $H(M_i\mid m_i)=0$、$\Delta_i=0$ → $G_i^{\text{MAS}}=0$,与 Proposition 3.1 的 MAS=SAS 一致。✓
- 单调性(沿 $\beta$):固定 $\Delta_i>0$,$G_i^{\text{MAS}}$ 随 $\beta$ 单调递减 → "强模型(大 $\beta$)增益更小甚至为负"直接可读。✓
- 单调性(沿 $\delta$):$\delta$ 越大 → 期望 $\Delta_i$ 越大 → 成本项越大,与 Table 2 中 $\delta\approx0$ 全正、$\delta\gg0$(WorkBench)全负吻合。✓
- 可行性(Proposition 3.1):SAS 每步有限熵 → relay 熵有限 → $\exists B_{\text{sys}}\ge\max_i H(M^{(i)}_{T_i})$ 使构造可行;$B_{\text{sys}}\to\infty$ 时归纳证得 $y_{\text{MAS}}=y_{\text{SAS}}$(§A.1)。✓
- 局部≠全局(边界条件):局部对 $Y_{i+1}$ 充分不蕴含对 $Y_j\,(j>i{+}1)$ 充分,需 §A.3 的两个结构条件(mediated dependence + non-interference),否则隐藏长程依赖使局部充分 relay 对后续 worker 不充分。✓
- ALFWorld relay 格式(§D.1):Explorer 禁用 manipulation、只做导航/检查;relay 为结构化
Target object 1: egg 2, found at: countertop 1 - WorkBench relay 格式(§D.1, §C.3):Reader 持全部读/查工具、输出
RESULT: {ACTION_NEEDED|NO_ACTION}+FIELDS{...};Writer 仅有写工具、信任 FIELDS 不复核。这正是 $\delta\gg0$ 的工程根因:正确执行依赖 record ID/timestamp/branch outcome/name-to-email,而这些被压进离散 schema 后不可回溯。 - TravelPlanner 关键实现细节(易错陷阱)(§C.2):budget=$1,400 作为 plan-level 全局量,对所有 MAS sub-agent 隐藏。强模型 SAS-contextflow 能用可见预算上限保持在预算内($≤1400),MAS 丢失该信号产出 $1,599 方案 → HC 失败。这一"隐藏全局约束"是 MAS 在强模型上翻转的微观机制。
- 关键实现细节 2(§C.3):WorkBench MAS 中,Reader 即便算出正确 deadline(2023-12-08),其
create_task被 reader 工具白名单拦截 → relay 坍缩为NO_ACTION→ Writer 不执行。失败不在推理、而在 relay schema + 工具权限划分丢弃了正确结论。
失败模式分类:论文识别的主导失败类是高 $\delta$ relay 的信息损失——在强全局耦合任务(WorkBench 的 record ID/timestamp/name-to-email、TravelPlanner-HC 的全局预算一致性)上,relay 丢弃了下游执行所需的精确中间证据。方法本身不"修复"这一类,而是预测它何时发生(这是机制解释而非算法改进)。
形式化证明仅覆盖 Proposition 3.1(等价性)与 Eq.1(Markov 关系)。Theorem 4.1 的分解是代数恒等式;而"$\beta$ 随能力增长""$\delta$ 的赋值"无形式化证明 — 仅实证(§7 明确承认 $\beta$ 为定性参数、$\delta$ 由任务结构分析赋值,均未定量估计)。
5. 实验与数据 #
Benchmark 与 relay 复杂度分级(Table 1):ALFWorld / WideSearch / TravelPlanner-CS 判为 $\delta\approx0$(下游所需信息可紧凑描述);WebShop $\delta>0$、TravelPlanner-HC $\delta>0$、WorkBench $\delta\gg0$(需精确的上游执行历史)。模型三档:Qwen2.5-7B(弱)、GPT-4o-mini(中)、Qwen3.5-27B-AWQ-4bit(强)。
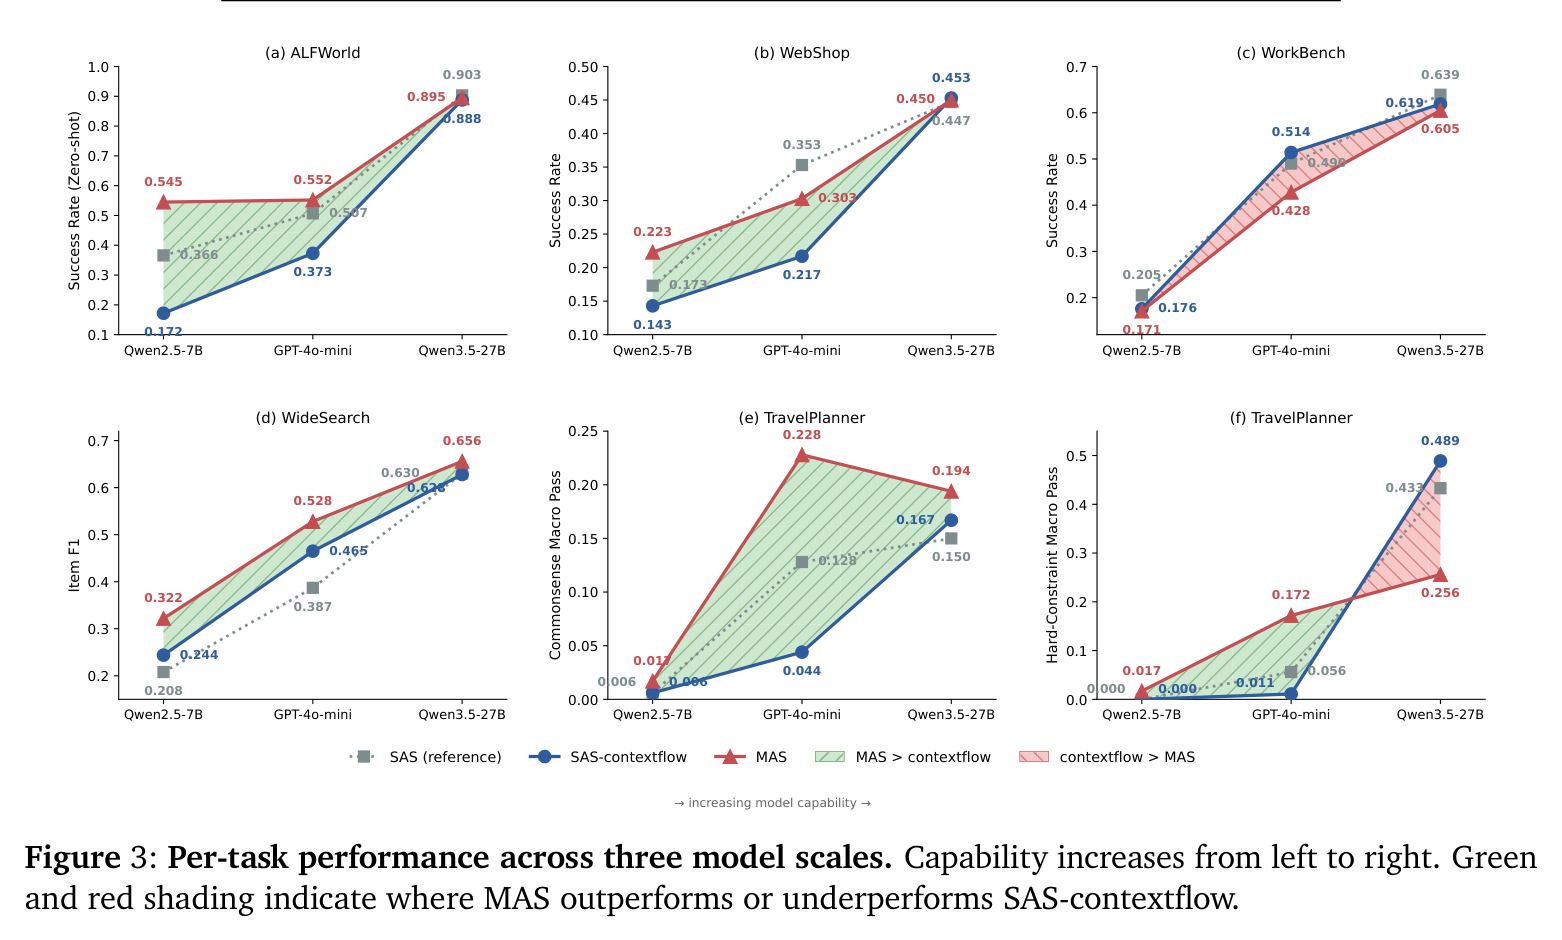
Paper's Figure 3(caption: "Per-task performance across three model scales. Capability increases from left to right. Green and red shading indicate where MAS outperforms or underperforms SAS-contextflow.")。 每张子图随能力从左到右,绿色区 = MAS 领先、红色区 = SAS-contextflow 领先。读者应注意三条轨迹随能力的收敛与交叉:在 $\delta\approx0$ 任务上 MAS 轨迹始终在上但差距收窄;在 TravelPlanner-HC 上三条线在强模型处发生红色翻转——这就是 Figure 1 预测曲线的实测版本。
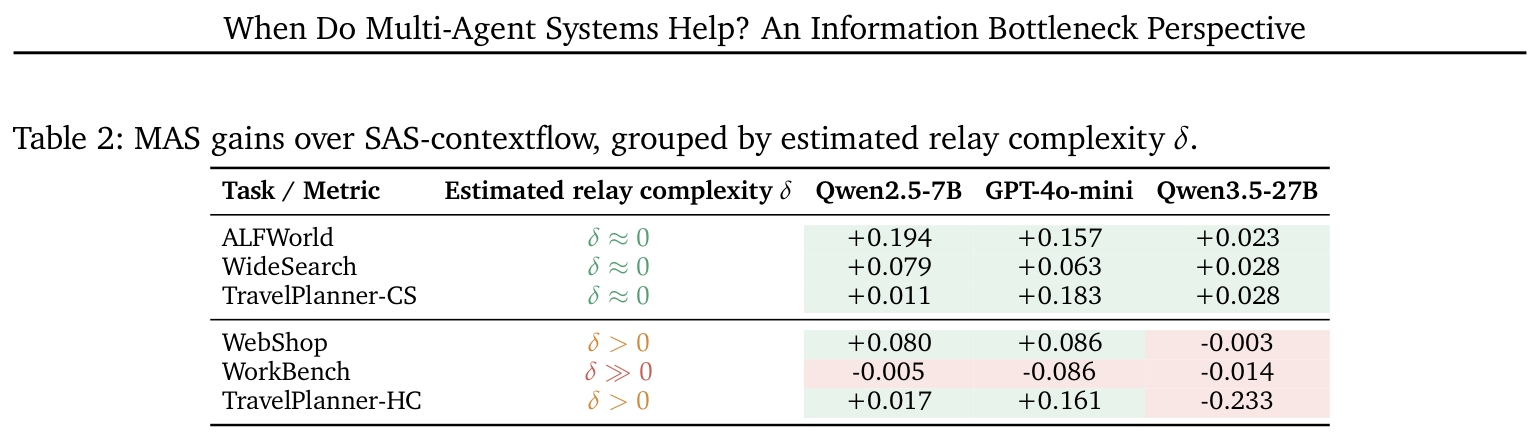
Paper's Table 2(MAS 相对 SAS-contextflow 的增益,按 $\delta$ 分组)。 这是全文最 load-bearing 的一张表:$\delta\approx0$ 的三行(ALFWorld/WideSearch/TravelPlanner-CS)跨三模型全为正;$\delta\gg0$ 的 WorkBench 三模型全负(−0.005/−0.086/−0.014);$\delta>0$ 的 WebShop、TravelPlanner-HC 呈能力依赖翻转(WebShop +0.080/+0.086→−0.003;TravelPlanner-HC +0.017/+0.161→−0.233)。符号结构与 Theorem 4.1 预测逐格吻合。
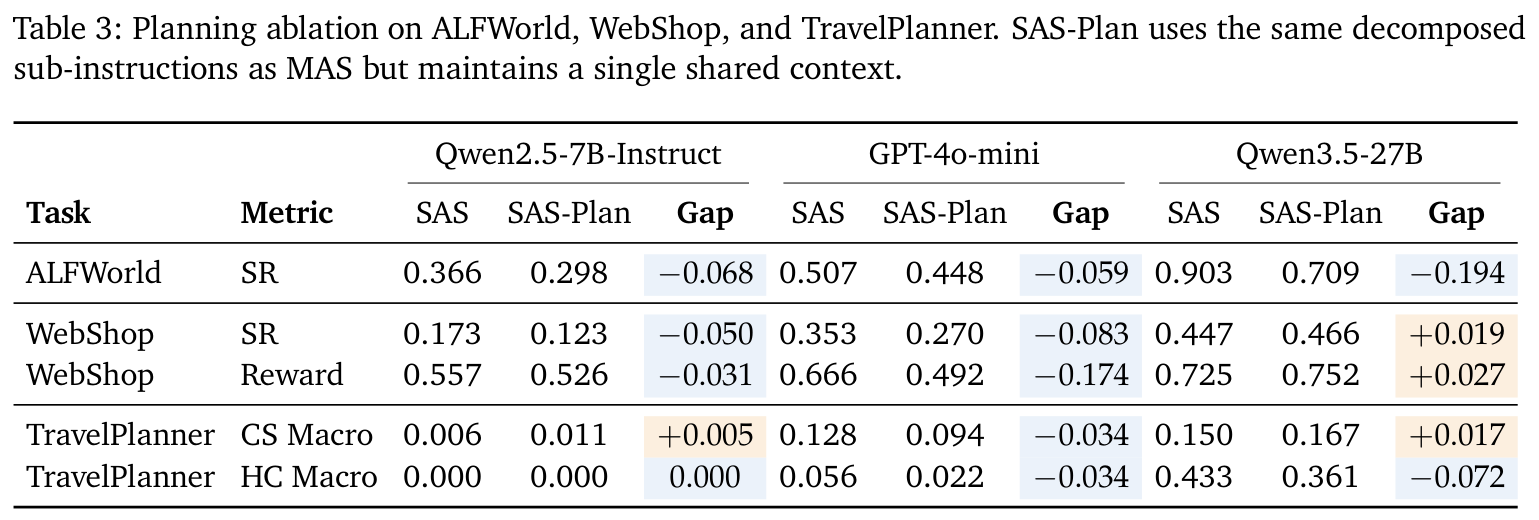
Paper's Table 3(SAS-Plan 消融:用与 MAS 相同的子指令分解,但维持单一共享上下文)。 关键反事实:若增益来自"分解结构本身",SAS-Plan 应当接近 MAS。实测 SAS-Plan 在 ALFWorld 上一致低于 SAS(−0.068/−0.059/−0.194),在 WebShop/TravelPlanner 上也普遍低于标准 SAS。结论:是上下文隔离、而非分解结构,驱动了 MAS 增益——这把"更多 agent/更多分解"的替代解释排除掉了。
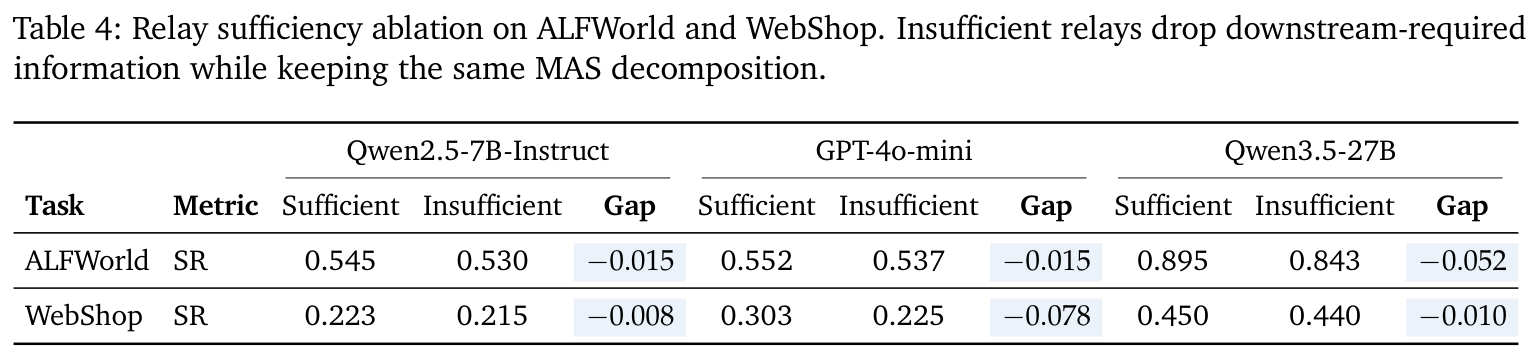
Paper's Table 4(relay 充分性消融:刻意从 relay 删去下游所需信息,保持相同 MAS 分解)。 把 $\Delta_i(m_i)$ 从"描述量"升级为"因果量"的唯一直接证据:ALFWorld 删去 location/object-state → SR 下降(−0.015/−0.015/−0.052);WebShop 只留 product name 丢弃价格/属性/导航 → SR 下降(−0.008/−0.078/−0.010)。信息损失增大则性能一致下降,支持 IB 预测。
关键数据小结:SAS-contextflow 常低于 SAS(如 ALFWorld 零样本 Qwen2.5-7B:0.172 vs 0.366),说明"强制结构化规划但不做 relay 隔离"反而有害——这也让 SAS-contextflow 成为一个偏严格的对照基线。
6. 论证链(paper-internal,≥3 步) #
| # | 论断 | 依据(paper-internal) | 推出 |
|---|---|---|---|
| 1 | MAS 与 SAS 的差异可归结为 planner 分解 + relay 通信两项结构差异 | §3 定义 SAS/MAS;relay $m_i=\text{Agg}_i(M_i)$ | 需把两者解耦才能定位真正机制 |
| 2 | 无限带宽下 MAS 可逐区间模拟任意 SAS,$y_{\text{MAS}}=y_{\text{SAS}}$ | Proposition 3.1 + §A.1 归纳证明 | 非平凡效应只能来自有界 relay 压缩,而非分解本身 |
| 3 | 每条 relay 是一个 IB:压缩上游 vs 保留下游相关性,由 $\beta$ 加权 | Eq.1 Markov 关系 → Eq.2 IB 目标 | 可对单接口写出增益表达式 |
| 4 | 局部增益 $G_i^{\text{MAS}} = H(M_i\mid m_i) - \beta\Delta_i(m_i)$ | Theorem 4.1(Eq.7,代数分解) | $G_i>0 \iff H(M_i\mid m_i)>\beta\Delta_i$(Eq.8) |
| 5 | 低 $\delta$ 任务 $\Delta_i\approx0$ → 增益恒正且随能力收窄 | Eq.10 的 $\delta$ 定义 + Table 2 的 $\delta\approx0$ 三行 | RQ1 成立 |
| 6 | 高 $\delta$ 任务 $\Delta_i$ 大 → 强模型(大 $\beta$)处成本项压过收益 → 翻转 | Table 2 的 WebShop/TravelPlanner-HC 能力依赖反转 | RQ2 成立 |
| 7 | 增益源是上下文隔离而非分解;$\Delta_i$ 是因果成本 | 消融 Table 3(SAS-Plan)+ Table 4(删字段) | 机制解释闭环 |
7. 实现 cross-reference #
代码公开:GitHub https://github.com/divelab/MAS-SAS(§0 Abstract 给出)。L1 未抓取仓库内文件行号,以下为 relay/prompt 设计的实现要点(源自 §D.1–D.4 的 prompt 规格):
核心技术壁垒复述(§2 Q2 指向此处):最难复制的洞察是把一个无显式目标的工程系统识别为隐式 IB 优化,并用单一有效参数 $\beta$(= 下游模型能力的代理)同时解释"弱模型受益、强模型受损"。其脆弱处也在此:$\beta$ 与 $\delta$ 均为定性赋值、未定量估计(§7 Limitations),因此理论在单模型粒度上不强可证伪——复制者若想定量校准,必须自行构造 $\beta$/$\delta$ 的估计器,这是论文明确留给未来工作的缺口。