Scaling LLM-Driven Multi-Agent Systems: Design Principles and Architectural Scalability Analysis
Scaling LLM-Driven Multi-Agent Systems — L2 #
1. TL;DR #
四条 MAS 设计原则 (简洁 / 弹性反馈 / 顺序工作流+可选回环 / 摘要通信) 落成受约束有向工作流图,在 terminal-bench 上扫描 4 档复杂度 × 多档 backbone。结论:只有 backbone 超过能力阈值时缩放才近线性提价换准确率,峰值在中间档 (MAS-M),run-to-run 一致性始终 <50%,是生产化真正的瓶颈。
2. Q1 / Q2 / Q3 #
Q1 — 痛点 (why) #
MAS 的架构设计空间庞大 (通信拓扑、agent 专业化、工作流编排、记忆架构) 但没有系统化的设计原则,缩放行为也只被局部理解。此前的缩放研究每次只变一个维度 (agent 数量、辩论轮数、反馈深度),并且集中在静态推理 benchmark 上报告平均成功率——准确率、成本、通信负载、run-to-run 一致性如何在一个连贯架构被有原则地缩放时联合演化,仍是空白,尤其是在交互式、工具密集的环境中。单 agent 又被三重上限约束:工作记忆受 LLM 上下文窗口限制、单一视角削弱鲁棒性、顺序运行封顶了任务跟随与并行度。
Agent scope:任务类别是 open-ended 的终端系统工程任务 (从基础 OS 操作到服务器管理与 SE 挑战);交互模式是 multi-turn (需在初始陌生环境中探索、执行工具、解读反馈并修正计划);自主性为 fully autonomous,但 group chat 预留了 human-in-the-loop 入口 (用户消息自动进入共享上下文)。
Q2 — 方法 (how) #
把从综述蒸馏出的四原则 (P1 简洁、P2 弹性反馈、P3 顺序工作流+可选回环、P4 摘要通信) 落成两个核心组件:(a) 一条摘要 group chat 通道——每个 agent 完成子任务后往通道追加一条自然语言摘要,后续 agent 继承全部累积历史,上下文因此线性增长;(b) 一个受约束的有向工作流图 $G_w=(A,E,s,T)$,出度上限 3,agent 通过在摘要末尾发 [ 标签自主决定何时结束、调用哪个后继,可选回环给复杂任务留出弹性、最短路径高效处理简单任务。四档配置 Singleton(1,0) → MAS-S(3,1) → MAS-M(5,3) → MAS-L(7,5) 每步加两 agent 两回环。
核心技术壁垒:不在任何单一机制 (摘要、共享消息池、顺序工作流都已有先例),而在于"摘要 group chat + 顺序工作流 + 完全不过滤的上下文访问 + agent 自主 [ 分派"这一特定组合,配上出度 ≤3 的形式化拓扑约束,使得缩放时上下文严格线性增长、且始终存在一条从起点到终点的最短可靠路径。复刻难点是让这套弹性回环真正被强 backbone 用起来——本文自己的数据显示强模型反而基本不用回环 (详见 §7)。
Q3 — 结果 (what) #
- 强模型 GPT-5-mini:准确率 Singleton→MAS-M 逐档提升,Singleton→MAS-S 单步涨幅最大 (相对 +15.2%),MAS-M 达峰并超过公开 leaderboard 上最好的单 agent;MAS-L 掉回 MAS-S 之下 (主要因执行超时)。
- 弱模型 GPT-5-nano:无一致缩放趋势,四档准确率近乎持平;MAS-S 相对 Singleton 甚至 −7.7%。
- SOTA 参照 GPT-5.3-Codex 在 MAS-M 上 $\mu=0.715$,处于 leaderboard 上 Codex 系 agent 的中游,证明架构有竞争力。
- 成本随复杂度近线性增长;AgentTimeout 随复杂度上升 (mini Singleton $\mu=3.33$ → MAS-L $\mu=50.00$)。
- 一致性:所有缩放档,全部跑通的任务中被"所有 run 都解出"的比例 <50%;这是最有生产后果的发现。
3. 架构 / 方法图 #
3.1 MAS 生命周期与 group chat 通道 #
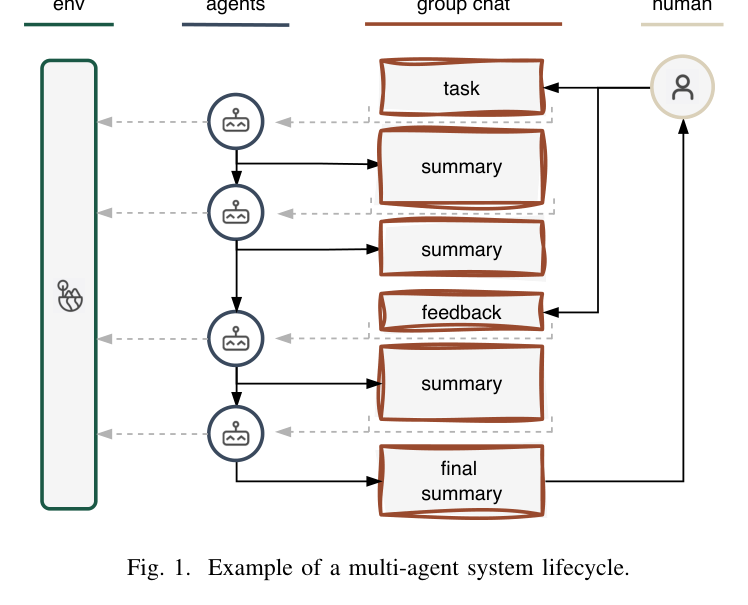
Paper's Figure 1, verbatim (caption: "Example of a multi-agent system lifecycle").
该图展示了核心执行环:chat 由用户任务初始化 → 当前活跃 agent 读取全部历史消息、完成工作、追加一条摘要 → 下一个 agent 继承这份被"富化"的上下文。读者应注意每个 agent 每步只贡献一条摘要,这正是上下文线性增长 (而非二次爆炸) 的机制来源,也是 P1/P4 的直接落地。
3.2 四档缩放拓扑 #
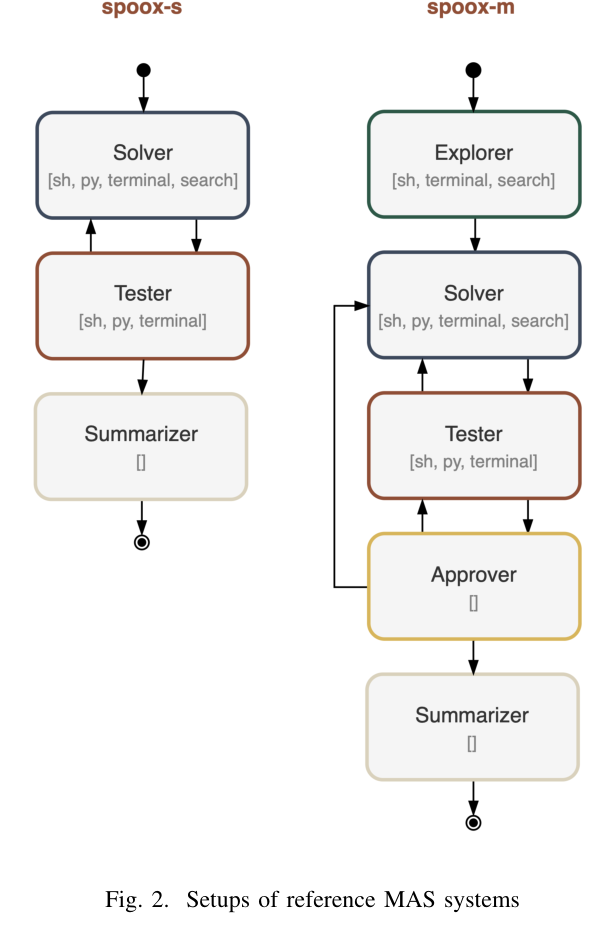
Paper's Figure 2, verbatim (caption: "Setups of reference MAS systems").
该图以 MAS-S 与 MAS-M 为例画出 agent 角色与工作流边/回环。注意 MAS-S 的核心是 Solver→Tester 的弹性回环 (Tester 决定退回 Solver 修订或前推给 Summarizer);MAS-M 在其前置加 Explorer 做结构化环境勘查、后置加 Approver 做整体复核 (可回环到 Solver 和 Tester)。这直观展示了"固定核心工作流 + 选择性插入回环"的 P3 设计。
3.3 单回合的 agent 循环 (state machine) #
原图为静态拓扑示意,缺少单回合内部状态转移,故用状态图补足结构清晰度:
- 记忆模型:短期=上下文窗口内的完整 group chat 历史 (无过滤);无向量库长期记忆;轨迹日志 (episodic) 用于事后 loop-utilization 统计。
- 工具调用:四个工具 (详见 §5),结果直接回灌到 agent 内部推理迭代;细节 trace 不外泄给后继 agent,只有最终摘要外泄 (P4)。
- 错误恢复:工具/验证失败时不回退到某个"检查点",而是把失败当作新的观测——Tester 认为需要时把控制权退回 Solver,走弹性回环重做。
3.4 Planning & reasoning #
- 规划风格:预定拓扑图 (predetermined graph) + 局部 ReAct——全局工作流由 $G_w$ 固定,单 agent 内部是 think-then-act 迭代;下一步分派由 agent 局部在候选后继中选择 (出度 ≤3)。
- 分解方向:top-down。MAS-L 把 solving 拆成 Sub-Task Planner + Sub-Task Solver,显式分离规划与执行。
- 预算:无显式 max-step/token 上限;实际由 terminal-bench 的任务超时 (AgentTimeout) 隐式封顶——这也是 MAS-L 掉分的直接来源。
- 回溯:可以,通过回环边退回较早阶段 (如 Sub-Task Planner 回退 Explorer 补充信息);但不能撤销已执行的写副作用工具动作。
4. 作者证明 #
无形式化作者证明 — 仅实证。 唯一的形式化对象是拓扑图的结构定义与三条约束 (保证工作流合法,而非保证成功率)。全文无收敛性 / 成功率界。可以被界定却未界定的量:给定出度上限与最短路径长度,理论上可对"每任务最少 LLM 调用数"给出下界,从而形式化连接成本与拓扑复杂度;论文只做了经验测量。
4.1 记号表 (拓扑形式化) #
| 符号 | 含义 | ||
|---|---|---|---|
| $G_w=(A,E,s,T)$ | 有向工作流图 | ||
| $A$ | agent (顶点) 非空集合 | ||
| $E$ | 定义工作流的有向边集合 | ||
| $s\in A$ | 指定起始 agent (任务提交后首个被调用) | ||
| $T\subseteq A,\ | T | >0$ | terminal agent 集合 |
| $(u,v)\in E$ | 从 agent $u$ 指向 agent $v$ 的有向边 |
4.2 方程物理意义 #
- 拓扑定义 $G_w=(A,E,s,T)$:把 MAS 拓扑形式化为单起点、≥1 终点的有向工作流图,作为三条约束的作用底座。
- 边合法性 $\forall\,(u,v)\in E:\;u,v\in A\wedge u\neq v$:每条边连接两个不同 agent,禁止自环 (agent 不能直接把自己当后继)。
- 约束 1 (非终端有后继) $\forall\,u\in A\setminus T:\;|\{(u,v)\in E\}|\geq 1$:非终端 agent 出度 ≥1,工作流不会在非终端处死锁。
- 约束 2 (非起点可达) $\forall\,v\in A\setminus\{s\}:\;|\{(u,v)\in E\}|\geq 1$:非起点 agent 入度 ≥1,无孤立/不可达 agent。
- 约束 3 (出度封顶) $\forall\,u\in A:\;|\{(u,v)\in E\}|\leq 3$:出度 ≤3,把每个 agent 需推理的后继选择空间控制在 3 以内,直接落地 P1。
4.3 六项最小核查 #
- 量纲/一致性:约束都作用于同一图 $G_w$;出度/入度均为无量纲计数,$\geq1$ / $\leq3$ 边界自洽。
- 边界退化:Singleton 档 $|A|=1$、$E=\varnothing$,此时不需要 group chat 与拓扑——论文明确说 Singleton 无 group chat/topology,与形式化定义一致 (约束在 $|A|=1$ 时空真)。
- 成功率 sweep 单调性:沿"backbone 能力"轴单调 (nano 平坦 / 无收益,mini 有收益,Codex 最高);沿"复杂度"轴非单调——Singleton→MAS-M 上升、MAS-M→MAS-L 下降 (峰在中间),作者自陈并归因超时+错误传播+回环未被触发。
- 每回合延迟预算:延迟=工具调用+LLM 推理+读 group chat。论文未宣称"交互式延迟",反而把执行总时间列为成本项,且超时是 MAS-L 掉分主因——即延迟预算是被动约束而非达标目标。
- 失败模式分类:论文识别的系统级失败源包括超时 (AgentTimeout)、错误在 agent 间传播、以及最主导的 run-to-run 不一致 (framing-lock);方法未针对性修复主导类 (一致性),反而在讨论里点名这是留给未来的核心问题。
- 成本增长核查:Table I 的 cost trend (以平均 completion tokens 计) 随档位近线性放大 (mini: baseline→+1×→+1.4×→+3.2×),与"上下文线性增长"设计口径方向一致 (回环触发会额外抬升,故 MAS-L 超线性)。
[标签分派:控制流不由外部编排器硬编码,而是 agent 在最终摘要里写一个尖括号标签,由一个 parser 检测标签→把摘要贴入 chat→触发下一 agent。这把"何时结束、调用谁"完全下放给 agent,是弹性的实现支点,也是回环是否被用起来的唯一开关。] - 完全不过滤的上下文访问 + 128×16 持久终端窗口:后续 agent 拿到的是全量累积 group chat (只做摘要级过滤,不做消息级筛选);且 Terminal 工具维持持久 tmux 会话、只回传一个异常小的 128×16 (16 行) 窗口——窗口高度极小是易被忽略的实现约束,可能影响 agent 对长输出的感知。
- 工具目录 (4 个):Shell (执行单条 Bash,环境非持久);Terminal (持久 tmux 会话,接受任意击键,回传完整 128×16 窗口);Python (定义并执行完整脚本);Search (基于 LangChain DuckDuckGoSearch,返回 top-4)。参数走自然语言/工具约定,非严格 JSON schema。
- 副作用:Shell/Terminal/Python 为写操作且不可逆 (真实文件系统副作用);Search 为只读。回环可退回较早阶段,但不能撤销已执行的写。
- 错误面:工具/验证失败作为新观测回灌给 agent,由 Tester 决定是否触发弹性回环重做——即 LLM 直接看到失败并自行决策,而非静默重试包装。
- 环境契约:terminal-bench 任务跑在隔离 Docker 中,可复现且有自动可验证判据;但 agent 系统本身跨 run 是随机的 (同任务同系统可能一次成一次败),这是一致性瓶颈的直接来源。
- 最低规模:存在明确能力阈值——GPT-5-nano 低于阈值,能触发通信/回环/消耗 token 却不产出更好解;GPT-5-mini 已跨过阈值可从缩放获益。
- 必需能力:工具使用 (三个模型均为 tool-use 优化)、多轮交互、遵循
[标签的结构化输出。] - backbone 敏感性:方法在同一模型家族内 (GPT-5-nano/mini/5.3-Codex) 才被验证,刻意保持家族恒定以隔离基座能力;跨 Llama/Qwen/Claude 的可移植性未测。
- 服务成本:成本随档位近线性 (以 completion tokens 计,MAS-L 达 baseline 的 +3.2×/+3.4×);论文以 LLM 调用数、prompt/completion tokens、总执行时间共同刻画成本画像。
- 拓扑:以顺序 pipeline 为骨、选择性插入回环边的有向图;非 hub-and-spoke、非 peer mesh。
- 协调:共享黑板 (group chat of summaries) + agent 自主分派,非点对点消息传递、非辩论。
- 角色专业化:靠 system prompt 区分 (Explorer/Solver/Tester/Approver/Summarizer/Sub-Task Planner/Sub-Task Solver/Refiner),缩放实验中全部 agent 用同一 backbone。
- 失败隔离:一致性瓶颈根因恰是缺乏隔离——下游 agent 强化上游 framing,错误在 agent 间传播而非被拦截。
- 生产化:工具执行经 Docker 隔离;密钥/鉴权与并发/限流控制未讨论;可观测性方面有 loop-utilization 轨迹日志,但非确定性 run 的可复现性正是被点名的未解问题。
5. 实验与数据 #
5.1 准确率随缩放 #
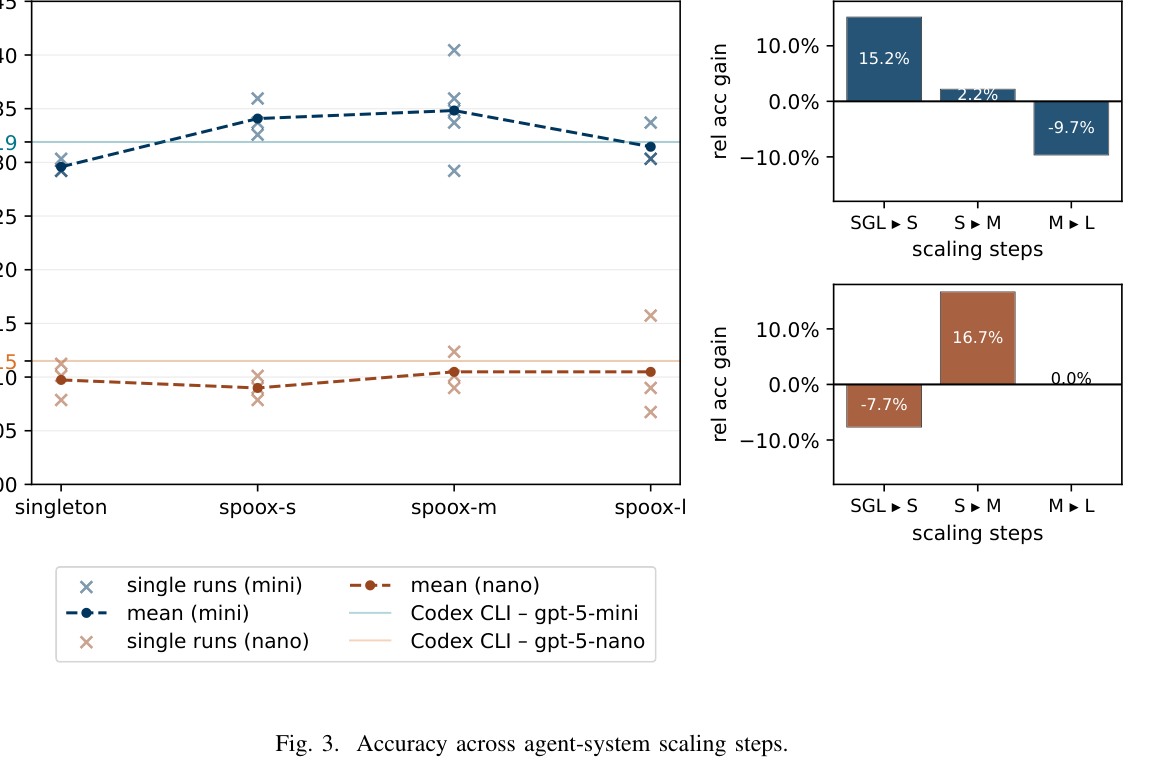
Paper's Figure 3, verbatim (caption: "Accuracy across agent-system scaling steps").
x 轴为缩放档 (Singleton→MAS-S→MAS-M→MAS-L),y 轴为成功试次占比;虚线为均值趋势,同色水平线为 21 July 2026 抓取的 terminal-bench leaderboard 领先 agent 参照,旁边柱状图为每步相对涨幅。读者应注意两条线的分岔:GPT-5-mini 呈"升到 MAS-M 达峰再跌"的倒 U,而 GPT-5-nano 几乎水平——这正是"backbone 能力阈值"论点的图形化证据。
Test-weighted accuracy (缓解 terminal-bench "一测挂全零" 的粗粒度):
| Model | Config | $\mu$ | $\sigma$ |
|---|---|---|---|
| GPT-5-mini | MAS-M | 0.543 | 0.024 |
| GPT-5-mini | MAS-S | 0.530 | 0.037 |
| GPT-5-mini | MAS-L | 0.518 | 0.013 |
| GPT-5-mini | Singleton | 0.514 | 0.014 |
| GPT-5-nano | MAS-M (peak) | 0.351 | 0.029 |
| GPT-5-nano | Singleton | 0.328 | 0.072 |
| GPT-5-nano | MAS-L | 0.320 | 0.114 |
| GPT-5.3-Codex | MAS-M | 0.715 | — |
5.2 一致性 (核心瓶颈) #
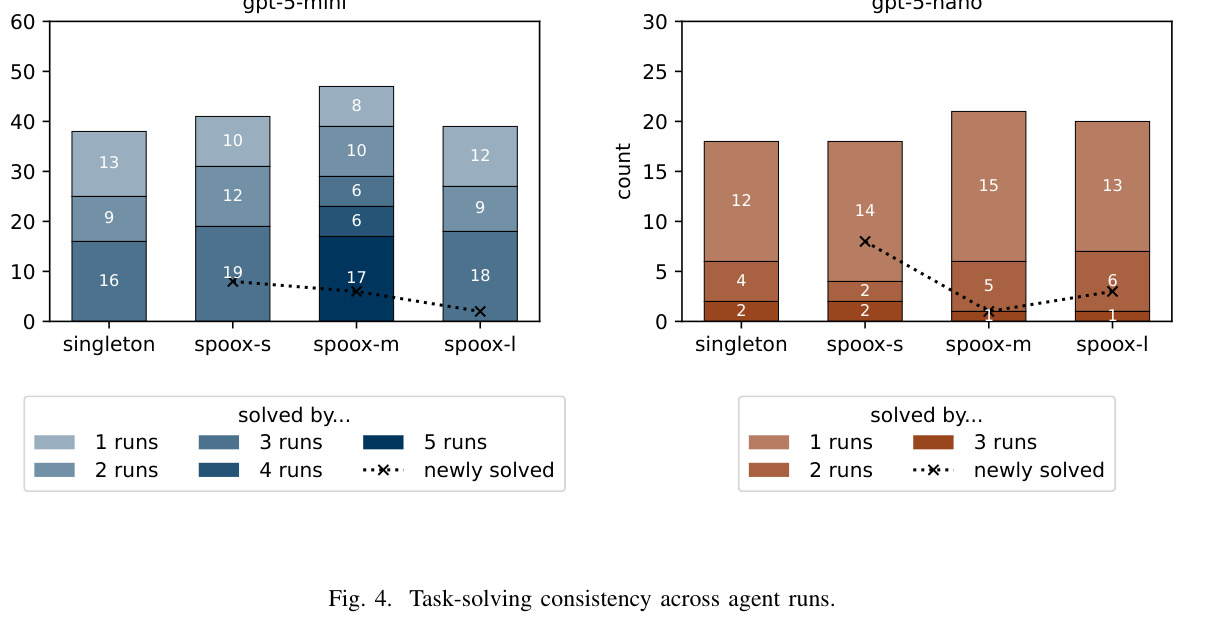
Paper's Figure 4, verbatim (caption: "Task-solving consistency across agent runs").
柱高=被 ≥1 run 解出的任务数,分段=有几个 run 解出,虚线=被 ≥1 run 解出但此前任何"更低档 (缩放更少)" agent 都没解出的任务数。关键观察:分段柱显示每档中不到一半的已解任务在所有 run 里都稳定解出;且"独有新增贡献"随缩放递减 (mini: MAS-S 8 → MAS-M 6 → MAS-L 2)——加复杂度带来的边际唯一价值在收缩。GPT-5-nano 更极端:所有 run 都解出的任务 MAS-M/MAS-L 仅 1 个。
5.3 主结果汇总 (Table I) #
| Model | System | Accuracy | Acc. $\Delta$ | Cost trend | Consistency |
|---|---|---|---|---|---|
| GPT-5 mini | Singleton | 0.296 | – | baseline | 42% |
| GPT-5 mini | MAS-S | 0.341 | +15.2% | +1× | 46% |
| GPT-5 mini | MAS-M | 0.348 | +2.2% | +1.4× | 36% |
| GPT-5 mini | MAS-L | 0.315 | −9.7% | +3.2× | 46% |
| GPT-5 nano | Singleton | 0.097 | – | baseline | 11% |
| GPT-5 nano | MAS-S | 0.090 | −7.7% | +1.1× | 11% |
| GPT-5 nano | MAS-M | 0.105 | +16.7% | +1.6× | 5% |
| GPT-5 nano | MAS-L | 0.105 | +0.0% | +3.4× | 5% |
注意 nano 的 MAS-M:mean accuracy 涨 +16.7% 但一致性掉到 5%——mean 上升而可靠性崩塌,恰好锐化了论文"一致性 vs 平均准确率"的自我论点。
5.4 超时与回环利用 #
| 指标 | GPT-5-mini | GPT-5-nano |
|---|---|---|
| AgentTimeout $\mu$ Singleton→MAS-L | 3.33 → 50.00 | 1.00 → 37.67 |
| MAS-S 无回环试次占比 | 71.9% (120/167) | 51.1% (92/180) |
| MAS-M 无回环试次占比 | 70.0% (180/257) | 45.1% (74/164) |
| MAS-M Approver 系回环触发 | 19 task runs | 14 task runs |
| MAS-L Refiner–Tester 回环触发 | 17 | 20 |
| MAS-L Approver–Tester 回环 | rare (1–2) | never triggered |
Benchmark:terminal-bench [44],>80 个端到端系统工程任务,隔离 Docker、可验证成功判据;pass@1 口径 (单 run 成功率) 为主,另加 test-weighted (通过单测占比) 与 consistency (多 run 稳定性)。Baselines:Singleton (被测 frontier 模型单 agent) 作为内部基线;外部对照为 terminal-bench 官方 leaderboard 领先 agent。
6. 论证链 #
| # | 步骤 | 依据 (paper-internal) |
|---|---|---|
| 1 | 单 agent 受上下文/视角/顺序三重上限约束,MAS 是自然出路,但设计空间无系统原则、缩放行为只被局部理解 | §I motivation + §II 综述缺口 |
| 2 | 从综述蒸馏四原则 P1–P4,落成两组件:线性增长的摘要 group chat + 受约束有向工作流图 $G_w$ (出度 ≤3、agent 自主 [ 分派、可选回环) | §III → §IV-A/§IV-B |
| 3 | 把架构实例化为 Singleton→MAS-S→MAS-M→MAS-L 四档递增复杂度,在 terminal-bench 上用多档 backbone 扫描准确率/成本/一致性/回环利用 | §V-D + §V-F |
| 4 | 观测:强 backbone (mini) 缩放近线性提价换准确率、峰在 MAS-M;弱 backbone (nano) 全程平坦甚至 MAS-S 负增长 → 存在最低能力阈值 | §VI-A + Table I |
| 5 | 观测:MAS-L 因超时上升掉回 MAS-S 之下,且回环 (尤其 Approver 系) 大量未被触发 → 复杂度峰值在中间档 | §VI-C + §VI-D |
| 6 | 观测:所有档一致性 <50%,唯一新增贡献随缩放递减 → 可靠性 (而非 mean accuracy) 是生产化真正障碍,归因下游 agent 强化上游 framing (framing-lock) | §VI-B + §VII |
7. 实现 cross-reference #
[实现未公开]。论文无公开代码仓与 file:line 可引用;agent profiling 完全经由 system prompt 设计实现,提示词本身也未随文发布 (仅描述 block-wise Markdown 结构:context / task-description / operational-rules 三块)。
7.1 核心技术壁垒 (最难复刻的一点) #
难点不是任一机制,而是让弹性回环在强 backbone 上真正被使用——本文最反直觉的数据是:越强的模型越少用为它设计的反馈机器。GPT-5-mini 在 MAS-M 有 70.0% 的试次完全不用任何回环 (nano 仅 45.1%),而设计用于最终质检的 Approver 系回环几乎休眠 (MAS-M 仅 19/14 task runs 触发,MAS-L 的 Approver–Tester 回环对 nano 从未触发)。复刻者若照搬拓扑,很可能得到一个"回环装置形同虚设"的系统。论文给出的机理是 framing-lock:当 Tester 认可了 Solver 的 (可能微错的) 解读,下游 Approver 缺乏推翻二者共识的依据——因此单纯合作式地叠 QA agent 会固化而非捕捉错误。破解需要给 QA agent 显式的对抗式指令 (主动探查、挑战、主动触发回环)。