When Does Disaggregation Pay? Simulating Prefill–Decode–Attention–FFN Specialization for Agentic LLM Inference
When Does Disaggregation Pay? — PDAF 四路解耦的成立条件 #
1. TL;DR #
HeteroPanacea 用 roofline + 离散事件模拟扫描 PD/AF/PDAF 解耦。结论是条件性的:只有 $I/O\ge10$ 的 prefill-heavy agentic 负载才越过不解耦基线,且四路拆分只在硬件目录能给 attention 与 FFN 真正不同的器件时才赢 —— 商用 GPU 做不到。
2. Q1 / Q2 / Q3 #
Q1 痛点:agentic 循环把"阶段不匹配"从跨相推到了相内 #
Agentic 工作负载(computer-use、coding、web agent)每一轮都把截图、网页内容、代码上下文、工具调用结果重新塞回 prompt,于是几乎每一轮都要对一个不断变长的上下文重新 prefill。OSWorld 上下文平均 38K token、峰值可达 100K,比 chatbot 会话高出一个数量级以上。
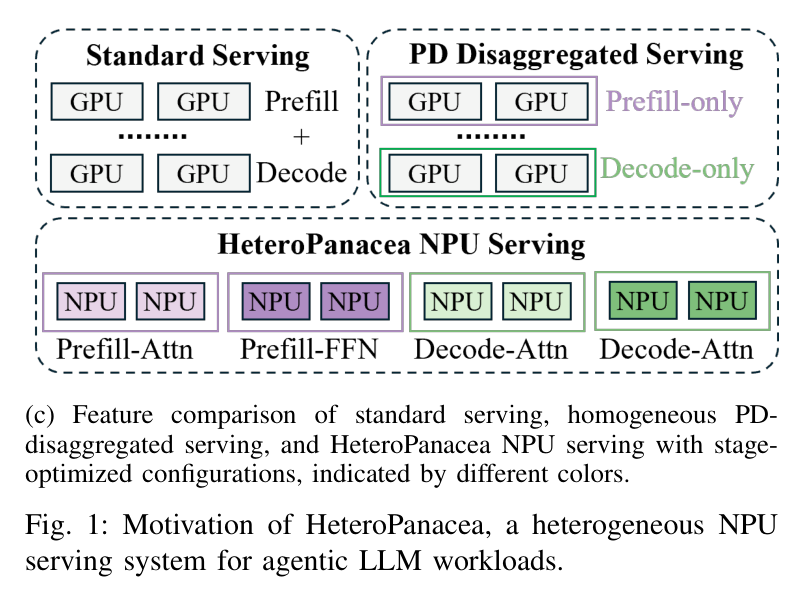
Paper's Figure 1, verbatim (caption: "Motivation of HeteroPanacea, a heterogeneous NPU serving system for agentic LLM workloads." (a) Agentic workloads have larger token usage. (b) System performance comparison of different serving systems, split into prefill and decode throughput. (c) Feature comparison of standard serving, homogeneous PD-disaggregated serving, and HeteroPanacea NPU serving with stage-optimized configurations, indicated by different colors.).
子图 (a) 给出 agentic 与标准负载的 token 用量对比,(b) 在同等功耗预算与请求率下显示 PD 解耦在 agentic 负载上带来 $1.82\times$ 吞吐、而在 chatbot 负载上只有 $1.29\times$ —— 读者要注意的是这个差值本身,它说明解耦的收益是被工作负载形状放大出来的,而不是模型固有的。(c) 则预告了本文真正的主张:每个阶段可以拿到不同的器件配置。
痛点的第二层比第一层更关键。PD 解耦只是流水线上最粗的一刀,它把 prefill 和 decode 各自当成整体。但每一相内部都还有 attention 和 FFN 两个计算子层,二者的资源画像分歧得和 prefill/decode 之间一样尖锐:
- decode 侧:decode-attention 的成本由读取随上下文增长的 KV cache 主导,是带宽受限、容量饥渴的子阶段;decode-FFN 的成本则由流式读取权重矩阵主导,且 MoE 每 token 只激活少量专家,要打满 FFN 利用率就必须把 batch 聚合到每个激活专家都看到足够 token 的程度,路由越稀疏所需 batch 越大。在任何固定服务 batch 下,稀疏度上升会拉低 FFN 的有效算术强度,把它推到 roofline 上和 attention 不同的位置。
- prefill 侧:两个子层都是计算受限,但强度仍然分岔 —— attention 的计算随序列长度二次增长($QK^{\top}$ 与 $\mathrm{softmax}(\cdot)V$ 两项),FFN 则是随 token 数(MoE 还随路由)线性增长的稠密 GEMM。
于是在 PD 之下,"decode 节点"仍然把 DA 和 DF 这两个理想计算/带宽比不同的子阶段按在同一块物理器件上,选出来的硬件必然对一个尺寸正确、对另一个浪费产能。而这个残余错配还在变宽:长上下文与 agentic 反复重新 prefill 抬高 KV 体积从而抬高 DA 的带宽需求,DF 的成本却由专家数与路由稀疏度支配,两股压力朝不同方向走。
Q2 方法:把四个子阶段变成独立可供给的资源池,再用两阶段搜索定型 #
论文提出 PDAF —— 把推理分解为 prefill-attention (PA)、prefill-FFN (PF)、decode-attention (DA)、decode-FFN (DF) 四个解耦阶段,每个阶段独立分配硬件、并行度和数值精度。PDAF 在结构上包含两种粗粒度方案:在 prefill 与 decode 内部各自合并 attention/FFN 就退化成 PD,在 attention 与 FFN 内部各自合并 prefill/decode 就退化成 AF。
要在这个空间里做决策,唯一可行的手段是模拟。HeteroPanacea 由三层构成:
- 器件模型:每个加速器用一小组峰值规格刻画 —— 峰值算力 $F$ (TFLOPS)、七类存储技术之一及其配对的容量 $C$ (GB) 与带宽 $B$ (GB/s) —— 之上跑 roofline 执行模型。功耗按 $P=P_{\mathrm{compute}}+P_{\mathrm{mem}}$ 建模,计算项服从锚定 H100 数据手册的次线性幂律。
- 互连模型:同样的 roofline 哲学,字节数除以带宽,但暴露两个带宽域 —— D2D(TP/EP 集合通信、节点内 PP 交接)与 N2N(跨解耦边界的 KV cache 与激活传输)。
- 两阶段搜索:Phase 1 用解析容量分数对每阶段硬件候选排序并按功耗预算与权重驻留能力剪枝,Phase 2 把预算切给各阶段、取瓶颈分数排名,只有 top-$K$ 才真正端到端模拟。
- NPU 设计空间:在 $I/O=0.01$ 与 $I/O=1$,八个模型无一例外是 ND 最强,PD/AF/PDAF 全部低于 $1.00\times$(最好的是 GPT-OSS 在 $I/O=1$ 的 PD,$0.89\times$,仍未过线)。到 $I/O=100$ 排名翻转:PDAF 八个模型全部越过 ND($1.05$–$1.92\times$),PD 八中有七,PDAF 在六个模型上是最优模式。
- 穿越点极窄:模型平均的 PDAF 收益在 $I/O=1$ 时是 $0.48\times$,到 $I/O=10$ 已经是 $2.10\times$ —— 4.4 倍的摆幅压缩在一个十倍程内。此后并非单调:在 $I/O=10$ 到 $500$ 之间维持 $1.5$–$1.8\times$ 的平台,到 $I/O=1000$ 回落到 $1.27\times$。
- GPU 上结论反转:换成商用 GPU 目录后,PD 在 $I/O=0.01$ 就已八个模型全部超过 ND($1.18$–$2.50\times$),但在 $I/O=100$ 时 PD 在六个模型上追平或胜过 PDAF —— 与 NPU 上的排名恰好相反。
- AF 单独用永远不行:在两个设计空间、所有比值、所有模型上,AF 从未超过 ND(NPU 上 $0.20$–$0.65\times$,GPU 上最好 $0.96\times$)。
- 量化敏感性是工作负载属性:Qwen3.5-32B 上,把任一 FFN 阶段降到 4 bit 会重创 GSM8K(47% / 15%)而 BFCL 基本不动;把任一 attention 阶段降到 4 bit 则反过来把 BFCL 腰斩(11–12%)而 GSM8K 不降反升。
- PDAF 收益随 decode-attention KV 流量单调上升。
kv_lora_rank从 128 扫到 4096,三个模型的收益分别 +100%(GPT-OSS,$0.93\to1.85\times$)、+147%(GLM-4.6,$0.81\to2.00\times$)、+67%(DS-V4-Flash,$1.17\to1.96\times$)。注意这个方向上 DA 算术强度是下降的(从 10.7 降到 1.8),因为 FLOP 与 rank 无关而 KV 字节随 rank 增长。机制:rank=128 时 KV 项太小,DA 是权重读主导,结构上与 DF 无法区分,AF 拆分无物可分,PDAF 在两个模型上跌破 ND。 - 容量增长基本免费。固定激活专家数而扩大总专家数,只增加驻留权重的容量需求。四倍专家数只让 GLM-4.6 动 +3%、DS-V4-Flash 不到 0.5%(四个点全平在 $1.41\times$)。
- 激活计算增长是唯一削弱 PDAF 的因子。
num_active_experts增至 4× 时 DS-V4-Flash 损失 69%($1.41\to0.43\times$)、8× 时 73%($0.38\times$);GLM-4.6 在 8× 时崩 60%($0.78\times$)。同一 $\mathrm{ex}\cdot k$ 计算代理的另一杠杆ffn_expansion复现了排序但没复现量级(−31% / −19% / −10%),比激活专家杠杆温和一个数量级 —— 这在量级上证伪了严格的 $\mathrm{ex}\cdot k$ 等价预测。 - 降精度不是一致有益。从 4 字节/元素降到 0.5,GPT-OSS +57%($1.54\to2.43\times$),GLM-4.6 −41%($2.20\to1.29\times$),DS-V4-Flash −42%($1.47\to0.85\times$,跌破 ND)。机制:精度同时缩放所有阶段的权重字节项,是否有利取决于它加宽还是收窄 DA 与 DF 之间的差距。
核心技术壁垒:真正难以复制的不是 roofline 本身(那是教科书内容),而是把"何时该拆"这个二元决策还原成 DA 与 DF 两个 roofline 位置之间的间隙宽度,并证明这个间隙可以被三类完全不同的外生变量独立地打开或关上:工作负载形状($I/O$ 比)、硬件目录的自由度(算力与带宽能否解耦调节)、模型架构参数(kv_lora_rank / num_active_experts / dtype_bytes)。论文的五因子受控消融把这三类变量拉到同一个可比的 $\times$ND 标尺上,从而得到一个统一解释:PDAF 的收益严格正比于 DA 与 DF 的资源画像差距,每个因子都只按它加宽还是收窄这个差距来估值。这套"用一个几何量统一解释三类异质变量"的还原,是任何单纯复现模拟器的人拿不到的东西。
Q3 结果:收益存在,但被三重条件夹住 #
3. 架构 / 方法图 #
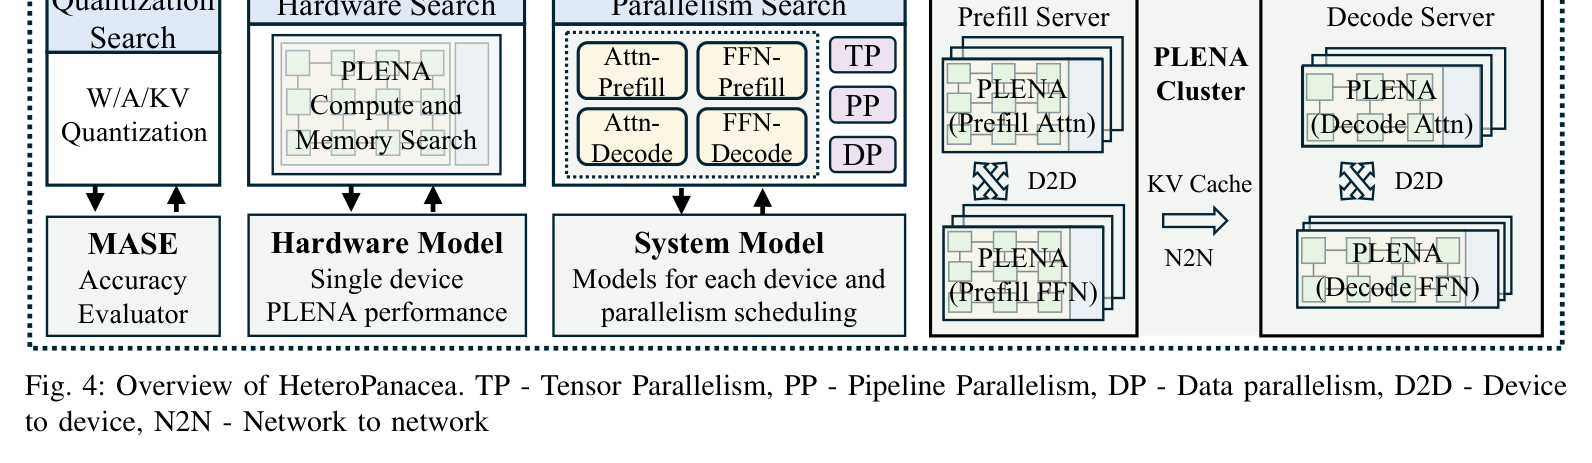
Paper's Figure 4, verbatim (caption: "Overview of HeteroPanacea. TP - Tensor Parallelism, PP - Pipeline Parallelism, DP - Data parallelism, D2D - Device to device, N2N - Network to network").
这张总览图给出模拟器的三层组织:模型/工作负载规格进入,经过并行度与解耦模式的配置,落到器件与互连的 roofline 求值上。读者应当注意 D2D 与 N2N 被显式区分为两条独立带宽路径 —— 这正是解耦开销的建模入口,因为跨阶段的 KV 与激活传输走 N2N,而阶段内的 TP/EP 集合通信走 D2D,二者在 §VI-B 的假设下相差 72 倍(NVSwitch 3600 GB/s 对 Infiniband 50 GB/s)。
四路解耦下一个请求的生命周期与状态回退如下:
图中三处是本文特有的:(i) PA→PF 与 DA→DF 之间的传输在合并模式下退化为零成本本地调用,这就是 PD/AF/PDAF 四种拓扑共用一套引擎的方式;(ii) Backpressure 分支对应 decode 侧"受可用 KV 容量约束的 FIFO 准入",是唯一显式建模的排队点;(iii) DA↔DF 每层往返一次,这正是 §II-A 指出的 AF 代价 —— 更小更频繁的网络流量,且两侧每阶段时延必须近乎精确匹配,否则流水线停顿。
方法侧的四个可调轴,逐阶段独立:
| 轴 | 每阶段自由度 | 约束 |
|---|---|---|
| 硬件 | $(F, C, B)$,6 个算力档 × 13 个存储工作点 | 总功耗 $\le P_{\mathrm{budget}}$;须能驻留权重 |
| 并行 | $(t, p, d, e)$ | $t\cdot p\cdot d\le N_{\text{pool}}$ |
| 精度 | $q_s\in\mathcal{Q}$,如 $\{4,8,16\}$ | 仅当基准无精度损失才降位宽 |
| 副本 | 数据并行度 $d$ | 计入上式乘积 |
注意 $e$ 不进入乘积约束 —— 专家并行是把专家切到已被其他并行度计数的器件上,不额外占用器件预算。
4. 作者证明 #
本文无形式化收敛或最优性证明 —— 结论为实证。它没有定理,没有界,没有关于两阶段搜索能否找到全局最优的任何陈述。但它确实建立了一套解析代价模型,下面对其符号、物理意义与自洽性逐项检查。
4.1 符号表 #
| 符号 | 含义 | 出处 |
|---|---|---|
| $F$ | 器件峰值算力(TFLOPS,精度无关) | §IV-B |
| $C, B$ | 单器件存储容量 (GB) 与带宽 (GB/s) | §IV-B |
| $\Phi, \beta$ | 某阶段的 FLOP 数与字节数,由模型结构解析导出 | Eq. (1) |
| $F_{\mathrm{eff}}, B_{\mathrm{eff}}$ | 经 TP/PP 缩放后的有效算力与带宽 | Eq. (1) |
| $\alpha$ | 计算功耗幂律的次线性指数(数值未披露) | §IV-B |
| $t, p, d, e$ | TP / PP / DP / EP 度 | §IV-D |
| $E, k$ | MoE 总专家数、每 token 激活专家数 | §IV-D |
| $\lambda, O$ | 请求到达率、输出长度 | §V-B |
| $\Lambda_s$ | 阶段需求率:prefill 为 $\lambda$,decode 为 $\lambda O$ | Eq. (2) |
| $\sigma(\mathrm{hw})$ | 硬件候选的容量分数 | Eq. (2) |
| $\mathbf{q}$ | 四阶段精度分配 $(q_{\mathrm{PA}},q_{\mathrm{PF}},q_{\mathrm{DA}},q_{\mathrm{DF}})$ | §V-A |
| $\mathrm{ex}$ | ffn_expansion | §VI-E |
4.2 方程的物理意义 #
Eq. (1) roofline 时延:$t=\max\!\left(\frac{\Phi}{F_{\mathrm{eff}}},\;\frac{\beta}{B_{\mathrm{eff}}}\right)$
取 $\max$ 而非求和,编码的是计算与访存完全重叠的假设:阶段被更稀缺的那种资源限制,永不被二者之和限制。代价是模型对重叠是构造性乐观的,无法表达部分重叠区。论文自陈此粒度以下不建模排队、kernel launch、occupancy。这是整个模拟器唯一的时延原语,§VI 每一个吞吐数字都是它的复合。
功耗分解:$P=P_{\mathrm{compute}}+P_{\mathrm{mem}}$,其中 $P_{\mathrm{compute}}=P_{\mathrm{ref}}\,(F/F_{\mathrm{ref}})^{\alpha}$
这里用加法而非 $\max$,因为两个子系统同时耗电;与 Eq. (1) 的 $\max$ 形成刻意对照。$\alpha<1$ 使算力翻倍的功耗代价不足两倍,编码工艺与架构进步。它直接决定 20k TFLOPS 档相对 25 TFLOPS 档有多贵,从而决定 Table V 中哪些逐阶段分配是负担得起的。
并行约束:$t\cdot p\cdot d\leq N_{\text{pool}}$。TP 线性放大 $F_{\mathrm{eff}}$ 与 $B_{\mathrm{eff}}$,代价是每个 attention 输出投影与 FFN 下投影后的一次 ring all-reduce;PP 不降低单请求计算,其吞吐收益完全来自微批重叠;DP 完全在 roofline 之外,是调度层的独立副本,无通信项。
EP 流量分数:$\frac{e-1}{e}$ —— 与给定 token 不共址的专家比例,即 dispatch/combine 体积中真正要过网的部分。它随 $e$ 增长饱和到 1,所以 all-to-all 体积有硬上界而非无限增长。
容量分数:$\sigma(\mathrm{hw})=d\cdot\frac{\mathrm{tput}(B)}{\Lambda_{s}}$ —— 供给除以需求,$\sigma\ge1$ 表示该候选跟得上该阶段的负载。$\Lambda_s$ 中 prefill 用 $\lambda$、decode 用 $\lambda O$ 的不对称,恰是 decode 工作量被 $O$ 倍放大的解析形式:每请求一次 prefill、$O$ 步 decode。
联合质量:$\sigma_{\mathrm{joint}}=\min_{i=1,\dots,k}\sigma_{i}$ —— 取 $\min$ 而非和或均值,因为解耦流水线以最慢阶段的速率运行。这是 §II-A 对 AF 提出的流水线平衡要求的形式化编码。
最终选择:$\mathrm{cfg}_{\mathcal{M}}^{\star}=\operatorname*{arg\,max}_{\mathrm{cfg}\,\in\,\mathrm{top}\text{-}K}\mathrm{tok/s}(\mathrm{cfg})$ —— 解析分数只做过滤,决策落在模拟 tok/s 上。
4.3 六项最低检查 #
检查 1 · 量纲一致性。Eq. (1) 两项分别是 FLOP/(FLOP·s⁻¹) 与 byte/(byte·s⁻¹),均为秒,$\max$ 合法。Eq. (2) 中 $\mathrm{tput}(B)$ 单位是 token/s、$\Lambda_s$ 是 token/s(prefill 为 req/s × 输入长度,decode 为 req/s × $O$),$\sigma$ 无量纲,与"$\sigma\ge1$ 即跟得上"的判据自洽。通过。
检查 2 · 边界行为。$k=1$ 时 $\sigma_{\mathrm{joint}}=\sigma_1$,Eq. (3) 正确退化到 ND;$e=1$ 时 EP 流量分数为 0,正确表示单器件持有全部专家时无 all-to-all;$e\to\infty$ 时趋于 1 而非发散。$\Phi\to0$ 时 Eq. (1) 退化为纯带宽界,与 decode 单 token 的直觉一致。通过。
检查 3 · 单调性。沿 $F$ 增大,Eq. (1) 的计算项单调下降而带宽项不变,故 $t$ 非增 —— 加算力不会变慢,符合 roofline。沿 $\Lambda_s$ 增大 $\sigma$ 单调下降。但实测吞吐并不单调于 $I/O$:Fig. 5 在 $I/O=10$ 达峰 $2.10\times$,随后落入 $1.5$–$1.8\times$ 平台,$I/O=1000$ 时降到 $1.27\times$。论文给出的机制是 prefill 大到成为瓶颈后,为 decode 单独供给的硬件越来越闲。这与模型结构一致(Eq. 3 取 $\min$,瓶颈转移即联合质量下降),非矛盾。通过,但需注意"prefill 越重越该解耦"是错的。
检查 4 · 与实测的校准误差。Table III 中 TP/PP 的 Sim/Real 落在 $0.67\times$–$1.06\times$;Table IV 中 PP 点对点随规模从 $0.82\times$ 收敛到 $1.00\times$,而 EP all-to-all 反向发散到 $1.21\times$。且两个原语在每个 token 数上的模拟值完全相同(55 / 437 / 3,495 μs),说明二者共用一套带宽模型,该模型拟合了 PP 而没有拟合 EP。这对重度依赖 EP 的 MoE decode-FFN 结论构成系统性偏差来源,论文未讨论。部分通过 —— 存在未论证的误差不对称。
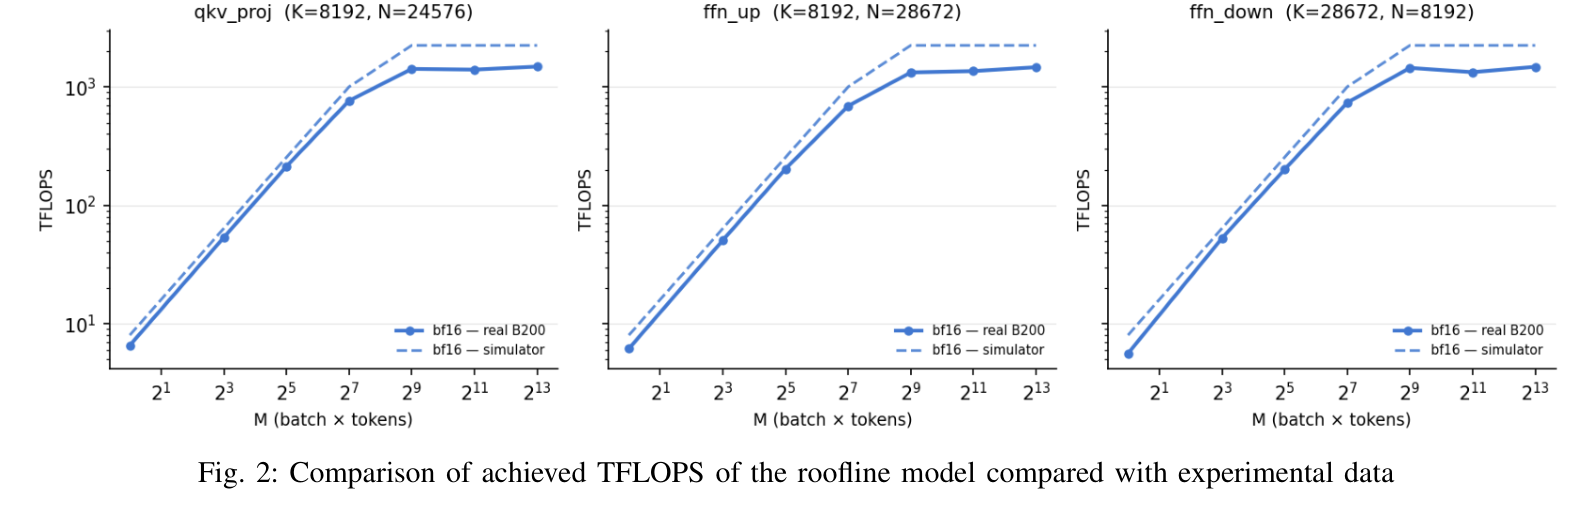
Paper's Figure 2, verbatim (caption: "Comparison of achieved TFLOPS of the roofline model compared with experimental data").
这是 Eq. (1) 的唯一直接验证:把 roofline 预测的达成 TFLOPS 与 8×B200 上 cuBLAS/torch._scaled_mm 的实测值并置。读者应注意它验证的是算子级吞吐,不覆盖调度与批处理 —— 论文在 §VII 明确承认端到端行为未验证。
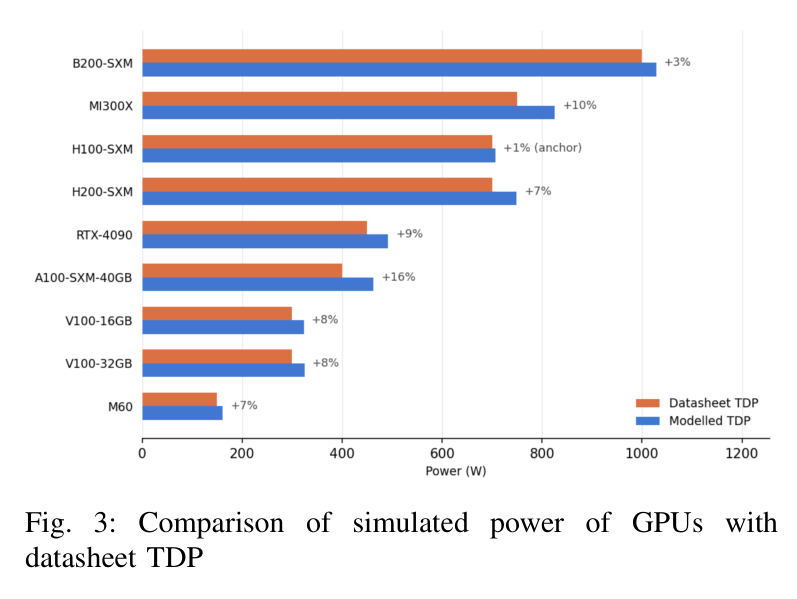
Paper's Figure 3, verbatim (caption: "Comparison of simulated power of GPUs with datasheet TDP").
功耗模型是整个 NPU 搜索的约束而非目标,因此它的误差直接决定哪些逐阶段配置被判为可行。这张图是 $P=P_{\mathrm{compute}}+P_{\mathrm{mem}}$ 与次线性指数 $\alpha$ 的全部经验支撑,而 $\alpha$ 仅由三代三款真实加速器拟合得到,数值未披露。
检查 5 · 内部数字自洽性。论文在三处给出三个不同的头条增益且未调和:摘要的 75%(GPU)、§I Fig. 1(b) 的 $1.82\times$、§I 贡献三的 $2.06\times$。其中 $2.06\times$ 在 §VI 中再未出现。此外 Vera Rubin 的阶段分配在 §I(Rubin 做 prefill + decode-attention,Groq LPU 做 decode-FFN)与 §VI-B("Groq LPU for prefill and Rubin GPU for decode")中互为反向。Table II 标题称每种存储技术贡献 2–5 个点、正文称七类技术,而表中只列出五类。不通过 —— 存在多处未调和的内部不一致。
检查 6 · 假设审计(模型能表达什么、不能表达什么)。不能表达:排队、kernel launch、occupancy、部分重叠、端到端调度与批处理效应。DP 被完全移出 roofline,作为调度层纯乘数,因此副本间的负载不均无法体现。$\sigma$ 的两阶段搜索是贪心的(每片选达到 $\sigma\ge1$ 的最便宜候选,余额补给最弱阶段),没有任何关于该启发式与全局最优差距的论证,$K$ 的取值也未给出。最关键的是:§VI-A 明确说 §VI-B/§VI-C 的吞吐扫描全部在全精度下运行,因为量化 MoE 模型的计算成本过高 —— 所以 §V-B 描述的"量化搜索产出 $\mathbf{q}^{\star}$ 喂给硬件搜索"这条组合流水线,在全文任何地方都没有被端到端执行过。通过(限制均被识别,其中第三条为论文自陈之外的推论)。
本可以被界定却没有的量:给定 DA 与 DF 的 roofline 位置(算术强度 $\Phi/\beta$),PDAF 相对 PD 的收益上界完全可以写成一个关于二者算术强度比值与功耗预算的闭式表达。论文在 §VII 自己指出了这个方向("PDAF 的收益很大程度上可由模型的 decode-attention 算术强度与激活 FFN 计算量预测"),却把它留作未来工作。
5. 实验与数据 #
5.1 设置 #
八个模型(DeepSeek-V4-Pro / -Flash、Llama-3.1-405B、Llama-4-Maverick / -Scout、GLM-4.6、GPT-OSS、Qwen3-235B-A22B),输出长度固定 1000 token,输入长度按目标 $I/O$ 缩放,逐请求长度取以目标为中心的正态分布。每个配置模拟 500 请求,固定速率 125 req/s。输出长度由在真实模型上跑 BFCL 与 GSM8K 标定。NPU 扫描以功耗为预算,GPU 扫描以 USD/hr 为预算 —— 两次扫描并非同一种货币约束,这一点在对比时必须记住。
5.2 穿越点在哪里 #
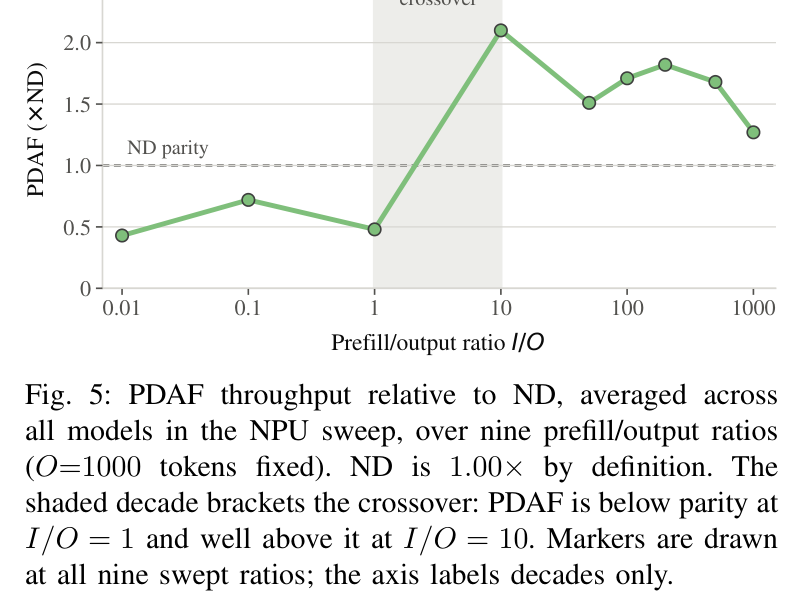
Paper's Figure 5, verbatim (caption: "PDAF throughput relative to ND, averaged across all models in the NPU sweep, over nine prefill/output ratios ($O{=}1000$ tokens fixed). ND is $1.00\times$ by definition. The shaded decade brackets the crossover: PDAF is below parity at $I/O=1$ and well above it at $I/O=10$. Markers are drawn at all nine swept ratios; the axis labels decades only.").
这是全文最有信息量的一张图。读者应注意三件事:曲线在 $I/O=1$ 与 $I/O=10$ 之间从 $0.48\times$ 跳到 $2.10\times$,穿越被压缩在一个十倍程内;峰值出现在穿越点紧后而非 prefill 最重处;$I/O=1000$ 回落到 $1.27\times$,因为 prefill 已成瓶颈、单独供给的 decode 硬件闲置。Agentic 负载恰好落在这个区间中部,而不是两端 —— 这是论文把 agentic 作为目标场景的量化依据。
| $I/O$ | PDAF ($\times$ND,模型平均) |
|---|---|
| 1 | 0.48 |
| 10 | 2.10 |
| 10 → 500 | 平台 1.5 – 1.8 |
| 1000 | 1.27 |
5.3 NPU 设计空间:PDAF 在 prefill-heavy 区胜出 #
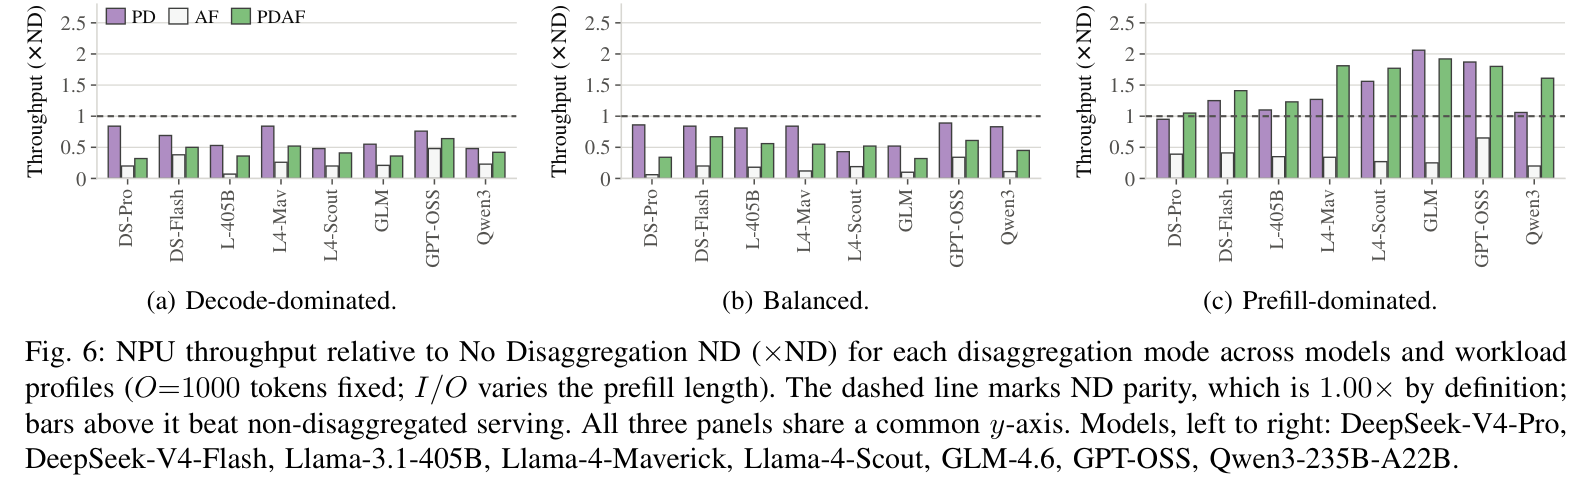
Paper's Figure 6, verbatim (caption: "NPU throughput relative to No Disaggregation ND ($\times$ND) for each disaggregation mode across models and workload profiles ($O{=}1000$ tokens fixed; $I/O$ varies the prefill length). The dashed line marks ND parity, which is $1.00\times$ by definition; bars above it beat non-disaggregated serving. All three panels share a common $y$-axis. Models, left to right: DeepSeek-V4-Pro, DeepSeek-V4-Flash, Llama-3.1-405B, Llama-4-Maverick, Llama-4-Scout, GLM-4.6, GPT-OSS, Qwen3-235B-A22B." Panels: (a) Decode-dominated. (b) Balanced. (c) Prefill-dominated.).
面板 (a) 与 (b) 里所有柱子都在虚线下方 —— 在 decode 主导与均衡负载下,八个模型没有任何一个解耦模式打得过不解耦。只有面板 (c)($I/O=100$)柱子才越线。
| 模式 | 超过 ND 的模型数 | 范围 ($\times$ND) |
|---|---|---|
| PDAF | 8/8 | 1.05 – 1.92 |
| PD | 7/8(DeepSeek-V4-Pro 为 $0.95\times$) | 未给出范围 |
| AF | 0/8 | 0.20 – 0.65 |
AF 单独用从未越线,但包含 AF 拆分的 PDAF 却在 6/8 模型上最优 —— 这意味着 AF 拆分的价值条件于 PD 拆分已经存在。
5.4 GPU 目录:同一模拟器,相反结论 #
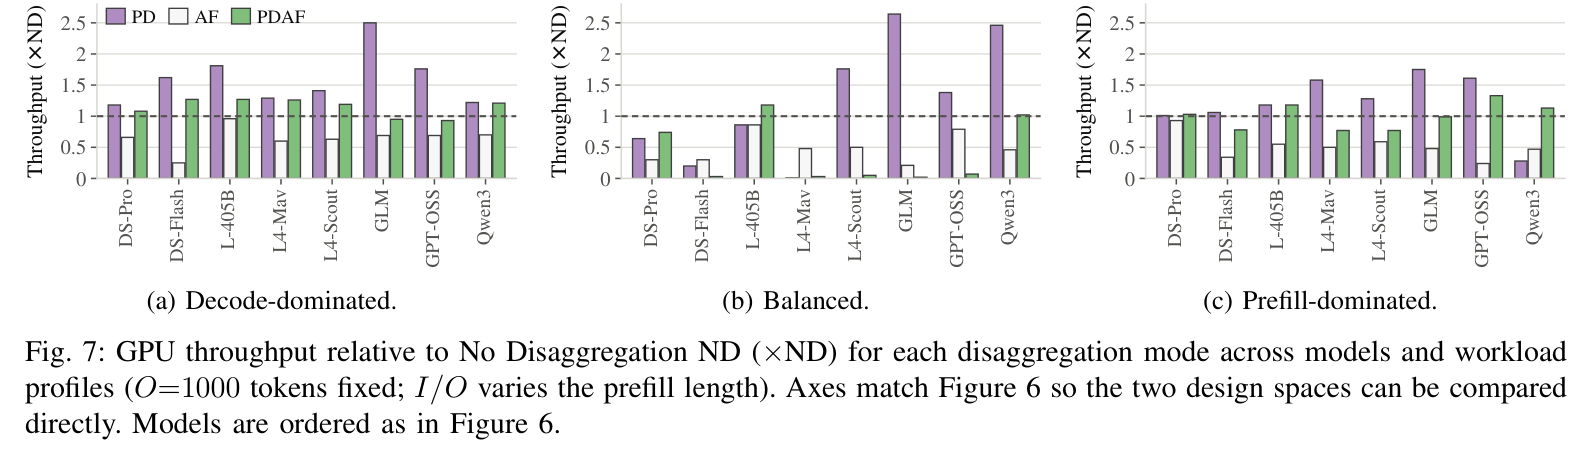
Paper's Figure 7, verbatim (caption: "GPU throughput relative to No Disaggregation ND ($\times$ND) for each disaggregation mode across models and workload profiles ($O{=}1000$ tokens fixed; $I/O$ varies the prefill length). Axes match Figure 6 so the two design spaces can be compared directly. Models are ordered as in Figure 6." Panels: (a) Decode-dominated. (b) Balanced. (c) Prefill-dominated.).
坐标轴与 Fig. 6 完全对齐,所以两张图可以直接叠看。两处反转:穿越点提前了 —— 在 $I/O=0.01$ 时 PD 就已八个模型全部超过 ND($1.18$–$2.50\times$)并全部胜出,而同一比值下 NPU 空间里 ND 领先一切;在 $I/O=100$ 时 PD 在 6/8 模型上追平或胜过 PDAF,与 NPU 排名相反。同时 GPU 结果远不均匀:PD 在 $I/O=1$ 只有 4/8 越线,跨模型跨度从 $0.01\times$ 到 $2.64\times$。
| 模式 | $I/O=0.01$ | $I/O=1$ | $I/O=100$ |
|---|---|---|---|
| PD | 8/8(1.18 – 2.50$\times$) | 4/8(0.01 – 2.64$\times$) | 7/8 |
| PDAF | 6/8 | 2/8 | 4/8 |
| AF | 0/8(最好 0.96$\times$) | 0/8 | 0/8 |
5.5 逐阶段硬件分配:反转的机制 #
Table V($I/O=100$,$I=100$k,$O=1$k)给出搜索为每个阶段选中的器件,这是解释上述反转的关键证据:
| 阶段 | NPU 搜索选中的存储档 | NPU 搜索选中的算力档 |
|---|---|---|
| PA | 最小容量(如 HBM 16/1.0k、LPDDR 32/200) | 20k TFLOPS(最高) |
| PF | 最小容量(少数例外) | 20k TFLOPS(最高) |
| DA | HBM 190/8.0k(容量与带宽最高档) | 25 – 250 TFLOPS(最低) |
| DF | HBM 190/8.0k(同上) | 2.5k TFLOPS |
DA 与 DF 拿到相同的存储档却相差 10–100 倍的算力档 —— 这是 §III 论证(PD 把两个理想计算/带宽比不同的子阶段按在同一器件上)的直接实证确认。
反观 GPU:32 个 PDAF 阶段分配中 31 个是 H100-80/3.4k @ 989 TFLOPS,唯一例外是 GPT-OSS 的 PF 阶段(A100-40/1.6k @ 312 TFLOPS)。GPU 把算力与带宽绑死,搜索无从再平衡,每个阶段拿到几乎相同的计算/带宽比,无论它是 attention 受限还是 FFN 受限。这就是四路拆分在 GPU 上不划算的原因:拆开 attention 与 FFN 只有在能给它们真正不同的硬件时才有意义,而这正是 NPU 空间允许、商用目录不允许的。
5.6 架构消融:PDAF 收益由什么驱动 #
三个 MoE 基线(跨低/中/高 decode-attention 算术强度)× 五个因子 × 四个取值,全部在 $I/O=100$、同一硬件搜索与功耗预算下评估。四个发现:
5.7 量化敏感性(Qwen3.5-32B,Table VII) #
配置串按 $(q_{\mathrm{PA}},q_{\mathrm{PF}},q_{\mathrm{DA}},q_{\mathrm{DF}})$ 读:
| 配置 | 降位宽的阶段 | BFCL | GSM8k (20%) |
|---|---|---|---|
| Baseline | — | 18% | 78% |
| 8/8/8/8 | — | 21% | 75% |
| 4/4/4/4 | 全部 | 6% | 11% |
| 4/8/8/8 | PA | 12% | 80% |
| 8/4/8/8 | PF | 20% | 47% |
| 8/8/4/8 | DA | 11% | 79% |
| 8/8/8/4 | DF | 20% | 15% |
两个阶段类之间存在明显不对称:降 FFN 阶段(PF / DF)重创 GSM8K 而 BFCL 不动;降 attention 阶段(PA / DA)腰斩 BFCL 而 GSM8K 反而高于 8-bit 基线甚至高于未量化基线。BFCL 平均 11,174 prefill / 1,472 decode token,GSM8K 为 995 / 313 —— 约 11 倍上下文差。结论是哪个阶段容忍低精度是工作负载的属性而非模型的属性,单一全局精度必然牺牲其中之一。
两点需要保留的怀疑:8-bit 均匀量化在 BFCL 上(21%)高于未量化基线(18%),而 4/8/8/8(80%)与 8/8/4/8(79%)在 GSM8K 上高于未量化的 78% —— 论文对此未置一词;且 §VII 自陈量化研究只有一个模型、两个任务、无重复实验,故所有 BFCL 差值的量级都在这些摆动的噪声范围内。此外该模型不在八模型吞吐集合、也不在三模型消融集合中,精度轴与吞吐轴没有共同模型。
6. 论证链 #
| # | 步骤 | 依据(论文内部) | 推出 |
|---|---|---|---|
| 1 | Agentic 循环每轮把工具调用与观测重新累积进 prompt,上下文长度远超 chatbot | §I:OSWorld 平均 38K、峰值 100K token;Fig. 1(a) | 服务系统承受的内存与计算压力量级性上升 |
| 2 | Prefill 计算受限、decode 带宽受限,二者放在同一器件上互相干扰 | §II-A;DistServe / Splitwise 的既有结论 | PD 解耦成立,Fig. 1(b) 显示 agentic 上 $1.82\times$ 对 chatbot 上 $1.29\times$ |
| 3 | 但 attention 与 FFN 在每一相内部的资源画像分歧同样尖锐:decode 侧 DA 由 KV 带宽主导、DF 由权重流与专家稀疏度主导 | §III;批大小对二者作用方向相反(attention 增流量无复用,FFN 增复用) | PD 之下仍有残余相内错配,且随上下文增长而变宽 |
| 4 | 四个子阶段 × 硬件 × 并行 × 副本数在共享预算下组合爆炸,真实集群上无法穷举 | §III | 需要解析支撑的快速模拟器;HeteroPanacea 以 Eq. (1) 为唯一时延原语,Eq. (2)(3) 为剪枝与排序,Eq. (4) 为决策 |
| 5 | 在 NPU 空间扫描:$I/O\le1$ 时八模型全部 ND 最优;$I/O=100$ 时 PDAF 八模型全部越线、6/8 最优 | §VI-B,Fig. 6;Fig. 5 定位穿越点在 $I/O=1\to10$ 一个十倍程内 | 解耦收益是条件性的,条件是负载 prefill-heavy |
| 6 | 在商用 GPU 目录上重跑同一扫描:$I/O=100$ 时 PD 在 6/8 模型上 ≥ PDAF,排名相对 NPU 反转 | §VI-C,Fig. 7 | 同一模拟器、同一负载给出相反的架构结论,故结论是器件目录的属性 |
| 7 | 检查逐阶段分配:NPU 下 DA 与 DF 同取最高存储档但算力档相差 10–100 倍;GPU 下 32 个分配中 31 个是 H100 | §VI-D,Table V | 反转的机制是 GPU 把算力与带宽绑死,AF 拆分无物可分 |
| 8 | 变换模型架构而非硬件:kv_lora_rank 上升使收益单调上升(DA 从权重读主导转为 KV 主导);num_active_experts 上升使收益崩塌;降精度分裂三个模型 | §VI-E Findings 1/3/4,Table VI | 统一解释:PDAF 收益正比于 DA 与 DF 的 roofline 位置差距,三类外生变量各自独立地开合这个差距 |
| 9 | 逐阶段降精度的可容忍性在 BFCL 与 GSM8K 上完全相反 | §VI-F,Table VII | 精度选择也必须逐阶段且随工作负载定,单一全局精度必牺牲其一 |
7. 实现 cross-reference #
[实现未公开] —— 论文承诺"will open-source the framework in full – simulator, configurations, and evaluation scripts – upon acceptance"(§I),截至 L1 摄入时尚无可引用的代码仓库、文件或行号。以下为从论文文本可确定的实现约束,供复现时对照。
7.1 复现所需的外部依赖 #
| 组件 | 论文指定 | 可替代性 |
|---|---|---|
| 量化 pass | MASE [28],按匹配的 layer pattern 施加不同 config | 任何支持按层类型分派 config 的框架 |
| 数值格式 | MXint(微缩放整数,一个 block 共享指数),逐 tensor role(权重/激活/KV)与 attention 内逐子操作($QK^{\top}$、$AV$)独立设置 | Microscaling 规范 [20] |
| NPU 基底 | PLENA [24],因其可参数化而非因其是最优点设计 | 任何暴露 $(F,C,B)$ 的参数化 NPU 模型 |
| 存储功耗模型 | 改编自 MemExplorer [23]:片上用片上功耗估计器,片外用 per-bit 读写能量 × 带宽 + 空闲功耗密度 × 容量 | — |
| 验证平台 | 8×B200、Xeon 6960P、CUDA 12.8、PyTorch 2.10.0+cu128、NCCL 2.27.5、Python 3.12.13;BF16 走 torch.matmul,FP8 E4M3 走 torch._scaled_mm | — |
7.2 关键实现细节(两处易被忽略) #
其一 —— PhaseAutoSwitch 的序列长度判别。要把 $\mathbf{q}$ 落地,必须沿两个轴区分量化:按层类型(attention vs FFN)和按推理相(prefill vs decode)。前者 MASE 原生支持,后者不支持 —— MASE 没有 prefill/decode 的概念。论文的做法是给每个被量化的层挂一个 PhaseAutoSwitch hook,检查流经该层的张量的序列长度 $L$:$L>1\Rightarrow$ 用 prefill config,$L=1\Rightarrow$ 用 decode config,运行时切换到对应的逐相位宽。这个判别器极其朴素,但它有一个直接后果:任何 $L>1$ 的 decode 路径(推测解码、chunked prefill 与 decode 混批、多 token 预测)都会被误判为 prefill 相并套用 prefill 精度。复现时若要接入现代调度器,这个 hook 是第一个会失效的地方。
其二 —— 功耗预算的贪心再分配。Phase 2 的分配启发式是:为每个切片选取达到 $\sigma\ge1$ 的最便宜候选,然后把未花完的预算重新分配给最弱的阶段。这两步顺序不可交换,且它决定了 Table V 里 DA 为什么能同时拿到最高存储档和最低算力档 —— 最便宜的达标候选在带宽受限的 DA 上自然落在算力最低档,省下的功耗再被推给别处。若把启发式改成按 $\sigma$ 均衡分配,逐阶段特化的签名会显著弱化,从而改变全部 $\times$ND 数字。论文既未给出该启发式与全局最优的差距,也未给出 top-$K$ 中 $K$ 的取值。
7.3 核心技术壁垒的实现落点 #
Q2 中指出的壁垒 —— 把"何时该拆"还原为 DA 与 DF 两个 roofline 位置之间的间隙宽度 —— 在实现上落在一个看似不起眼的地方:decode-attention 的每步字节数必须被拆成随上下文长度线性增长的 KV 项与与 batch 无关的权重项两部分,且二者的比值必须能被单独查询。只有当字节数模型保持这个分解结构,kv_lora_rank 的扫描才能揭示 Finding 1 的机制(rank=128 时权重项主导,DA 与 DF 结构上不可区分);如果实现里把 decode-attention 的字节数聚合成一个标量,整篇论文最强的解释性结论就消失了,只剩下一堆无法归因的 $\times$ND 柱状图。同理,$\mathrm{ex}\cdot k$ 计算代理要求 ffn_expansion 与 num_active_experts 在 FFN roofline 里以乘积形式进入活跃项、却在容量项里以不同方式进入 —— 正是这个结构差异让 Finding 3 的量级证伪(同一乘积、相差一个数量级的效应)成为可检测的现象而非数值噪声。复现者若只对齐吞吐数字而不对齐这两处分解结构,能得到相同的图,却得不到相同的知识。