Global Simulation-Guided Dynamic Operator Scheduling for Efficient Multi-Tenant Model Serving
SliceScheduler:全局仿真引导的算子级动态调度 #
1. TL;DR #
容器调度无法回收服务内部秒级空闲片段。SliceScheduler 把调度单元下沉到"算子"(实测粒度=融合 8 层的 LLM layer),用带 shape 的全局映射图 GMG 重建集群一致快照,再以事件驱动仿真器做 what-if 打分选放置:token 吞吐 1.10–2.29×,SLO 达成 98.9%,运行时开销 0.0%。
2. Q1 / Q2 / Q3 #
Q1 — 痛点:空闲片段的"所有权"与"控制粒度"双重错配 #
作者从一家工业公司的 AI coding 服务取两周 trace,选四个代表日回放。单张 A16 上跑 Llama3-8B 实例,平均 GPU 利用率 64.0%,其余时间被切成大量短片段:p50 2551.11 ms、p90 10887.64 ms、p99 17790.31 ms,且短于 p99 的片段占总空闲时间的 95.6%。
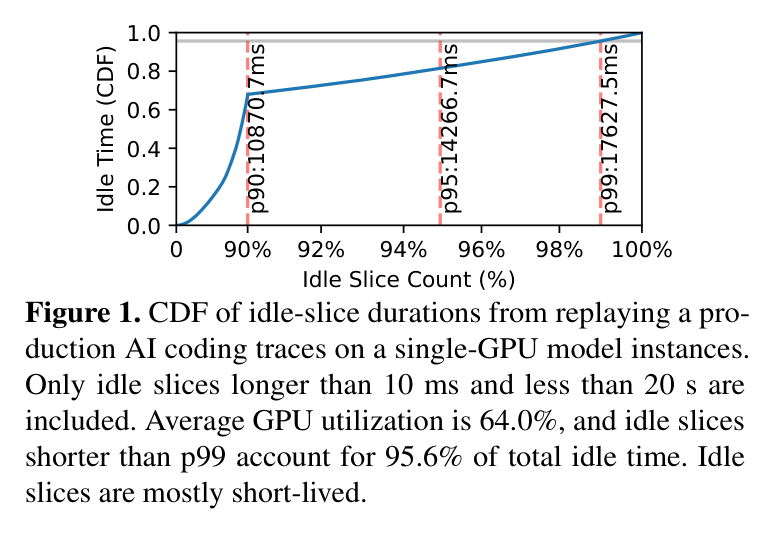
论文 Figure 1,原始 caption:"CDF of idle-slice durations from replaying a production AI coding traces on a single-GPU model instances. Only idle slices longer than 10 ms and less than 20 s are included. Average GPU utilization is 64.0%, and idle slices shorter than p99 account for 95.6% of total idle time."
这张图是全文的立论基础,读者要看的是曲线的陡度:横轴只画 90%–100% 的空闲片段计数区间,纵轴 CDF 已经从 0 爬到 1,意味着绝大多数空闲时间由数量占比极小、但每段都只有秒级的片段构成。这个形状直接排掉了"扩缩容能解决"的可能——秒级窗口装不下分钟级的重调度。
论文把失败原因拆成两条正交的轴:
- 控制粒度太粗(§2.2.1)。容器编排本来是为部署设计的,调度器选完节点后由应用进程驱动 GPU,调度器不再直接控制计算单元和显存。弹性机制要走 checkpoint → 重排队 → gang scheduling 等待 → 拉镜像 → 环境初始化 → checkpoint 加载,端到端"on the order of minutes"。用分钟级机制去填秒级洞是无效的。
- 资源所有权独占(§2.2.2)。空闲片段在账面上仍属于原容器,而用户应用不可修改,无法指望它主动让出。静态空间切分(MIG 类)只能拿到固定份额,抓不到执行期间动态产生的瞬时片段;不做静态切分的共享(MPS / AntMan 类)在 LLM 场景下更难,因为权重和运行时状态常驻显存,峰值期直接变成内存压力和干扰。
- GMG(Global Mapping Graph):Shape DAG + Accelerator Set。每个节点是一个带 tensor shape 与执行状态(
unscheduled/issued/done)的算子,边是数据依赖,节点映射到加速器集合。计算模式是 register-once / instantiate-many:应用先注册带符号 shape 的图模板,之后反复实例化,SliceScheduler 从输入 shape 推断实例中每个算子的 shape。四类调度元数据挂在 GMG 上:每算子的性能 estimator、全局与逐节点时间戳、输出 tensor shape、以及标记哪些中间结果被持久保留的 checkpoint 元数据。 - 全局仿真器:两个线性 estimator(传输 = 仿射 size 模型,算子 = shape 特征基)+ 事件驱动推进。构造阶段从 GMG 快照反推每张卡的队列内容、当前执行算子、以及显存驻留集合;推进阶段每步取最早完成的算子作为事件、推进统一仿真时间线、级联启动同队列中就绪的后继。
- 调度模块:GMG 上维护 scheduled / unscheduled 两个 frontier 界定增量边界。每轮从 unscheduled frontier 取最高优先级算子,沿后继收集一个小的连通批次,对预定义候选 partition 并行做 what-if 仿真,丢弃 OOM 候选,选仿真平均完成时间最小者。
- 算子执行器:每卡一个依赖驱动(而非发射顺序驱动)队列,一次只跑一个算子;跨卡传输被分解为 Intent / Recv / Send 三个算子,由 master 在一张独立的通信图上做仲裁。
- 量纲一致性 — 通过(但需注意 $l$ 是无量纲的)。分母 $s g$ = (算子/ms)·(ms) = 算子,分子若 $l$ 无量纲则 $Nl+1$ 亦为算子计数,$t$ 无量纲,符合"比值"定义。这只在 $l$ 已被 scheduling volume 归一化的前提下成立——也就是说 $v$ 是被吸进 $l$ 的量纲因子。论文没有明说这一点,但这是唯一能让 Eq 3 量纲自洽的读法。
- 一阶数值复现 — 通过。$g = 42.3 / 4 = 10.575$(Llama3-8B 的 32 层每 8 层融合为一算子,故一次前向 4 个算子,平均 decode 延迟 42.3 ms)。代入 $s = 176.8$、$l = 3$、$t = 0.1$:$N = (t s g - 1)/l = (0.1 \times 176.8 \times 10.575 - 1)/3 = (186.96 - 1)/3 = 61.99$。论文报 $N \approx 62$ → "about 64 GPUs"。数字确实是算出来的,不是 sweep-then-fit。
- 单调性与边界 — 通过,且最优解在边界。$\partial t / \partial N > 0$、$\partial t / \partial l > 0$、$\partial t / \partial g < 0$、$\partial t / \partial s < 0$,全部严格单调,无内点极值。这意味着决策质量与及时性之间不存在解析最优点,只有一条约束线 $t \leq t_{\text{target}}$;实践中只能把 $l$ 和 $g$ 往"更粗"推到约束边界。这解释了 §5.1 为什么把层融合成调度单元而不用 ATen op——若用 ATen op,$g$ 会小 2–3 个数量级,$N$ 的上限随之崩到个位数。
- 各项能否被排除 — 一处未通过。声明的 $v$ 完全不进公式,而 §5.5 又说"我们离线调 $v$ 和 $l$"。若 $v$ 已被 $l$ 的归一化吸收(第 1 项的读法),那"同时调 $v$ 和 $l$"就是同一自由度调两次;若没有被吸收,公式缺项。论文两处表述不能同时为真。
- 模型与实测交叉验证 — 未通过(模型层面)。Eq 3 从未在变化的 $N$ 上被测量验证:全部实验在单机 8 张 A16 上完成,而 64-GPU 的适用性结论是纯纸面外推。作为 framework 论文的核心定位是"cluster-wide",却没有任何跨节点实验——集中式 master 的反馈延迟、状态陈旧、真实执行偏离仿真重建状态时的行为,全部未建模也未测量。
- 实验数字自洽性 — 通过。Fig 8 的柱标签能反推论文声明的区间:token 吞吐 $18.51/16.82 = 1.10\times$、$18.51/8.08 = 2.29\times$,匹配摘要的 "1.10–2.29×";request 吞吐 $1.23/1.12 = 1.10\times$、$1.23/0.54 = 2.28\times$,匹配 "9%–129%"。但有两处口径漂移需记录:(a) 摘要说 "maintaining SLA violations within 9%",§5.2 说 "improves SLO attainment by about 9%"——一个是违约率上界、一个是提升幅度,Fig 8(c) 支持后者(98.9% 即约 1.1% 违约);(b) §5.4.3 的 176.8 / 0.065 = 2720×,是约 3.4 个数量级,论文两处都写"about four orders of magnitude"。
- 层融合的数量级不是调参而是可行性前提。§5.1 把每 8 层 Llama3-8B 合成一个算子,得 $g = 10.575$ ms。若按原始 ATen op 调度(单次图执行数千到数万 op),$g$ 落到 μs 量级,Eq 3 的 $N$ 上限直接崩到个位数。融合比例是把系统从"不可行"推到"64 卡可行"的那个旋钮,但论文只说"empirically grouping",未给敏感性分析。
- 候选放置来自预定义 partition 集合,不是搜索出来的。§3.4.2 明确:每个图模板到每个候选 partition 的算子映射也是预定义的(依据是"推理图规则可分解")。所以决策空间远小于"算子级调度"字面暗示的规模。论文从未说明候选 partition 有多少个、如何选出、并行 what-if 成本如何随该数量增长——而这个计数直接乘在 Eq 3 假定的每轮仿真工作量上,是该模型未表达的第二个自由度(另一个是 §4 检查 4 指出的 $v$)。
- Recv-before-Send 的真正理由是重试语义。§3.5.2:目的端 buffer 分配可能临时失败并需重试,故先激活目的端 Recv、成功后才触发源端 Send,让发送方只在目的端就绪时才调用通信原语。这个顺序不是性能优化,而是把"分配失败"从不可恢复的阻塞态转成可重试态。
- checkpoint 元数据是增量调度的载体。GMG 每个节点记录哪些中间结果被持久保留在何处(如某卡 HBM),scheduled frontier 由此成为"驻留在加速器上供后续调度接续的检查点"。新图实例可挂接到保留的中间态上——这是多轮对话/前缀复用在该抽象下的表达方式,但论文未把它与前缀缓存的收益关联,也未测量其显存占用代价。
真正把问题钉死的是一个测量:把四个代表日 trace 回放在四个模型实例上,跨 GPU 的空闲时间重叠不超过 20%。这条数据的杀伤力在于它否定了"扩大共享作用域"这条退路——低优先级作业需要覆盖的 GPU 越多,这些 GPU 同时空闲的概率越低。于是低优作业若仍以 GPU-sharing 容器形态部署,就必须等多张卡同时可用才能推进端到端计算。要吃掉散落的碎片,低优作业本身必须可被细粒度分解并跨容器边界铺开。
一个 1 GPU 上的可行性探针(Fig 3,两个 Llama3-8B 实例,一个高优在线、一个低优离线)显示:机会式填洞在 SLA 不破的前提下把 token 吞吐提到 $1.25\times$。所以机会存在,缺的是抓取它的抽象。
Q2 — 方法:把"集群状态"做成可克隆、可仿真的对象 #
系统范围先说清楚:这是推理服务(serving)+ 训练图仿真验证混合的调度层,覆盖 prefill 与 decode 两个阶段但不改动批处理逻辑本身——它不是 continuous batching 的替代品,而是坐在其下方接管算子到加速器的映射。并行维度上它只拥有"图切分 + 算子放置"这一轴(候选划分是预定义的加速器 partition 集合,等效于 PP / 层间切分),TP / EP / DP 全部交给被调度的图自己表达。部署形态是单机多卡集中式 master:实测 8×A16 在一台服务器内,跨节点从未验证。
四层闭环:
核心技术壁垒:不是任何单个组件,而是 "GMG 快照 ≡ 集群一致快照"这条可重建性不变量,以及维持它的三个耦合约束。仿真器之所以能只从 GMG 就推出"哪个算子正在跑、显存里有哪些 tensor",靠的是三件事必须同时成立:(i) 每队列一次只执行一个算子(§3.5.1 的硬不变量);(ii) 就绪定义为"所有前驱 done 且其输出已在本地 HBM",从而当前执行算子唯一确定为 ready time 最早的 issued 算子;(iii) shape 在执行前可推断,于是显存占用可在放置前算出。任何放松——异步多流、动态 shape、投机执行、乱序队列——都会同时打破状态可重建性和显存安全性判定。复制这个系统的难点在于同时守住这三条,而不是写出仿真循环。
Q3 — 结果 #
| 指标 | Static-Online | Full-Share | Subset-Share | Dual-Share | SliceScheduler |
|---|---|---|---|---|---|
| Request throughput (req/s) | 0.54 | 0.82 | 0.89 | 1.12 | 1.23 |
| Token throughput (tok/s) | 8.08 | 12.35 | 13.44 | 16.82 | 18.51 |
| SLO attainment | 90.0% | 90.7% | 89.9% | 90.4% | 98.9% |
| GPU utilization | 40.7% | 41.9% | 44.1% | 48.2% | 56.5% |
除端到端收益外,三个支撑性结果:调度层运行时开销 0.0%(23.37 s vs Direct Execution 23.39 s,1000 次 prefill);两个 estimator 的 MAPE 分别 0.32% / 0.92%;仿真器端到端误差 1.83%(SimAI 20.58%),吞吐 176.8 算子/ms(SimAI 0.065)。
3. 架构 / 方法图 #
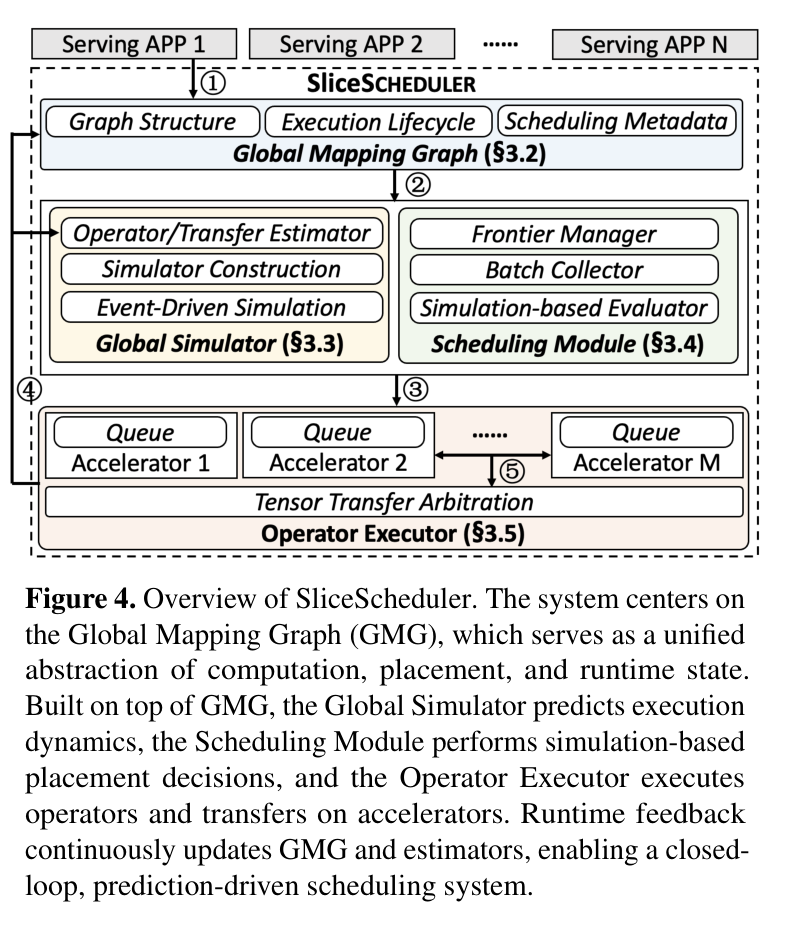
论文 Figure 4,原始 caption 节选:"The system centers on the Global Mapping Graph (GMG) ... Runtime feedback continuously updates GMG and estimators, enabling a closed-loop, prediction-driven scheduling system."
图中要注意的是箭头的方向构成一个闭环而非流水线:GMG 在中心,仿真器、调度模块、执行器围绕它,编号边 (1) 注册与实例化 → (2) 调度与仿真 → (3) 发射 → (4) 传输仲裁 → (5) 反馈回到 GMG 与 estimator。反馈边是关键——estimator 在线细化正是论文归因自己比 SimAI 精确一个量级的原因(§5.4.2)。
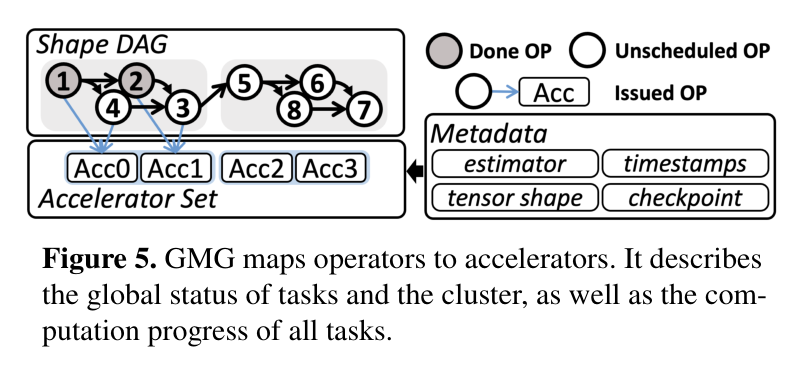
论文 Figure 5,原始 caption:"GMG maps operators to accelerators. It describes the global status of tasks and the cluster, as well as the computation progress of all tasks."
左侧 Shape DAG 与右侧 Accelerator Set 之间的映射边就是调度决策的物化形式。读者应注意 GMG 同时承载了三类信息——计算结构、放置、执行进度——正是这个"三合一"让克隆 GMG 就等于克隆整个集群的可仿真状态。
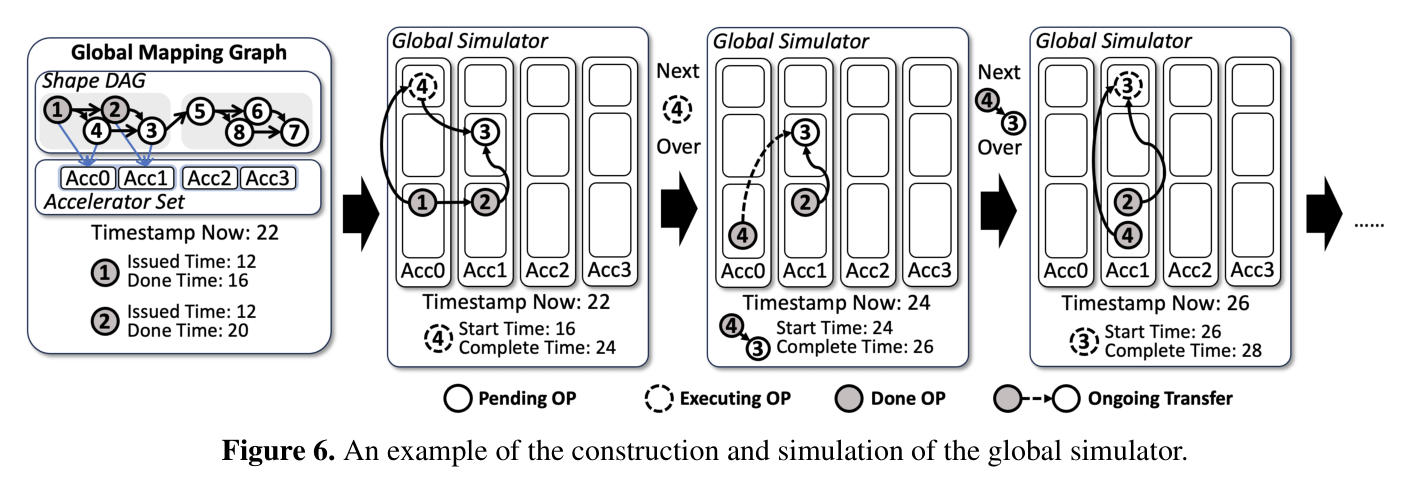
论文 Figure 6,原始 caption:"An example of the construction and simulation of the global simulator."
这张图把仿真拆成必须分开理解的两步:左半是构造——从 GMG 快照反推每张卡的算子与依赖,为每卡建一个仿真队列;右半是推进——沿统一仿真时间线逐事件前进。构造步才是难点所在(它依赖 §4 讨论的可重建性不变量),推进步只是标准的最早完成事件循环。
下面的时序图把请求生命周期与两个 first-class 组件(调度器、显存视图)显式分开,这是 Figure 4 的框图无法表达的结构:
排队纪律值得单列:批次收集是优先级驱动的(highest-priority first),但放置选择是仿真分数驱动的(min predicted average completion time)。这两级的组合产生了论文声称的三个"涌现"性质——局部性、SLA 优先、负载均衡——下面 §6 会逐条检查这个因果链。
显存管理器在论文中不是独立组件,而是仿真器的一个推断能力:分配单位是算子的输出 tensor(不是 page,不是 block),生命周期由"就绪 + 执行中"算子集合隐式决定,回收发生在算子标记 done 时释放资源账目。没有 eviction 策略,没有 swap to CPU/disk,没有碎片整理——准入控制完全前置为"仿真出 OOM 的候选放置直接丢弃"。这是一个纯 admission-time 的显存安全模型,代价是无法处理运行期意外增长。
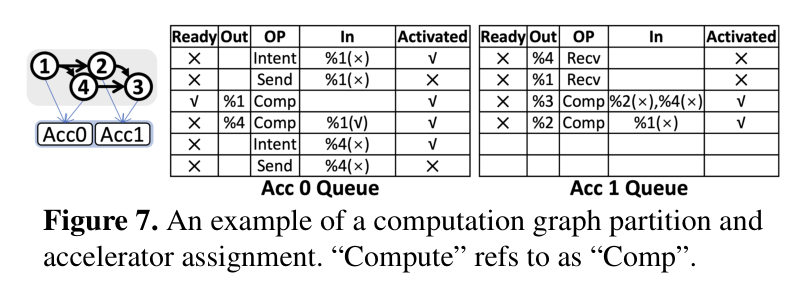
论文 Figure 7,原始 caption:"An example of a computation graph partition and accelerator assignment. 'Compute' refs to as 'Comp'."
图中每张卡的队列里混排着 Comp 节点与跨卡传输节点——这是"把传输当作普通算子入队、再由仲裁门控其执行"这一设计选择的直接可视化,也是为什么传输延迟能自然进入仿真时间线(见 §6 第 3 步)。
4. 作者证明 #
论文有三个形式化对象:两个 estimator(Eq 1 / Eq 2)和一个可扩展性模型(Eq 3)。没有关于 GMG 一致性或仲裁无死锁的形式化证明——这两条都是断言。
记号表 #
| 符号 | 含义 | 出处 / 取值 |
|---|---|---|
| $size$ | 待传输 tensor 大小(bytes) | Eq 1 |
| $\alpha$ | 传输斜率,有效带宽的倒数(时间/字节) | Eq 1,按加速器对分别拟合 |
| $c$ | 单次传输固定开销(截距) | Eq 1 |
| $b, m, n, k$ | batched matmul 的 batch 与三个矩阵维度 | Eq 2 |
| $\beta_{1..4}$ | 特征系数(对应 $bmnk$、$bmk$、$bkn$、$bmn$) | Eq 2 |
| $\beta_5$ | shape 无关常量开销(kernel launch 等) | Eq 2 |
| $N$ | 集群加速器数量 | Eq 3 |
| $s$ | 仿真吞吐(算子/ms) | Eq 3;实测 176.8 |
| $g$ | 算子粒度:单个调度单元的平均执行时间(ms) | Eq 3;实测 10.575 |
| $l$ | 预测视界,按 scheduling volume 归一化的未来窗口 | Eq 3;取 3 |
| $v$ | scheduling volume:一轮所选算子的总执行时间 | §5.5 声明但未出现在 Eq 3 |
| $t$ | 调度及时性:调度期间集群执行的算子数 / 本轮调度的算子数 | Eq 3;目标 0.1,$t \geq 1$ 表示调度器成为瓶颈 |
方程与物理意义 #
Eq 1(传输延迟):$t = \alpha \cdot size + c$
标准的 latency–bandwidth 仿射模型。关键设计是按加速器对而非全局拟合,因为有效带宽取决于链路(NVLink vs PCIe 跳数);截距 $c$ 让小 tensor 传输不免费,而这正是调度器局部性惩罚的来源——破坏局部性的放置会把这些传输项加进仿真时间线,抬高下游算子的预测完成时间。
Eq 2(算子执行时间,以 batched matmul 为例):$t = \beta_{1}(bmnk) + \beta_{2}(bmk) + \beta_{3}(bkn) + \beta_{4}(bmn) + \beta_{5}$
这是手工设计的特征基而非黑盒回归:一个 FLOP 项($bmnk$)+ 三个数据搬运项(两个输入 tensor 大小 $bmk$、$bkn$,输出 tensor 大小 $bmn$)+ 一个截距。为什么用这个形式而不是纯 roofline?因为 roofline 需要知道算子是 compute-bound 还是 memory-bound;这里的线性组合让拟合过程自己决定哪一项主导,同时保持"线性于特征"从而可在线廉价重拟合、并以仿真速度求值。它按 (加速器类型, 模板算子) 对维护,而非按算子种类——这是为了吸收同一算子在不同层位置上的实现差异。
Eq 3(调度及时性):$t = \dfrac{N l + 1}{s g}$
分子 $Nl + 1$ 计一轮的仿真工作量:视界 $l$ 要在全部 $N$ 张卡上推进,加上批次本身($+1$)。分母 $sg$ 是集群自身执行"买来"的仿真预算:每算子 $g$ ms 真实执行时间,乘以 $s$ 算子/ms 的仿真速度。
六项最小检查 #
未被证明的两条:GMG 与集群一致快照的等价性(§3.3.2 仅给出重建论证,无证明、无测量);传输仲裁的无死锁性(§3.5.2 声称避免死锁,但冲突无关边集的选择算法未给出——文字暗示一个匹配问题——既无形式论证也无压力实验)。
5. 实验与数据 #
平台:单台服务器,2×Intel Xeon Platinum 8468(96 核)、1600 GB 主存、8×NVIDIA A16(各 64 GB)。在线负载是 §2.1 四条一日 trace 的 19:00–19:30 片段;离线负载每秒一请求、输入 2048 token、固定输出 15 token。调度单元 = 融合后的 LLM layer。
基线全部由作者自行实现(理由是 GPU 共享系统"并非总是公开可得"):Static-Online(容器级 pinning,四实例分别钉在 GPU 对 (0,1)/(2,3)/(4,5)/(6,7))、Subset-Share(对 AntMan 的优先级感知共享建模,离线实例限定 4 卡子集)、Dual-Share(对 Orion 的干扰感知共享建模,两个离线实例分居两个 4 卡子集)、Full-Share(单个离线实例跨全部 8 卡)。
5.1 端到端协同放置 #
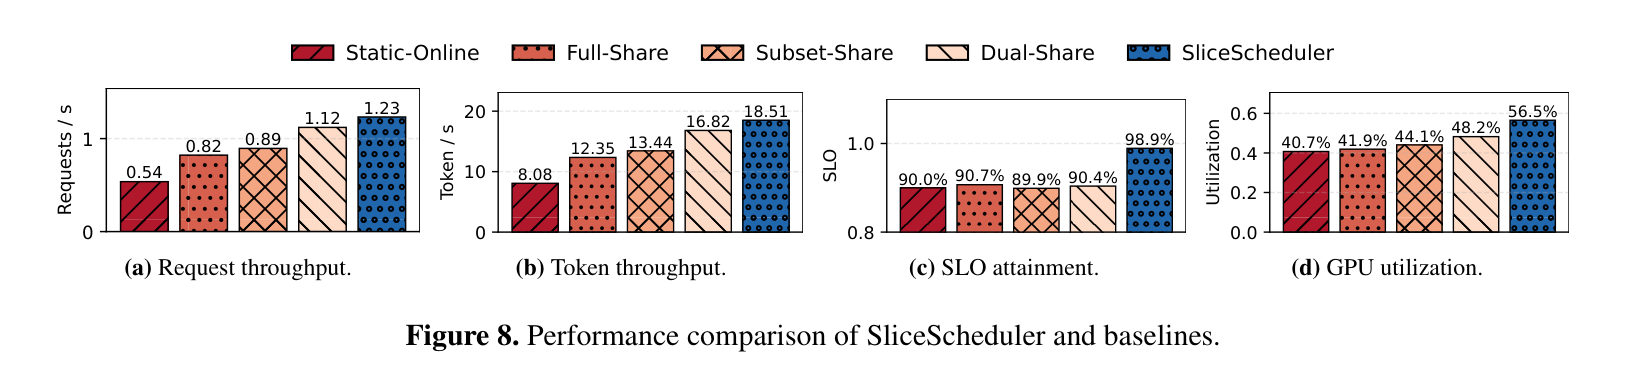
论文 Figure 8,原始 caption:"Performance comparison of SliceScheduler and baselines."
四个子图的排序模式高度一致:Static-Online < Full-Share < Subset-Share < Dual-Share < SliceScheduler,说明"共享作用域越灵活收益越高"这条趋势在吞吐和利用率上成立。但真正的分水岭在 (c):三个共享基线的 SLO 达成全部落在 89.9%–90.7% 的 0.8 个百分点带内,SliceScheduler 跳到 98.9%。读者应注意 SLO 阈值被定义为 Static-Online 的 p90 TTFT,所以 Static-Online 的 90.0% 是定义上近乎固定的;三个共享基线在多背了 1–2 个离线实例的情况下仍精确聚在同一值,是一个偏紧的巧合。
绝对量级也需要放在心上:整台 8 卡服务器只有 8.08–18.51 output tok/s、0.54–1.23 req/s。A16 是面向推理/VDI 的 GDDR6 卡,不是数据中心 LLM 服务 GPU,而论文的论述框架(HBM 占用、OOM、权重常驻 HBM)是 HBM 中心的。
论文对增益的归因:相对 Full-Share 的 +49% request 吞吐来自"自动负载均衡延长了多卡空闲片段的重叠时长";相对 Subset-Share / Dual-Share 的 +9%–37% 来自"固定 GPU 作用域 vs 集群级动态调度可用资源池更大"。前一条归因没有隔离实验支撑——全文没有任何 ablation(例如去掉负载均衡打分、或 GMG 不配仿真器)。
5.2 Estimator 精度 #
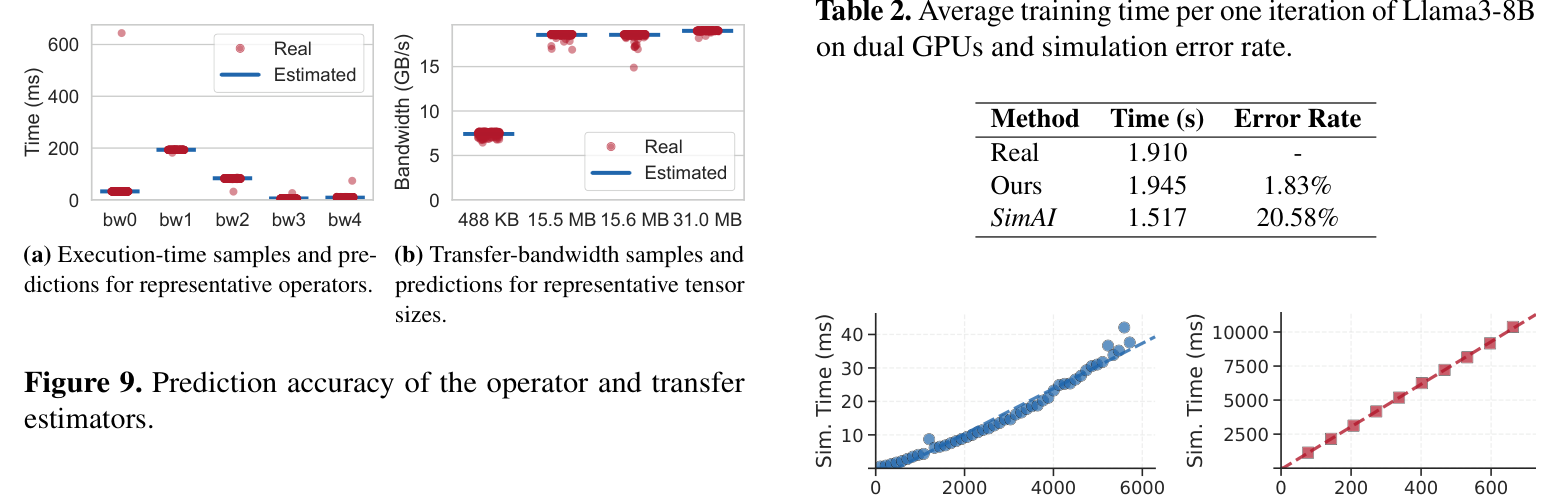
论文 Figure 9,原始 caption:"Prediction accuracy of the operator and transfer estimators."
(a) 是五个反向算子(bw0–bw4)的实测 vs 预测执行时间(0–600 ms 量级),(b) 是四个代表 tensor 尺寸(488 KB / 15.5 MB / 15.6 MB / 31.0 MB)的实测 vs 预测带宽。要看的不是"两根柱子一样高",而是样本本身的稳定性:算子样本变异系数 0.62%、传输样本 1.63%。是负载的确定性、而非回归模型的精巧,支撑了整个仿真器——在这种 CoV 下线性拟合几乎不可能失败。
| Estimator | 样本变异系数 | MAPE |
|---|---|---|
| 算子执行时间 | 0.62% | 0.32% |
| Tensor 传输 | 1.63% | 0.92% |
5.3 仿真器端到端精度与速度 #
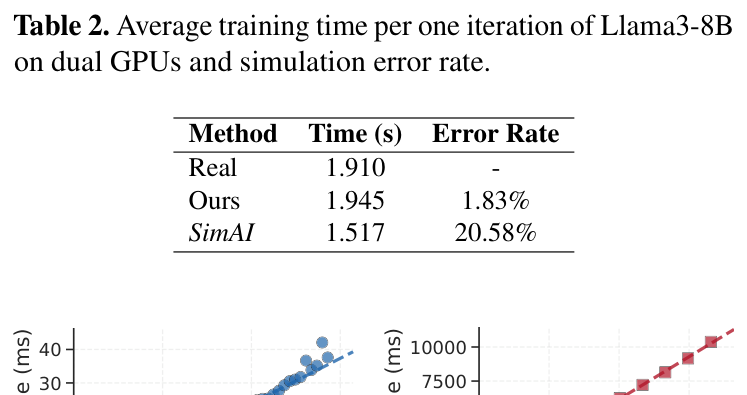
论文 Table 2,原始 caption:"Average training time per one iteration of Llama3-8B on dual GPUs and simulation error rate." 实测 1.910 s;本文仿真器 1.945 s(误差 1.83%);SimAI 1.517 s(误差 20.58%)。
两点值得注意。其一,误差方向相反:本文仿真器高估(1.945 > 1.910),SimAI 低估(1.517 < 1.910)。对调度器而言高估是安全侧——预测的完成时间偏悲观只会让它更保守,不会导致把算子塞进实际装不下的洞里。其二,这个精度证据来自 Llama3-8B 训练图、PP=2、2 张卡(因为 SimAI 主要面向训练),与论文的目标场景(多租户模型服务、8 卡)是不同的负载类别与规模。
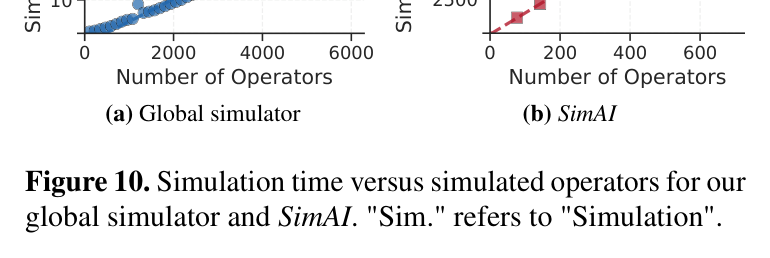
论文 Figure 10,原始 caption:"Simulation time versus simulated operators for our global simulator and SimAI. 'Sim.' refers to 'Simulation'."
(a) 本文仿真器:0–6000 算子对应 ~10–40 ms,均值 176.8 算子/ms。(b) SimAI:0–600 算子对应 ~2500–10000 ms,均值 0.065 算子/ms。读者必须注意两个子图的横轴量程差 10 倍,且 SimAI 的算子数是间接换算的("simulate models of different sizes to obtain the equivalent number of simulated operators")。论文自己也承认速度差"stems from the different goals of the two simulators"——本文仿真器弱化了流量调度,即它仿真的东西更少。这不是同一件事做得更快,而是做了更少的事。
5.4 快路径开销 #
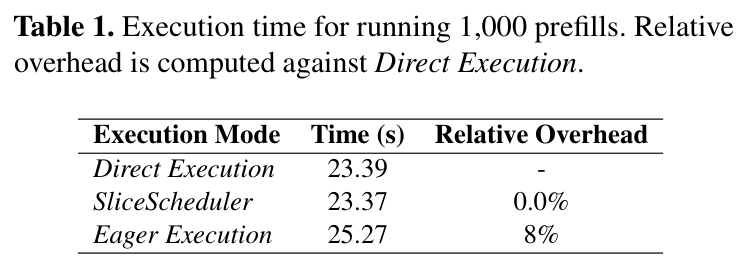
论文 Table 1,原始 caption:"Execution time for running 1,000 prefills. Relative overhead is computed against Direct Execution." Direct Execution 23.39 s;SliceScheduler 23.37 s(0.0%);Eager Execution 25.27 s(8%)。
方法上把 context length 设为 1 跑 1000 次 prefill,就是为了压缩真实计算时间以放大系统开销。结果是 SliceScheduler 比 Direct Execution 名义上快 0.02 s。加一层调度中介却测不出成本(甚至略负)比设计本身能预测的更强,论文未给解释也未给误差棒。相对 Eager 快 8% 归因于绕过 Python 解释器开销,引的是一篇博客而非 profile。
5.5 胜负分区 #
论文没有给出负载分区表,只报了平均意义上的胜。按其机制与实测配置反推:
| 负载区间 | SliceScheduler | 固定作用域共享基线 | 原因 |
|---|---|---|---|
| 在线负载轻、空闲片段多且跨卡不重叠 | 强胜(论文实测区间:util 56.5% vs 41.9%–48.2%) | 弱 | 低优图可被分解并铺到任意空闲卡,不需要多卡同时空闲;跨卡空闲重叠 ≤20% 正是基线的死穴 |
| 在线负载饱和、几乎无空闲片段 | 收益趋零,退化为 Static-Online + 调度开销 | 同样趋零 | 没有片段可回收;优先级驱动的批次收集会让低优算子根本不被收集 |
| 显存吃紧(在线占满 HBM,残余碎片极小) | 保安全但收益低 | 易 OOM 或抖动 | 准入期丢弃 OOM 候选是硬门;但可放置的候选也随之稀少 |
| 集群规模超过约 64 卡 | 失效 | 不受影响 | Eq 3 中 $t$ 随 $N$ 线性恶化,集中式 master 的 what-if 仿真成为瓶颈 |
| 细粒度算子(ATen op 级) | 失效 | 不适用 | $g$ 缩小 2–3 个数量级,$N$ 上限崩塌;故实测强制层融合 |
| 动态/不可预测 shape | 机制前提破裂 | 不受影响 | shape 前置可推断是显存安全与延迟预测的共同前提 |
指标口径需要固定下来读:throughput 中的 token 吞吐是输出 token/s(不含输入);latency 侧只报 TTFT(含排队与 prefill),不报 ITL 或 p99;SLO attainment 是"TTFT 低于 Static-Online p90 TTFT 的在线请求占比"这一相对定义,因此不能跨论文比较。GPU utilization 定义为时间窗内被算子执行片段占据的比例,是时间占用率而非 SM 占用率——这个定义下 56.5% 与 SM 级利用率不可互换。
6. 论证链 #
| # | 步骤 | 依据 | 传给下一步的东西 |
|---|---|---|---|
| 1 | 生产 trace 中的空闲时间以秒级短片段为主(p50 2551 ms,sub-p99 占 95.6%),且服务是按 SLA 近饱和配置的,故这不是配额配错 | Fig 1、Fig 2(b);§2.2 框架段 | 存在一个只能用秒级机制回收的机会 |
| 2 | 容器级机制无法回收:弹性重分配端到端"分钟级",且片段账面上仍属原容器、用户应用不可改 | §2.2.1、§2.2.2 | 必须把控制单元下沉到容器以下 |
| 3 | 扩大共享作用域这条退路也被堵死:四实例回放显示跨 GPU 空闲重叠 ≤20%,覆盖的卡越多同时空闲概率越低 | §2.2.2 para 5 | 低优作业本身必须可细粒度分解并跨容器铺开 → 算子是自然单元 |
| 4 | 但算子级放置需要两样先验图调度器不提供的信息:算子的显存需求(否则触发 OOM)与集群执行的时间演化 | §1 Challenge 1 / Challenge 2 | 抽象必须同时携带 shape 与时间戳 |
| 5 | shape 可在执行前推断(register-once / instantiate-many + 符号 shape 推断),于是显存占用与执行时间都可前置计算 | §3.2 para 3;Eq 1 / Eq 2;实测 CoV 0.62%/1.63%、MAPE 0.32%/0.92% | GMG 节点带显式资源语义 |
| 6 | 加上"每队列一次一算子"不变量与就绪定义,从 GMG 快照可唯一重建每卡队列内容、当前执行算子与显存驻留集 | §3.3.2 paras 1–4;§3.5.1 para 3 | GMG 被断言等价于集群一致快照 → 可克隆、可仿真 |
| 7 | 克隆 GMG + 施加候选放置 + 事件驱动推进 = what-if 仿真;据此打分即可在部署前评估放置 | §3.3.3 para 5;端到端误差 1.83%(Table 2) | 一个可内联调用的调度 oracle |
| 8 | 因为传输被显式加进仿真时间线、批次收集按优先级、重载分区在仿真中变得不划算,局部性 / SLA 优先 / 负载均衡三者无需各自的显式目标项即涌现 | §3.4.2 para 5 | 单一目标(最小化仿真平均完成时间)+ OOM 硬过滤即够 |
| 9 | 实测:吞吐与利用率全面超四个基线,SLO 达成 98.9%,快路径开销 0.0% | Fig 8、Table 1 | 算子级调度在实践上可行 |
| 10 | 但可行性有解析边界:$t = (Nl+1)/(sg)$,代入实测 $s$、$g$ 与选定 $l=3$、$t=0.1$ 得 $N \approx 62$ | Eq 3、§5.5 para 5 | 定位为中小规模集群方案,并把 Eq 3 反过来用作 GMG 中 issued 算子数上限 $B$ 的设定依据 |
链条的承重点在第 6 步。第 5 步(shape 可预测)有强实测支撑,第 7 步之后全部依赖第 6 步的等价性成立,而第 6 步是全链中唯一既无证明也无测量的环节——论文只给了重建论证。第 8 步的三个涌现性质中,SLA 优先有 Fig 8(c) 的测量,负载均衡只有相对 Full-Share 的 +49% 这一处归因而无隔离实验,局部性完全是设计论证。
7. 实现 cross-reference #
[实现未公开] — 论文无 artifact availability 声明、无代码仓库链接、无 LoC 统计。§4 只有三段文字描述三层实现,可核对的锚点如下(均为上游 API 面,非本系统代码):
| 层 | 载体 | 上游依赖 |
|---|---|---|
| 应用接口 | PyTorch 自定义 backend;模块首次执行时用 TorchDynamo 捕获计算图,注册为图模板并实例化 | torch.compiler / TorchDynamo(torch._dynamo 的 backend 注册路径) |
| Master | 跑在 host CPU,实现集群级调度与传输协调;持有 GMG、estimator、通信图 | 无(自研,未公开) |
| 算子执行器 | 基于 LibTorch,在加速器侧执行算子与 tensor 传输 | PyTorch C++ API |
"最小改动即可接入现有 PyTorch 服务应用"这一可用性主张,其机制依据是 Dynamo 自定义 backend 的常规接入方式(一个 backend 注册 + 编译入口替换),但论文未给移植工作量数据,也未说明捕获失败/graph break 时的退化路径——而 LLM 服务代码中 KV cache 管理与采样循环恰是 Dynamo 最容易 break 的地方。
核心技术壁垒(展开) #
最难复制的不是 GMG 数据结构,也不是事件驱动仿真循环——两者都是标准工程。壁垒是让"GMG 快照可无损重建集群运行态"这条不变量在真实运行时里持续成立。它要求执行器放弃几乎所有现代 GPU 运行时的性能手段:每队列一次只跑一个算子(不能多流并发),依赖驱动而非发射顺序(不能乱序或投机),跨卡传输必须先 Recv 后 Send 且由中心仲裁门控(不能让队列自主发起 P2P,因为原语阻塞、不可抢占、send/recv 错序会形成循环等待),shape 必须执行前可推断(不能有动态 shape)。任何一条放松,仿真器就无法从快照唯一确定"当前在跑哪个算子、显存里有什么",随之崩塌的是显存安全判定(OOM 过滤是准入期的唯一防线)与完成时间预测(调度的唯一目标函数)。
有意思的是这套约束反而是它开销为 0.0% 的原因:因为它本来就不做重叠、不做投机,接管调度并未剥夺任何既有优化。代价在别处——它无法与依赖异步流水的高性能 serving 引擎共存。这也解释了为什么论文的基线是 AntMan / Orion 这类共享系统而非 vLLM / SGLang:它不与后者竞争同一层,也不能直接叠加在后者之上。
关键实现细节(易漏) #
硬件反向含义 #
这个框架是硬件贴近型的(显存物理占用建模、互连感知的传输仲裁、跨卡放置),其复杂度反过来指向两个硬件缺口。其一,显存安全只能靠准入期仿真预测,因为 HBM 没有"分配即失败可恢复"的廉价原语,也没有硬件级的 per-context 显存配额与超额通知——如果有,OOM 过滤就不必前置到调度器里,仲裁的 Recv 重试逻辑也可以简化。其二,"每队列一次一算子"这条为了状态可重建而付出的代价,本质上是因为 GPU 缺少可被外部观测的、确定性的队列执行状态导出接口;若运行时能暴露一个廉价的一致执行快照(当前 SM 上算子 ID + 显存驻留集),GMG 的整套重建论证就无需成立,多流并发也可以同时保留。
Sources: §1–§7 of the paper; Fig 1, 4, 5, 6, 7, 8, 9, 10; Table 1, 2; Eq 1–3; Algorithm 1.