PipeSwift: Revisiting Pipeline Parallelism for Large-Scale Completion-Oriented Agentic LLM Serving
PipeSwift — L2 深度蒸馏 #
1. TL;DR #
Agentic 批量推理的目标是任务完成时间 (JCT) 而非 token 级 SLO。作者证明 prefill 优先调度虽拿到最优 TTFT 和最高 decode 吞吐却不是最优 JCT —— JCT 由 prefill/decode 效率的平衡决定。据此重新启用被冷落的流水并行 (PP),配合 JCT 感知调度和 PP 内嵌 MTP,构建 PipeSwift,在 64×H800 上比 wide-EP 快最多 1.45×。
2. Q1 / Q2 / Q3 #
Q1 — 痛点 (为什么现有系统不对) #
现有并置 (colocated) 推理系统从 chatbot serving 继承了以 SLO 为中心的策略:立即接纳每个就绪 prefill 以压低 TTFT,同时维持大 decode batch 以最大化 decode 吞吐。但 agentic 工作负载(编码 agent、web-search agent)把中间 token 生成对用户隐藏,用户只感知每轮完成和工具调用动作。因此主指标从"满足 TTFT/TPOT 下最大化 goodput"变成"直接最小化完成时间"。作者提出两个根本问题:优化 chatbot SLO 是否等价于优化 agentic JCT?决定 JCT 的底层 trade-off 到底是什么?
Agentic 轮次的一个结构性特征放大了这一错配:相邻轮共享绝大部分上下文,平均前缀缓存命中率 >95%,于是每轮只在数万 token 的缓存前缀上追加不到 1K 新 token —— prefill 极短、极碎、远未打满硬件。
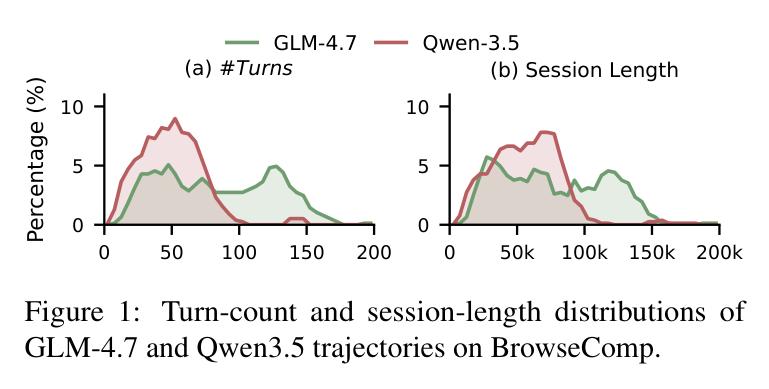
Paper's Figure 1(caption: "Turn-count and session-length distributions of GLM-4.7 and Qwen3.5 trajectories on BrowseComp."). 该图说明会话长度可达 200k token、轮数长尾,读者应注意:长会话 + 高前缀复用共同导致「短增量 prefill 摊在长缓存前缀上」,正是后文调度优化的靶心。
Q2 — 方法 (做了什么) #
三个层次的贡献:
- 问题重构 (§3):把 JCT 形式化为 overall(makespan)/ turn-level / trajectory-level 三层嵌套指标(Eq. 2–4),并把 turn-level JCT 分解为 $t_{\text{queue}}+t_{\text{prefill}}+t_{\text{decode}}+t_{\text{stall}}$(Eq. 5)。
- 调度探索 (§4):引入 PD Orchestration,用单一 orchestration interval $I$ 作旋钮(跑 $I$ 个 decode step 才重新考虑接纳 prefill,$I=1$ 即 prefill 优先),扫描发现内部最优($I=128$),墙钟时间变化最多 1.40×。
- 并行探索 + 系统 (§5–§6):证明 PP 提供更优的 prefill–decode 平衡,构建 PipeSwift —— JCT 感知调度层(prefill cost-model 微批划分 + 自适应 decode 重划分)+ PP 内嵌 MTP(verify-extend-draft 循环 + 负载均衡层划分),跑在 SPMD 分布式调度架构上。
- 任务类型:开放式(编码 SWE-Bench、web 搜索 BrowseComp),非闭合式单轮 RAG。
- 交互模式:多轮长时(会话长度可达 100k+ token,轮数长尾)。
- 自治度:全自治轨迹回放;本文关注的是引擎侧服务,而非 agent 决策策略本身 —— agent 逻辑被固定为确定性 trace,隔离出调度/并行的性能。
- 短期记忆:上下文窗口即会话累积上下文,靠前缀缓存复用(命中率 >95%)。
- 长期/情节记忆:轨迹日志(trace 回放的 per-turn request、MTP 接受长度、工具延迟)—— 本文把它当作确定性输入。
- 工具调用与错误恢复:工具执行在引擎之外,其记录时长 $t_{\text{tool},j}$ 决定下一轮何时就绪;引擎侧的"错误恢复"体现在 decode 被 prefill 打断后回到 Decode 状态。
- 规划风格:预定工作流(trace 固定),本文不改 agent 规划;引擎侧的"规划"是调度器决定 prefill 何时成 wave、decode 如何分桶。
- 预算:orchestration interval $I$ 全程固定为 32(无 per-workload 调参);MTP 每步 3 draft token、验证宽度 4;chunk-size 8192。
- 回溯:无 agent 级回溯;MTP 的 verify 阶段会根据接受长度回退未接受的 draft token。
- Eq. 2 overall JCT $=\min(\max_{i\in B}C_i - A_B)$:makespan,等价于最大化 $|B|/\text{makespan}$(任务吞吐)。
- Eq. 5 turn-level 分解:把每轮延迟拆成自身工作 + 排队 + 被打断。prefill 优先最小化 $t_{\text{queue}}$ 却忽视 $t_{\text{stall}}$,碎片化 prefill 抬高所有在飞请求的 $t_{\text{stall}}$。
- Eq. 6 $f(x)=\alpha x^2+\beta x$:prefill 成本 = 注意力二次项 + per-token 线性项。
- Eq. 7 $\tilde g(c,x)=f(c+x)-f(c)$:只计新 token 在已缓存前缀之上的边际成本。
- Eq. 9 $T_{\text{wave}}(K)\approx(K+P-1)(W/K+\gamma)$:$K+P-1$ 为 fill+drain 步数;权衡 bubble(随 $K$ 增)与固定开销(随 $K$ 摊薄)。
- Eq. 10 $K^*\approx\sqrt{(P-1)W/\gamma}$:Eq. 9 的闭式最小值点 —— $W$ 或 $P$ 越大微批越多,$\gamma$ 越大微批越少。
- 成功率/性能扫描沿轴单调性:Tab. 2 沿 $I$ 扫描,wall time 呈 U 形(3020→2482→3486),P 单调降、D 单调升 —— 与 Eq. 5 的 $t_{\text{prefill}}$↓/$t_{\text{stall}}$-driven decode 效率↓一致。✅
- prefill 聚合量级检查:Tab. 2 P 列 1093.7→304.6 (≈3.6×),若个体 prefill 已打满硬件则不可能,反证"远低于 compute-bound"。✅
- tail-percentile 最优点漂移:P50 最优 $I=32$、P90 $I=128$、P99 $I=512$,与 Insight #3「decode 越长越受益于少打断」的方向一致。✅
- 并行—调度耦合预测:Insight #5 预测更便宜的 prefill 把最优 $I$ 推小;Fig. 8 实测 PP 最优 $I=16$ vs EP $I=32$。✅
- MTP 贡献数值一致性:Tab. 5 给 1.31× (scheduling) × 1.74× (MTP) = 2.29×;但 §7.2 正文写"a further 1.83×"(30.73→与另一处不符)—— 内部不一致,作者未消解,两值均保留。⚠️
- 命名一致性:正文系统名 "PipeSwift",Fig. 6 caption / Tab. 3 却写 "PDWeaver" —— 命名不一致,作者未消解。⚠️
- 每轮延迟预算 = LLM 推理(prefill+decode)+ 工具调用 $t_{\text{tool}}$(引擎外)+ 内存读(前缀缓存)。本文关注的是引擎侧那一段;未声称"交互式延迟"绝对值,而是相对 JCT 缩减。
- 失败模式分类:最主要的失败类是 2P2D 的 KV-transfer 超时崩溃(开源实现传全量 KV 而非增量,每轮多传 >30×),Tab. 4 显示队列非空占 74.9–100% 状态。PipeSwift 通过并置 + 不做跨池 KV 传输根本回避了这一失败类。
- SPMD 分布式调度器(§6.3):调度决策在每个 worker 复制,无中心调度器;靠确定性微批划分(Eq. 11 贪心 bin-packing)+ 同一 scheduling step 加入新请求来保证各 worker 一致 —— 否则分布式调度会发散。这是让动态 PP schedule 可实现的隐性前提。
- decode 自适应重划分只在两处触发(§6.1.2):一个 prefill wave 后、以及任一请求生成完成时;每次 flush 仅耗一个 decode step、贪心 bin-packing 几十微秒完成,故开销可忽略。忽略这个"稀疏触发"会误以为重划分很贵。
- LLM backbone 要求(§7):方法针对 360B+ MoE(GLM-4.7-360B GQA、Qwen3.5-397B 混合 GQA–GDN),需支持 MTP/投机解码格式;Qwen3.5 因混合注意力使 per-token KV 更小,天然缓解 2P2D 的传输压力。未做小 backbone 消融。
- 评测(§8 base):SWE-Bench + BrowseComp;指标为 overall JCT(makespan)与 turn-level mean/P50/P90/P99;baseline 为 SGLang EP16(±prefill delay)、vLLM PP2、2P2D(2× GPU)、及同引擎 EP8 参照点 —— 全部共享同一 kernel stack(DeepGEMM/DeepEP/FlashAttention-3),故差距只来自调度与并行。
- 生产就绪:确定性 trace 回放保证可复现;沙箱/密钥/限流不在本文范围(引擎侧研究)。
核心技术壁垒:把 MTP 的 draft–verify–extend 循环拆开、重排为 verify-extend-draft 并跨流水阶段协调(末阶段独做 extend+draft,其余阶段只做 verify forward),同时用非均匀层划分给末阶段留出 MTP 开销 headroom。这是当前开源系统全都缺失的能力(vLLM/SGLang 的 PP 均不支持投机解码),也是 PipeSwift 相对 vLLM PP2 拿到额外 ~1.74× 的来源。
Q3 — 结果 #
64×H800、两个 360B+ MoE(GLM-4.7-360B、Qwen3.5-397B)、SWE-Bench + BrowseComp 确定性轨迹回放下:overall JCT 比 SGLang wide-EP 快 1.21–1.45×,比 vLLM PP2 快 1.60–2.33×,比用了 2× GPU 的 2P2D PD-disaggregation 快 1.14–1.54×;P99 turn-level JCT 低于最佳 baseline 的一半(10.12s vs 20.86s)。即便给 wide-EP 配上其最优 orchestration,PipeSwift PP2 仍快 1.24×。
3. 架构 / 方法图 #
3.1 Agent scope #
3.2 The turn loop (agent 视角) #
每个 agent 轮次是一个闭环:轨迹在轮完成时推进,下一次工具/环境动作必须等完整响应返回后才能开始。
3.3 系统架构(引擎侧) #
PipeSwift 的两大能力都建在 SPMD 分布式调度架构上:调度决策(batch issue、KV-page 分配、请求驱逐)在每个 worker 上复制,消除中心调度器;靠确定性微批划分算法 + 同步骤加入新请求来保证各分布式调度器一致。
3.4 Planning & reasoning #
4. 作者证明 #
本文属系统论文:核心并非闭式收敛证明,而是成本模型 + 受控扫描 + 消融。就 agent 类惯例而言:无形式化作者证明 — 仅实证(可被形式化界定但作者未界定的量:给定 $(I, P, W, \gamma)$ 下的 wave 时间上界;实际只给了 Eq. 9–10 的近似最优 $K^*$)。下面给出关键 notation 与方程物理意义,并做 6 项一致性检查。
Notation 表 #
| 符号 | 含义 |
|---|---|
| $A_B, C_i$ | batch 提交时间 / 任务 $i$ 完成时间 |
| $\text{JCT}_{\text{turn},j}=r_j-s_j$ | 轮 $j$ 就绪到完整响应返回的延迟 |
| $t_{\text{queue}},t_{\text{prefill}},t_{\text{decode}},t_{\text{stall}}$ | turn-level JCT 的四项分解(TTFT $=t_{\text{queue}}+t_{\text{prefill}}$) |
| $I$ | orchestration interval(decode step 数) |
| $\ell^{\text{cache}}_i,\ell^{\text{new}}_i$ | 请求 $i$ 的缓存前缀长 / 新 token 数 |
| $\alpha,\beta,\gamma$ | prefill 成本模型的二次/线性系数 / 每微批固定开销 |
| $K, P$ | 微批数 / PP degree |
| $W$ | wave 内所有就绪轮的总长度相关计算量 |
| $\ell^{\text{kv}}_i$ | 请求 $i$ 当前 KV/上下文长度 |
方程物理意义(load-bearing) #
6 项最小检查 #
Agent 特定:延迟预算与失败模式 #
5. 实验与数据 #
5.1 调度扫描:内部最优的证据 #
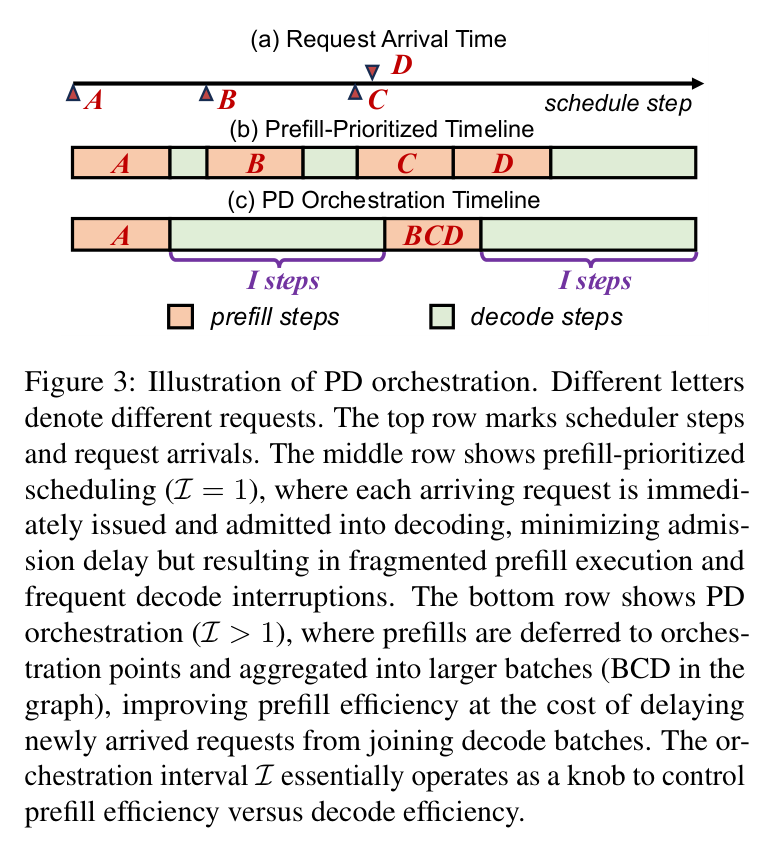
Paper's Figure 3(caption 述 $I=1$ 为 prefill 优先、$I>1$ 把 prefill 推迟聚合成大 batch). 中排($I=1$)每个到达请求立即接纳,导致碎片化 prefill 与频繁 decode 打断;下排($I>1$)把 BCD 聚合成一波,提升 prefill 效率但延后新请求进入 decode。读者应把 $I$ 理解为「prefill 效率 vs decode 效率」的连续旋钮。
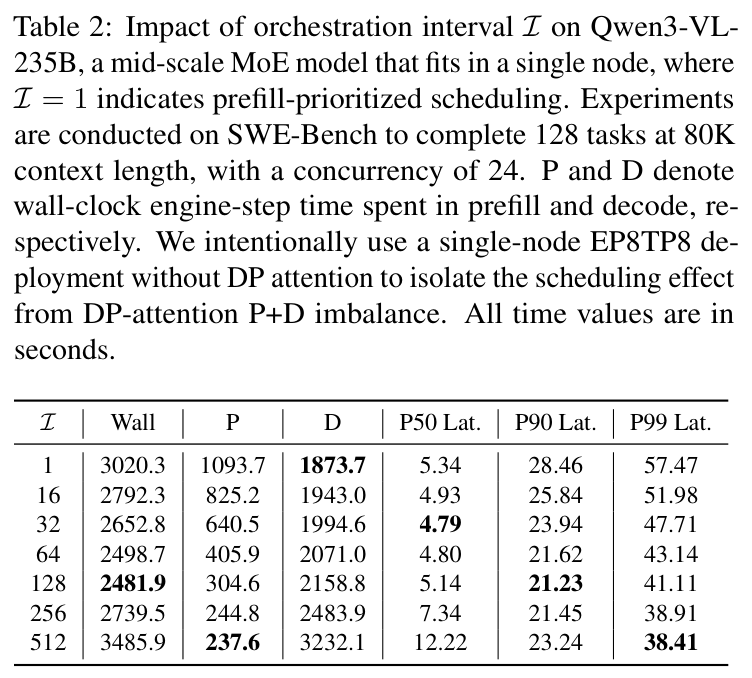
Paper's Table 2(Qwen3-VL-235B, 单节点 EP8TP8 无 DP attention). 这是全文最载重的实验:wall time 在 $I=128$ 取最小 2481.9s,两端更差($I=1$ 为 3020.3、$I=512$ 为 3485.9,比值 1.40×);P 列 1093.7→304.6 证明 prefill 远未饱和;P50/P90/P99 最优点随 percentile 右移,直接支撑「平衡而非极值」的核心论点。
5.2 端到端:PP 在 JCT 下反超 wide-EP #
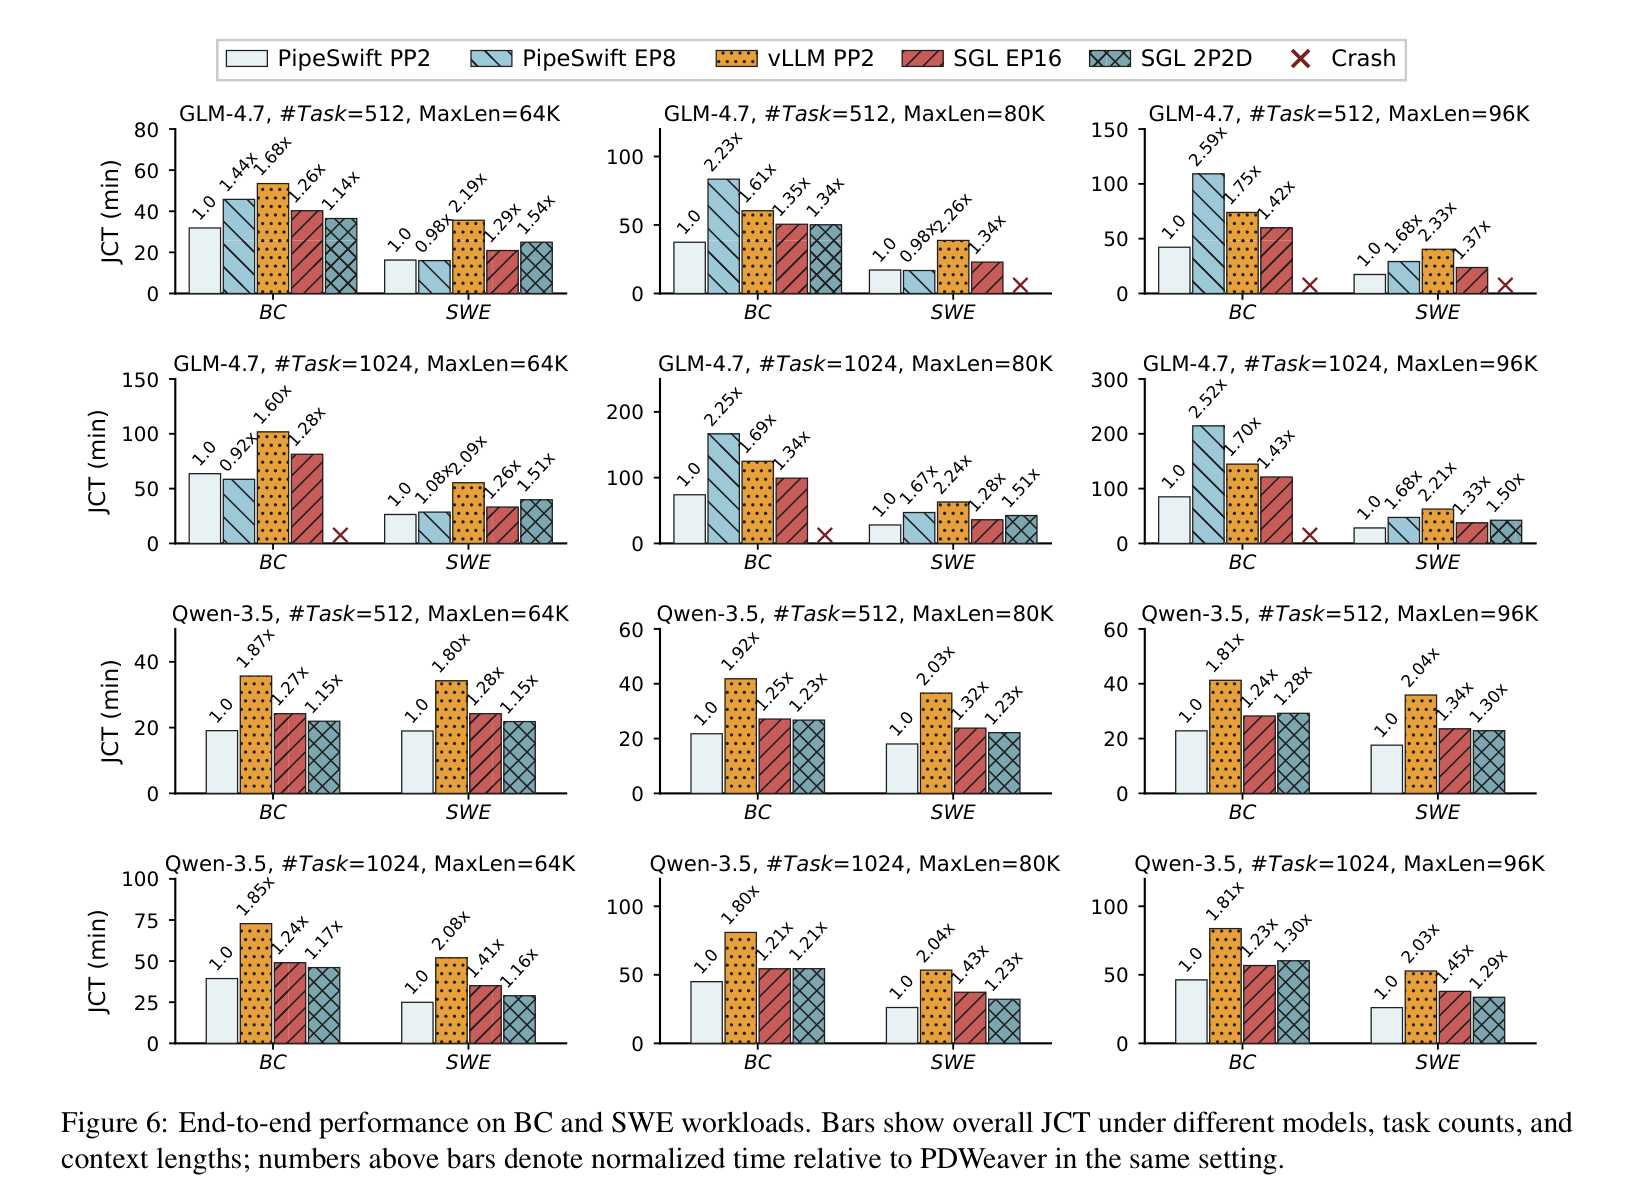
Paper's Figure 6(caption: "End-to-end performance on BC and SWE workloads...";bar 上数字为相对 PDWeaver 的归一化时间). 12 个子面板覆盖 {GLM-4.7, Qwen-3.5}×{512,1024 tasks}×{64K,80K,96K}。PipeSwift 在每个完成格中最低;"×" 崩溃标记集中在高压力 GLM 格(对应 2P2D 的 KV-transfer 失败)。注意短上下文/低压力下 EP8 或 PipeSwift 偶尔落后 SGLang EP16(<1×),说明优势并非无条件。
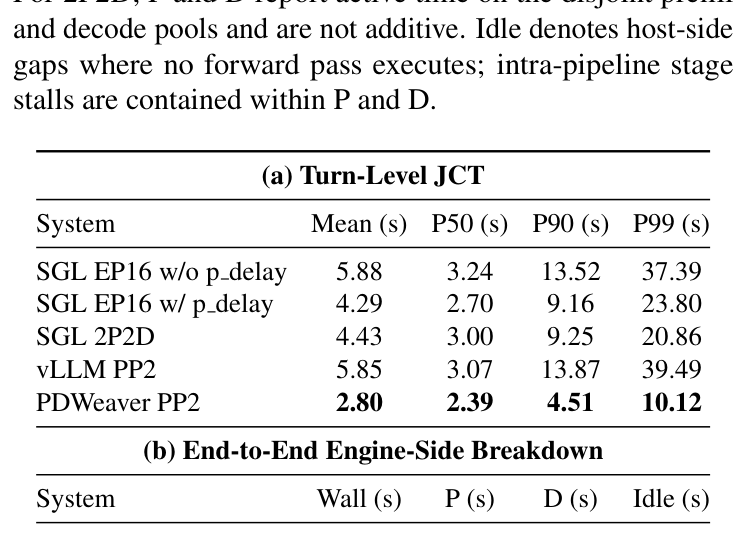
Paper's Table 3(GLM-4.7 BC, 512 tasks, 80K MaxLen;系统名此处标 "PDWeaver PP2"). (a) turn-level:PipeSwift P99=10.12s,不到次优 (2P2D 20.86s) 的一半。(b) 引擎侧:SGLang w/o p delay 的 prefill 独占 1962.4s,2P2D 用 2× GPU 仅打平(3004.7 vs 3031.4),vLLM PP2 无聚合无 MTP → decode 高达 2428.3s;PipeSwift 把 prefill 压到 705.8s、wall 到 2243.9s。
5.3 可扩展性与 2P2D 失败的机理 #
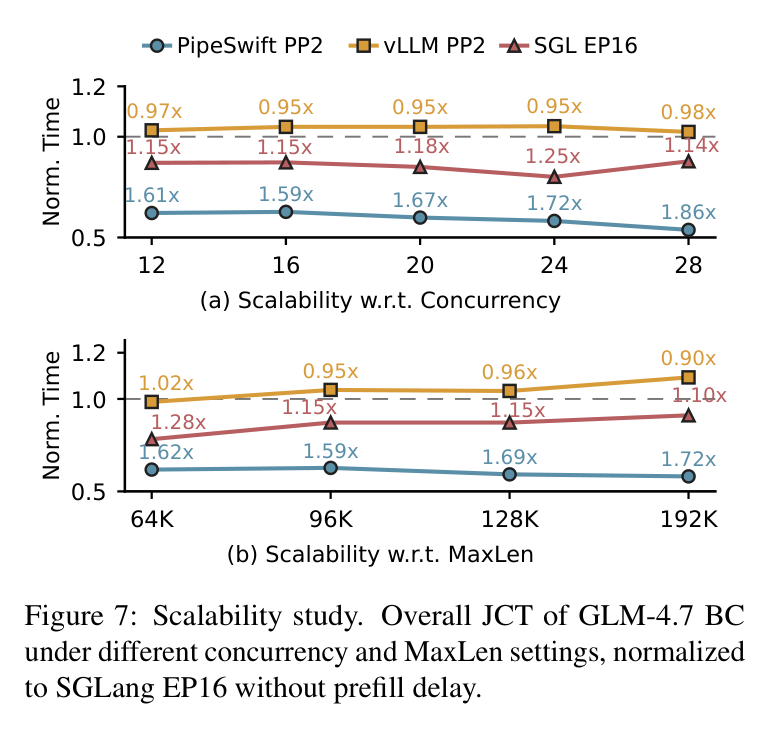
Paper's Figure 7(归一化到 SGLang EP16 w/o p delay). 争用越大优势越大:C=28 时相对 vLLM PP2 达 1.86×,MaxLen 192K 时达 1.72×。cost-model wave 划分 + 自适应 decode 重划分让微批在长上下文下仍均衡,故增益随压力上升而扩大,而非被侵蚀。
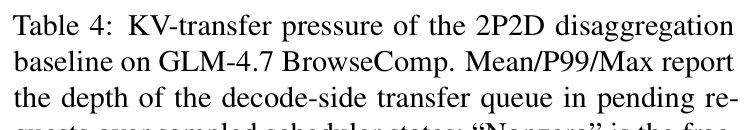
Paper's Table 4. decode 侧传输队列在 74.9–100% 采样状态非空;均值深度随 concurrency 从 1.28 升到 10.93、随上下文从 1.40 升到 4.32,最终超时崩溃。这解释了 2P2D 为何在高压 sweep 中缺席 —— 全量 KV 传输(而非增量)在 agentic「小增量 + 大缓存」下每轮多传 >30× 字节。
6. 论证链 #
| 步 | 论断 | 依据(论文内部) |
|---|---|---|
| 1 | Agentic 目标是 JCT(makespan/turn-level),非 token SLO;用户看不到 token 流 | §1 para 2, §3 Eq. 2–4 |
| 2 | prefill 优先虽拿最优 TTFT + 最高 decode 吞吐,却不是最优 JCT | §4.2 Insight #1;Tab. 2($I=1$ decode 最低但 wall 差 1.22×) |
| 3 | 原因:prefill 优先最小化 $t_{\text{queue}}$ 却让碎片 prefill 抬高所有请求的 $t_{\text{stall}}$ | Eq. 5 分解 + Tab. 2 P 列 1093.7→304.6 |
| 4 | 故 JCT 由 prefill/decode 效率的平衡决定,最优在内部($I=128$) | §4.2 Insight #3;Tab. 2 wall U 形 |
| 5 | 任何改变 prefill/decode 相对成本的机制都会移动最优点 → 转向并行轴 | §4.2 末 → §5 |
| 6 | PP 避免逐层跨节点 EP 通信、只做邻接 activation 传输,prefill 更快 | §5.2 Insight #4;Tab. 3(PP2 prefill 1122 vs EP16 1962) |
| 7 | PP 无需比 wide-EP 更好的 decode,只要 prefill 优势抵消 decode 增量即降低 JCT | §5.2 Insight #4 |
| 8 | 并行与调度须共同探索:更便宜的 prefill 把最优 $I$ 推小 | §5.2 Insight #5;Fig. 8(PP $I=16$ vs EP $I=32$,PP 仍快 1.24×) |
| 9 | 工程化 PP 需抑制 bubble(cost-model 微批)+ 把 MTP 塞进 PP(verify-extend-draft) | §6.1–§6.2 |
7. 实现 cross-reference #
系统为"open-source pipeline-parallel runtime"(摘要/§1/§6 均称开源),但 L1 未提供代码仓库 URL 或文件行号,因此:[实现未公开 —— L1 无仓库/行号引用]。以下为可从论文定位的关键实现细节与壁垒。
核心技术壁垒(单一最难复制点) #
PP 内嵌 MTP 的 verify-extend-draft 重排 + 非均匀层划分。SGLang 的 draft-verify-extend 是单机语义;搬到 PP 后,draft/extend 若放在每个 decode step 都要跨阶段协调,中心调度器难以承受。PipeSwift 让非末阶段只做 verify forward、末阶段独做 verify+extend+draft,每步把 accept length 与下批 draft token 经 P2P 回传给前序阶段更新状态。由于末阶段额外承担 KV 扩展 + MTP 层 + 采样,均匀分层会让末阶段成稳态瓶颈 —— 故给末阶段分更少 backbone 层,其余层重分到前序阶段(离线 profile per-layer verify + KV-extend + MTP + sample 成本后选整数层数)。这是 vLLM/SGLang 现有 PP 都不支持的能力,也是相对 vLLM PP2 额外 ~1.74× 的来源(§6.2.2, §7.5 Tab. 5)。