AgentRouter: Heterogeneous Model Routing for Cost-Optimal Multi-Step Agentic Workflows
AgentRouter — 逐步级异构模型路由 (L2) #
1. TL;DR #
一个 12M 参数、<5ms/步的前馈分类器,用 5 个路由时可提取的特征把智能体轨迹的每一步映射到四档模型(Frontier→7B)。相比全部走前沿模型,降本 72%、端到端质量仅降 <3%(保留 97.3%);关键在于"步内复杂度差异大"这一可利用性质,以及依赖感知标签 + 非对称损失。
2. 痛点 / 方法 / 结果(Q1 / Q2 / Q3) #
Q1 — 痛点 #
企业级智能体系统把轨迹的每一步都丢给前沿模型,导致 60–80% 的推理预算浪费在小模型就能等质完成的子任务上(格式化、字段抽取、简单检索)。现有路由器(RouteLLM、FrugalGPT)是为单轮查询设计的:它们把每次调用当作独立事件,而智能体轨迹有一个独特性质——同一条轨迹内子任务复杂度差异极大(规划步需要前沿推理,紧随其后的 JSON 格式化步只需 7B 模型)。单轮路由器错失两个信号:(a) 步 $t$ 的路由决策会影响步 $t{+}1$ 的上下文质量;(b) 累积轨迹上下文决定了一步的真实复杂度。
- 任务类别:开放式多步智能体工作流(文档分析、代码生成、研究综合、数据分析)。
- 交互模式:多步轨迹,每步一次 LLM 调用。
- 自主度:全自动路由 + 事后质量回退(human-out-of-loop,但有质量阈值兜底)。
Q2 — 方法 #
把步级模型路由形式化为智能体轨迹上的顺序分配问题(§3.1 式 (1)),在全局质量下限 $Q_{\min}$ 约束下最小化总成本。核心组件:
- 5 个路由时特征(§3.2):任务类型 $f_{\text{type}}$、推理深度 $f_{\text{depth}}$、工具需求 $f_{\text{tool}}$、输出格式 $f_{\text{format}}$、上下文窗口占用 $f_{\text{ctx}}$。其中 $f_{\text{ctx}}$ 是轨迹感知特征——单轮路由器天然缺失它。
- 12M 分类器(§3.3):类别特征学习嵌入 + 连续特征线性投影 → 两层 FFN(256→128,ReLU)→ 4 类 softmax → 选档。参数量由 2M 的 BERT 任务类型 tagger 主导。
- 依赖感知标签(§3.3):不孤立标注每一步;标注步 $t$ 时假设步 $1..t{-}1$ 已被路由到各自的"最小充分档",从而捕获下游步接收混合档上下文的真实情形。
- 非对称成本损失(式 (2)):对"配置不足"(路到过弱/过便宜档)的惩罚远重于"配置过度",使路由器在不确定时偏向更强模型以保质量。
- 71.8% 降本 @ 97.3% 质量(§4.2 表 1),路由开销仅 4.7ms/步。
- 同一基准上 RouteLLM 仅 31.4%、FrugalGPT 仅 44.1% 降本——它们的单轮训练信号错失了轨迹级质量依赖。
- 仅 14.2% 的步真正需要前沿模型,却占了成本的 48.3%(§4.3 表 2),从数据上证实了前提。
- 回退到前沿模型的触发率 <4% 的轨迹,尽管整体路由准确率只有 84.6%——说明多数错误是"配置过度"而非"质量损害型配置不足"。
- 记忆模型:短期 = 累积轨迹上下文(通过 $f_{\text{ctx}}$ 回写进下一步特征向量,算法 1 第 6 行);无长期/向量库记忆。
- 规划风格:非 ReAct、非树搜索——假设步序列在路由时已知(轨迹模板给定或由 planner 预先推断)。这是一次性的顺序分配,不在执行中动态重规划。
- 工具调用:$f_{\text{tool}} \in \{0,1,2+\}$ 仅作为特征影响选档,AgentRouter 本身不执行工具;工具执行由被选中的底层模型负责。
- 错误恢复:唯一的恢复机制是事后回退(算法 1 第 8–10 行),把质量不达标的步重执行到 Tier 1;生产中用一个轻量 LLM-as-a-judge 代理替代真值评估器,其 token 成本与延迟已计入 §4 的开销。
- 式 (1):$\min_{\pi}\sum_{t=1}^{T} c(s_t,\pi(s_t))\ \text{s.t.}\ Q(\tau,\pi)\ge Q_{\min}$。在全局(而非逐步)质量约束下最小化总成本——全局约束正是对"端到端质量不可分解"的编码:不能简单地让每步各自达标。
- 式 (2):$\mathcal{L}=\mathcal{L}_{\text{CE}}+\lambda\sum_t \max(0,\ k_{\text{pred}}(s_t)-k_{\text{label}}(s_t))^2$。由于档位索引越大越弱越便宜,$k_{\text{pred}}>k_{\text{label}}$ 意味着路到了比所需更弱的档(配置不足),$\max(0,\cdot)^2$ 项只在这种情况下触发,故损失非对称地惩罚配置不足、放过配置过度,驱使路由器向更强模型偏移以保质量。
- 量纲:式 (1) 两端均为成本(美元),约束两端为无量纲质量比。✔
- 边界/退化:若 $\lambda\to\infty$,式 (2) 退化为"永不配置不足",极限即全部路到 Tier 1(退化回前沿-only)。符合直觉。✔
- 单调性:特征消融(§4.4)显示移除任一特征都单调降低准确率($f_{\text{type}}$ −12.3 最大,$f_{\text{format}}$ −2.1 最小),无反号项。✔
- 非对称方向自洽:式 (2) 的惩罚方向与 §4.3 观察一致——Tier 2 的错误多为"过度配置到 Tier 1"而非"欠配置到 Tier 3"。✔
- 回退一致性:整体准确率仅 84.6% 却只有 <4% 轨迹触发回退,只有在"多数错误为无害的过度配置"下才自洽。✔
- 成本偏斜守恒:表 2 中各档"成本占比"之和为 100%,Tier 1 以 14.2% 的步数占 48.3% 成本,与 §1 的 3.4× 偏斜叙述一致。✔
- 核心技术壁垒(依赖感知标签流水线):复现本方法的真正难点不在 12M 分类器,而在训练数据的构造——需对 6,250 条轨迹的每一步 × 四档模型全部实际执行并用任务特定自动指标打分(文档抽取 F1 / 代码 pass@1 / 研究事实准确率 / 数据数值正确率),得到每步"最小充分档 = 质量落在前沿档 2% 以内的最便宜档"。再在"前序步已按最小充分档路由"的反事实假设下归因,才能把不可分解的 $Q(\tau,\pi)$ 折成可监督标签。这套穷举 + 反事实归因的标注管线是单轮路由器无法产出的,也是复制成本最高的部分(§3.3)。
- 关键实现细节 1 — $f_{\text{ctx}}$ 的回写时机:算法 1 第 6 行在每步执行后把实际输出长度、质量分、累积内容写回下一步的特征向量。漏掉这一步回写就退化成单轮路由,是最易被忽略却承重的一环(§3.3 第 6 行注解)。
- 关键实现细节 2 — 动态指令的冷启动默认档:当步指令在路由时尚不可用(指令由上游动态生成),任务类型 tagger 无法工作,论文将指令生成调用默认路由到 Tier 2,再靠事后回退兜底(§5 冷启动段)。这是一个易漏的边界约定。
- 档位切换频率:每轨迹中位 3.2 次模型-档位切换(8 步轨迹 95 分位 7 次);对按调用初始化计费的推理商,切换会非平凡地贡献总延迟(§5)。
- retrain 成本:架构轻量,模型池变动时重训 <2 GPU-hours(单 A100),但四档结构绑定 2026 初的定价/能力缺口,是硬编码假设(§5)。
核心技术壁垒:真正难以复制的不是分类器本身,而是依赖感知标签的生成流程——对 6,250 条轨迹的每一步用全部四档模型穷举执行并打分(F1 / pass@1 / 事实准确率 / 数值正确率),再在"前序步已按最小充分档路由"的假设下归因每步的最小充分档。这把不可分解的端到端质量 $Q(\tau,\pi)$ 折叠成了可监督的逐步标签,是该方法区别于单轮路由器的根本(详见 §7)。
Q3 — 结果 #
3. 架构 / 方法图 #
AgentRouter 的核心是在每步 LLM 调用之前插入一个轻量分类器,并在轨迹末尾加一个事后质量回退。下面用状态图刻画单步的 observation → route → act → update 循环与回退路径(论文无独立架构图,此处以 Mermaid 补全算法 1 的控制流)。
agent loop 要点:
4. 作者证明 #
无形式化作者证明 — 仅实证。 论文给出一个约束优化的问题陈述(式 (1))和一个训练损失(式 (2)),但不证明收敛性、不给出成本/质量的可证边界——这是智能体路由论文的常态。可以被界定却未被界定的量是:端到端质量损失相对最优策略的上界(论文仅经验性地报告 <3%)。
符号表 #
| 符号 | 含义 |
|---|---|
| $\tau=(s_1,\dots,s_T)$ | 一条智能体轨迹,$T$ 步,每步一次 LLM 调用 |
| $\mathcal{M}=\{m_1,m_2,m_3,m_4\}$ | 四档模型,按能力与成本排序($m_1$=Frontier) |
| $\pi: s_t \to \mathcal{M}$ | 路由策略 |
| $q(s_t,m),\ c(s_t,m)$ | 步 $s_t$ 由模型 $m$ 服务时的质量 / 成本 |
| $Q(\tau,\pi)$ | 策略 $\pi$ 下的端到端轨迹质量(不可分解为逐步项) |
| $Q_{\min}$ | 用户指定质量下限(实验中设为前沿-only 基线的 97%) |
| $k_{\text{label}},k_{\text{pred}}$ | 档位索引 (1–4),标签 / 预测 |
| $\lambda$ | 成本敏感正则系数,$=0.3$ |
方程物理意义 #
6 项最小检查 #
5. 实验与数据 #
设置:2,400 条留出轨迹(4 域各 600 条,4–12 步),共 18,720 次步级路由决策。四档实价(2026-02):GPT-4o \$15/M、GPT-4o-mini \$2.40/M、Llama-3-70B \$0.88/M、Llama-3-8B \$0.18/M。
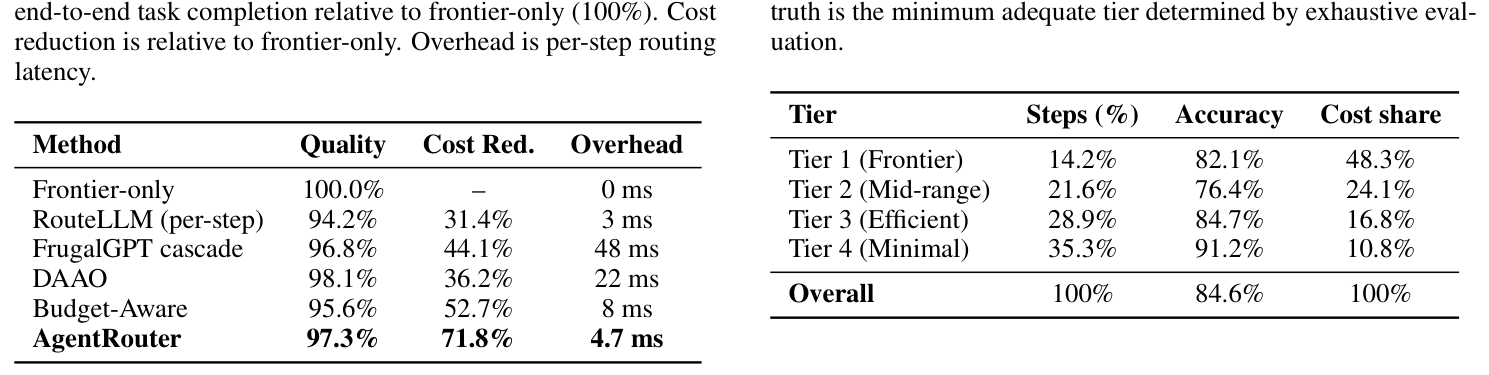
论文 Table 1(逐字)。 这是全文最承重的结果:AgentRouter 以 71.8% 降本保住 97.3% 质量、开销仅 4.7ms。读者应注意两个失败模式的对照——RouteLLM 降本最差(31.4%),因为其单轮偏好路由器误判了依赖累积上下文的步;DAAO 质量最高(98.1%)但只降本 36.2%,因为它用 VAE 给整条轨迹打一个难度分,按最难的那步给所有步配置,恰恰浪费在"步内复杂度差异"上。FrugalGPT 的 48ms 开销来自顺序探测模型,是 AgentRouter 的 10×。

论文 Table 2(逐字),真值为穷举评估得到的"最小充分档"。 这张表解释了降本从何而来,并验证核心前提:35.3% 的步落在 Tier 4、28.9% 落在 Tier 3,而只有 14.2% 真正需要 Tier 1——却占了 48.3% 成本。读者应注意模糊峰在中间:Tier 2 最难分类(76.4%),低于 Tier 1(82.1%)和 Tier 4(91.2%),因为"需要中档推理"与"70B 也能搞定"的边界最含糊。非对称损失使 Tier 2 的错误多偏向"过度配置到 Tier 1",以适度成本换质量。
消融(§4.4,用边际分布替换各特征):
| 移除特征 | 准确率降 | 备注 |
|---|---|---|
| $f_{\text{type}}$ 任务类型 | −12.3 | 主导特征;降本掉到 54.2% |
| $f_{\text{depth}}$ 推理深度 | −7.1 | 第二 |
| $f_{\text{ctx}}$ 上下文占用 | −4.8 | 第三——证实轨迹感知价值 |
| $f_{\text{tool}}$ 工具需求 | −3.2 | |
| $f_{\text{format}}$ 输出格式 | −2.1 | 最弱 |
分域降本:文档分析 76.4% > 数据分析 74.1% > 研究综合 69.2% > 代码生成 63.8%。代码生成最差,因为其 26.3% 的步需要 Tier 1(文档分析仅 8.7%)——headline 72% 是四域平均。
跨框架泛化(§5):训练于 LangGraph/CrewAI,测试于未见的 AutoGen 掉 6–9% 准确率,但降本仍达 58%。
6. 论证链 #
| # | 论证步骤 | 依据(本文内部) |
|---|---|---|
| 1 | 智能体轨迹内步级复杂度差异极大(规划步需前沿,格式化步只需 7B) | §1 七步文档工作流案例:$0.42 → $0.18(57% 降本,无质量损失) |
| 2 | 因此端到端质量 $Q(\tau,\pi)$ 不可分解为逐步项,需在全局约束下做顺序分配 | §3.1 式 (1) + 非分解性论述 |
| 3 | 为在监督学习中处理不可分解性,用依赖感知标签:标注步 $t$ 时假设前序步已按最小充分档路由 | §3.3 标注协议 |
| 4 | 用 5 个路由时特征 + 12M 分类器 + 非对称损失即可以 <5ms 开销捕获该变化 | §3.2–3.3;式 (2) |
| 5 | 实证:71.8% 降本 @ 97.3% 质量,远超单轮路由器(31%/44%)与轨迹级优化器(DAAO 36%) | §4.2 表 1 |
| 6 | 降本来源可归因:14.2% 步需 Tier 1 却占 48.3% 成本,多数步可降档 | §4.3 表 2 |
| 7 | 消融确认特征重要性排序,且 $f_{\text{ctx}}$(轨迹感知)为第三大贡献 | §4.4 |
7. 实现 cross-reference #
[实现未公开] — 论文为 ICML 2026 接收稿,实现细节与路由配置声明在"supplementary materials"中(§4.1 脚注 1),但主 PDF 未附、代码未开源。以下为从论文正文可复现的关键实现细节: