Token-Efficient Multi-Agent Collaboration via System One-Guided Computational Division of Labor
Token-Efficient Multi-Agent Collaboration via System One-Guided Computational Division of Labor — L2 #
1. TL;DR #
多智能体系统里"协调决策"(选任务、派角色、判停止)本是有界选择,却被昂贵 LLM 当自由生成来做,token 随轨迹线性膨胀。S1-MAS 把协调交给轻量 System One 控制器(Laya)+ 轻量阅读器(Qwen3-0.6B)定位证据,只把开放式推理留给 GPT-4o worker。7 基准上精度最高(均 93.97%),token 降 44.9–97.2%,延迟降 37.8–93.0%。
2. Q1 / Q2 / Q3 #
Q1 — 痛点 (Pain Point) #
现有 LLM 多智能体框架把任务推理与协调操作(任务选择、角色分配、消息路由、上下文管理)紧耦合在同一个强 LLM 上。随着交互轨迹变长,协调本身重复调用 GPT-4o 去"生成控制指令、解释中间历史、维护交互状态",token 开销与延迟随之线性膨胀,成为 agentic Web 服务可扩展性的瓶颈。作者的关键观察:许多协调操作在本质上是有界的(从可行任务里选一个、判断是否需要再检查、判断证据是否充分),不需要无约束生成,用通用语言生成来做是一种计算浪费。
Agent 任务刻画:任务类是半开放的信息搜寻 + 推理(数学、知识问答、代码、Web 问答);交互是多轮迭代协作;自主性为全自主(无 human-in-the-loop,无任务特定训练)。
Q2 — 方法 (Method) #
提出 S1-MAS:一种 System One 引导的"计算分工"(computational division of labor)。核心是把一次协作循环拆成三类计算角色:
- 轻量 System One 控制器(Laya) — 做有界协调决策:选检查条件 $\chi_t$、从可行菜单 $W_t$ 选下一任务 $j_{t+1}$、判是否 finish。它对候选在小组内做前序/逆序双向打分并按身份对齐取平均,降低呈现顺序敏感性。
- 轻量阅读器(Qwen3-0.6B) — 对检查条件在当前候选答案里定位证据 $\ell_t = R(q,\chi_t)$,给控制器提供 grounding,无需 LLM 前向。
- LLM worker(GPT-4o) — 只做实质推理/评审/修订,执行 6 种操作(Solve/Decompose/Reverse/Review/Repair/Contrast)。
- 精度:6 个主基准全部第一,宏平均 93.97%,超过 DyLAN(93.12%)0.85 pp、AgentVerse(92.43%)1.54 pp。
- Token:均 455 输入 / 392 生成 tok/题,相对 5 个 MAS 基准降 78.3–94.0%;7 基准 21 对比中整体降 44.9–97.2%。
- 延迟:均 16.8 s/题,相对 5 MAS 基准降 58.2–91.7%(7 基准口径 37.8–93.0%)。
- 消融:System One 路由(84.17%)优于 GPT-4o-mini 路由(83.14%)且省 75.5% token;优于随机路由(82.34%)。
- Web:WebSRC EM 90.11%,延迟 9.47 s,token 比三基准省 51.2–85.0%。
- 记忆模型:短期 = 档案 $H_t$(任务—响应对,含角色/源/检查结果);结构记忆 = 通信 DAG $G_t$;去重记忆 = 检查账本 $A_t$(记"尝试过的检查"而非"已验证")。
- 工具调用:任务即协调单元,6 种操作有固定源需求与角色映射,属类型化有界动作,不是自由函数调用。
- 错误恢复:Repair 操作专门修"缺答案/截断/代码接口缺陷";若所有选项被拒且无可解析答案,则仅用原题重解(回退到 Solve)。
- Eq 1 $G_t=(V_t,E_t),\ V_t=\{v_i:1\le i\le t\}$:协作的 provenance 骨架;边 $(v_i,v_k)$ 当且仅当完整响应 $m_i$ 作为 $j_k$ 的直接输入。
- Eq 2 $S_t=(q,H_t,A_t,B_{src}-u_t)$:喂给控制器做所有决策的完整状态。
- Eq 3 $W_t=\text{Compile}(S_t,\chi_t)$:确定性裁剪动作空间,保证有界且不违预算。
- Eq 4 $\ell_t=R(q,\chi_t)$:阅读器把"读历史找证据"从 LLM 前向剥离。
- Eq 5 $m_{t+1}=\text{LLM}(\text{Prompt}(q,j_{t+1},\tilde{e}(j_{t+1}));\,B_{out})$:唯一做推理的 LLM 调用。
- Eq 6 $u_t=\sum_{i=1}^{t}\text{tok}(\tilde{e}(j_i))\le B_{src}$:源传输预算,重复拷贝重复计费。
- Eq 7 $V_{t+1}=V_t\cup\{v_{t+1}\}$、$E_{t+1}=E_t\cup\{(v_i,v_{t+1})\mid v_i\in P(j_{t+1})\}$:DAG 增量更新。
- 量纲/计数一致性:$t$ 只数 worker 执行;控制器与阅读器调用显式排除。Eq 6 对 $i=1..t$ 求和与 $t$ 的定义一致。✓
- 边界 $t=0$:$S_0,G_0$ 初始化,$u_0=0$;无源任务(Solve/Decompose/Reverse)贡献 0 token,与 Eq 6"无早期响应贡献零"一致。✓
- 预算单调性:$u_t$ 随 $t$ 非减,$\tilde{e}\supseteq e$ 的高亮不减 token;$u_t\le B_{src}$ 由 Compile 前置保证,未见反例。✓
- 有界动作:$W_t$ 只含前置满足且预算可容的任务;finish 单独处理;动作空间有限 → System One 可在类型化菜单上打分。✓
- 终止性:两条停止路径(控制器选 finish / $t=T_{max}$ 强制)覆盖所有分支,循环必停;$T_{max}=4$。✓
- DAG 无环:边仅从 $v_i\ (i\le t)$ 指向新顶点 $v_{t+1}$,时间单向 → 结构上无环,与 "directed acyclic graph" 声明自洽。✓
- 成功率扫描矩阵:沿 (benchmark × baseline) 二维扫描(Table 1/2 + Fig 3),精度对 S1-MAS 单调占优于 5 MAS 基准;token/延迟沿所有基准方向单调更低。
- 单轮延迟预算:协调(控制器)+ 证据(阅读器)+ worker 推理;16.8 s vs Vanilla 10.4 s,协调净开销约 6 s,证实"交互级延迟"。
- 失败模式分类:论文未给出显式失败类目分布;Repair 操作隐含三类目标故障(缺答案/截断/代码接口缺陷)。这是一处可补强的弱项。
- vs 随机路由:84.17% → 82.34%,token 几乎相同(535,918 vs 542,491)——证明 System One 的决策质量本身有价值,而非仅靠框架。
- vs GPT 路由:GPT-4o-mini 路由仅 83.14% 却烧 2.19M token(S1-MAS 0.54M),即 System One 省 75.5% token 且精度更高。这是全文最有力的一击:把有界协调交回生成式 worker 既贵又不更准。
- vs 去阅读器:去掉证据定位省 11.1% token 但掉 1.76 pp 精度——证据定位的"性价比斜率"陡,阅读器既喂控制器决策又给 worker 高亮注意力线索。
- 双向打分去顺序偏置:控制器在小组内对候选"前序 + 逆序"两次打分,按目标身份对齐取平均,以抵消 System One 对菜单呈现顺序的敏感性(§4.1)。这是让小模型路由稳定的隐藏技巧,易被忽略。
- 检查账本记"尝试"而非"已验证":$A_t(i)$ 只记录"对 $m_i$ 尝试过某检查",用于避免重复 Review,但不把被检内容当作已确认正确;且新响应仅在同源且输出标识相同时继承检查记录(§4.3)。误把它当正确性缓存会破坏语义。
三者组成 decision–evidence loop:选任务 → 动态决定 worker 角色与源访问 → 执行 → 更新状态,无需任务特定训练。一个确定性编译器 $\text{Compile}(S_t,\chi_t)$ 把动作空间裁到满足前置条件且符合通信预算的任务,从而保证有界决策;停止后由确定性 delivery rule 直接返回归档答案,不额外调 LLM 做终评。
核心技术壁垒:把"协调"重新形式化为可由非生成式 System One 模型在受约束动作空间上执行的有界决策,同时用一个亚十亿参数阅读器把"读历史找证据"从 LLM 前向里剥离出来——两者合起来才使协调几乎零 GPT token,却不损失(甚至提升)协作精度。难点不在单个组件,而在于设计出让 System One 能无 LLM grounding 就可靠路由的状态/证据接口($S_t$、$\chi_t$、$\ell_t$、$W_t$ 的闭环)。详见 §7。
Q3 — 结果 (Result) #
3. 架构 / 方法图 #
3.1 协调—推理解耦(动机) #
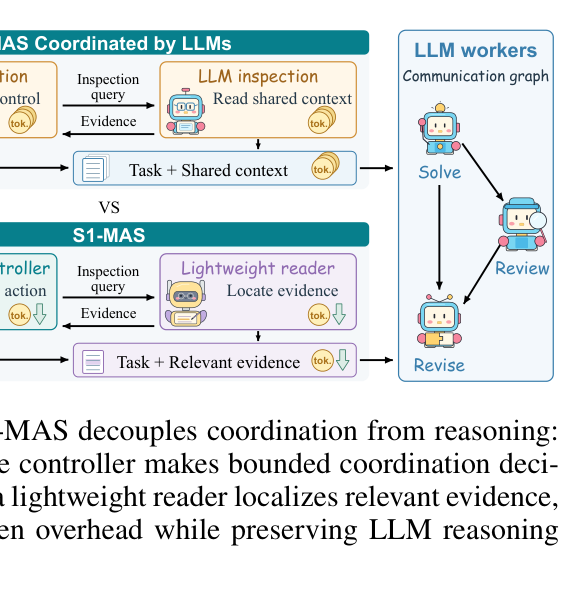
论文 Figure 1。 左侧 "MAS Coordinated by LLMs":LLM 既生成控制指令(coordination)、又读共享上下文做 inspection,再把"任务 + 完整共享上下文"喂给 worker——每一步协调都烧 GPT token。右侧 S1-MAS:System One 控制器只"Choose one action",轻量阅读器只"Locate evidence",worker 收到的是"任务 + 相关证据"而非全量上下文。读者应注意:省 token 的来源有二——(1) 协调决策不再过 LLM;(2) worker 的输入上下文被证据定位裁短。
3.2 S1-MAS 总览与 AQuA 实例 #
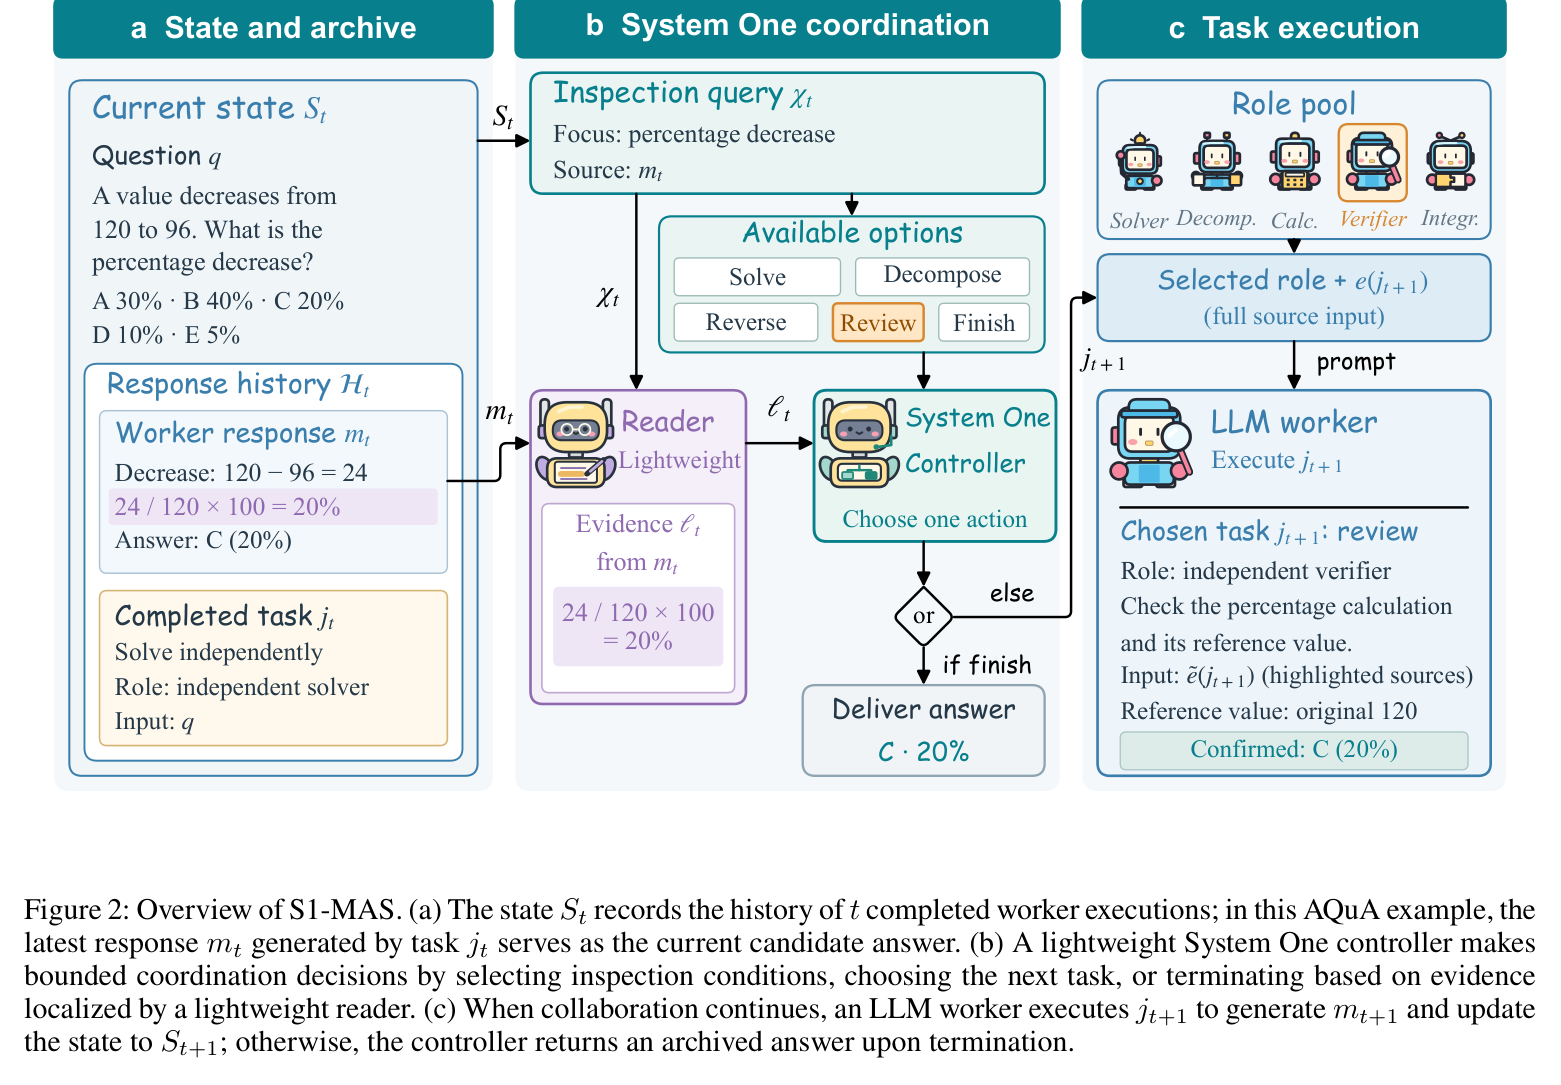
论文 Figure 2。 (a) 状态 $S_t$ 记录 $t$ 次已完成 worker 执行的历史,图中 AQuA 实例的最新响应 $m_t$(由任务 $j_t$ 生成)充当当前候选答案;(b) System One 控制器通过"选检查条件 / 选下一任务 / 终止"做有界协调,依据阅读器定位的证据 $\ell_t$;(c) 若继续,LLM worker 执行 $j_{t+1}$ 生成 $m_{t+1}$ 并更新到 $S_{t+1}$,否则终止时返回归档答案。实例链路清晰展示了 decision–evidence loop:问题"120→96 的百分比下降",worker 给出 "24/120×100=20%, Answer C",控制器选条件"percentage decrease"、源 $m_t$;阅读器定位证据 "24/120×100=20%";控制器选任务 review(角色=independent verifier);verifier 确认 "C (20%)";交付 C。
3.3 Agent 循环的状态机视角 #
原论文无显式状态机图,用 Mermaid 补一张一轮协作的状态转移,突出"控制器/阅读器调用不计入 $t$"与"finish 不再调 LLM"这两个关键分支:
4. 作者证明 #
无形式化作者证明 — 仅实证。 本文无收敛性或成功率的形式化保证(agent 论文常态)。它给出的是一套形式化系统模型(状态空间、通信图、预算约束)+ 全实证评估。可被形式化约束但作者未证的量:给定 $B_{src}$ 与 $T_{max}$,单题的 worker 调用数与源 token 消耗存在确定性上界;下方符号表与方程物理意义先行,随后是 6 项最小核查。
符号表(notation) #
| 符号 | 含义 |
|---|---|
| $q$ | 原始问题;$C(q)$ 为按句切分得到的检查目标集 |
| $t$ | 已完成 worker 执行数(控制器/阅读器调用不计入) |
| $S_t$ | 状态元组 $(q, H_t, A_t, B_{src}-u_t)$ |
| $G_t=(V_t,E_t)$ | 第 $t$ 步的响应依赖 DAG;$v_i$ 为第 $i$ 次执行,$m_i$ 为其响应 |
| $H_t$ | 有序档案:完成的任务—响应对 $(j_i,m_i)$ + 角色/源/检查结果 + 输出标识 |
| $A_t$ | 检查账本;$A_t(i)$ 记录对 $m_i$ 的检查尝试(非正确性) |
| $\chi_t$ | 检查查询 = 选中的 $C(q)$ 句子 + 当前候选响应 |
| $\ell_t$ | 证据记录 = 阅读器定位的源片段 + 偏移 + 条件 + 源身份 |
| $W_t$ | 可行任务菜单 $=\text{Compile}(S_t,\chi_t)$ |
| $j_{t+1}$ | 选中的下一任务;$P(j_{t+1})\subseteq V_t$ 为其源顶点集 |
| $\tilde{e}(j_{t+1})$ | 带高亮线索的授权源输入(无线索时 $=e(j_{t+1})$) |
| $B_{src},\,u_t,\,B_{out},\,T_{max}$ | 源 token 预算 / 已耗源 token / 单次输出上限 / worker 执行上限 |
方程物理意义 #
6 项最小核查 #
Agent 专项核查 #
5. 实验与数据 #
5.1 主结果:精度 #
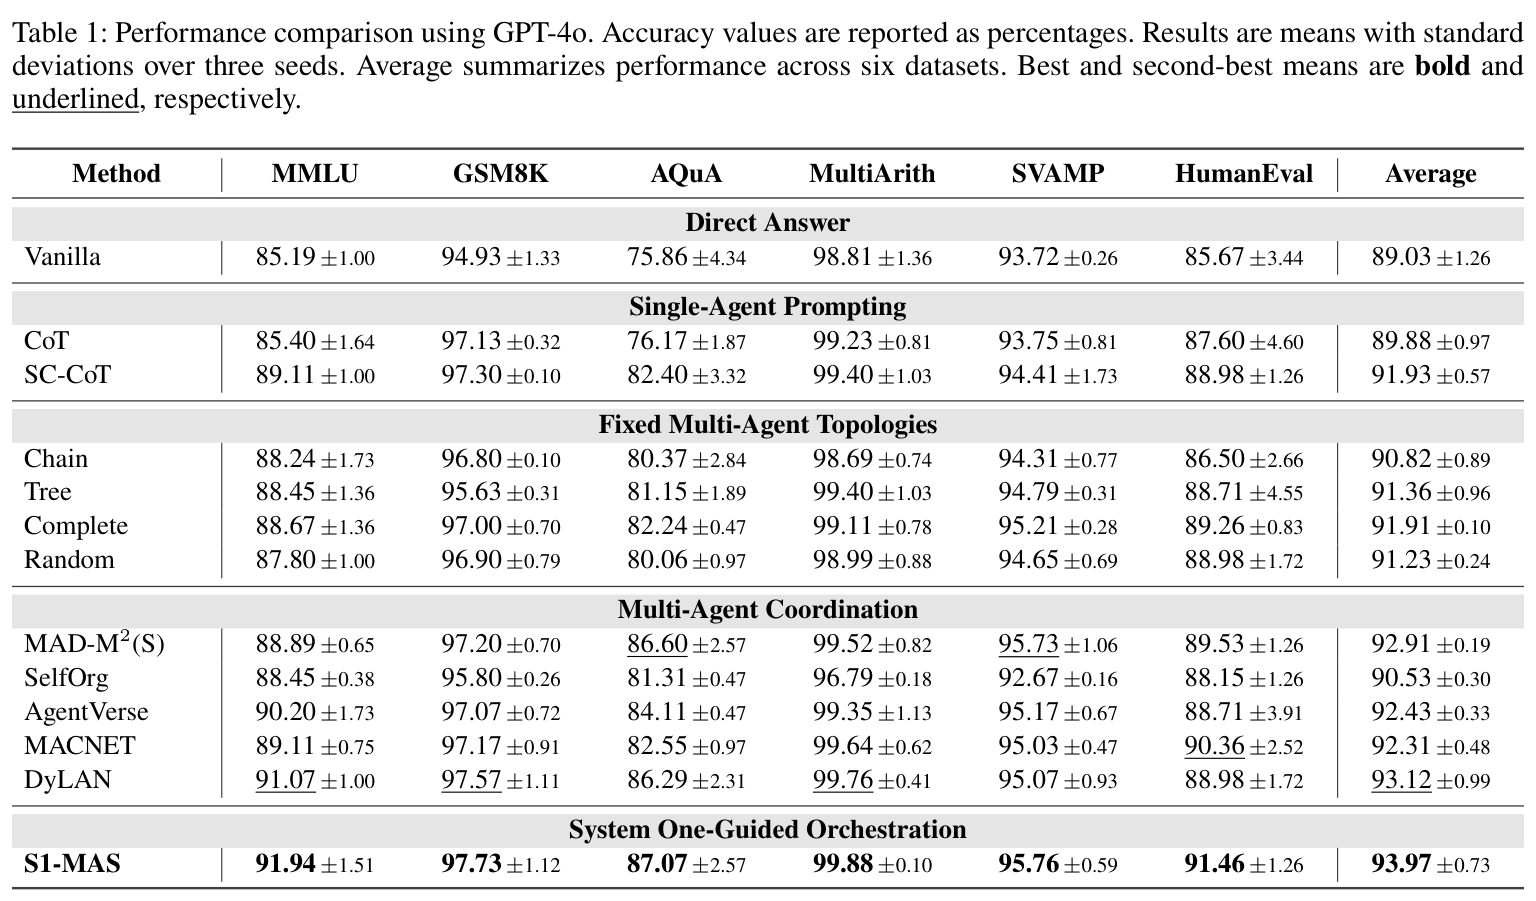
论文 Table 1(GPT-4o,3 seed 均值±标准差)。 S1-MAS 在 MMLU/GSM8K/AQuA/MultiArith/SVAMP/HumanEval 全部 6 个基准取得最高均值,宏平均 93.97%。值得注意的是它在 HumanEval 达 91.46%,超过该项最强替代 MACNET 的 90.36%;而它仅允许 $T_{max}=4$ 次 worker 执行,却压过深度无约束的 DyLAN。
5.2 主结果:token 与延迟 #
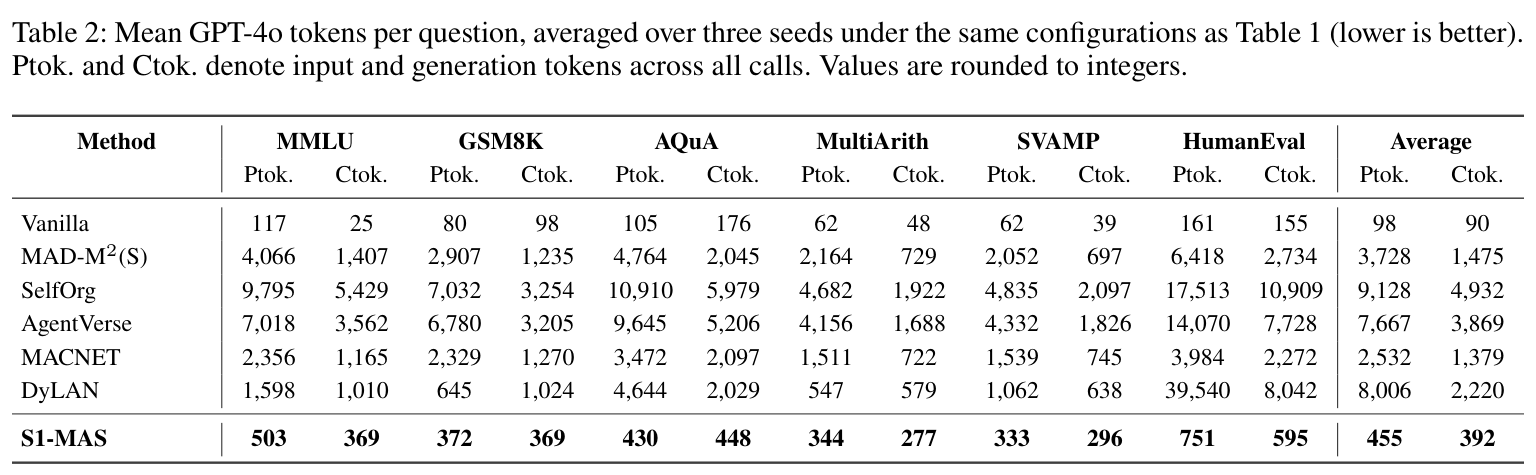
论文 Table 2(每题平均 GPT-4o token,越低越好)。 S1-MAS 均 455/392(输入/生成),相对 5 MAS 基准降 78.3–94.0%,且在每个基准上输入与生成 token 都更少。一个开放性反常点:DyLAN 在 HumanEval 的输入 token 高达 39,540(生成 8,042),远超其自身 MMLU 的 1,598——论文未解释该尖峰,但它拉高了 DyLAN 的平均。
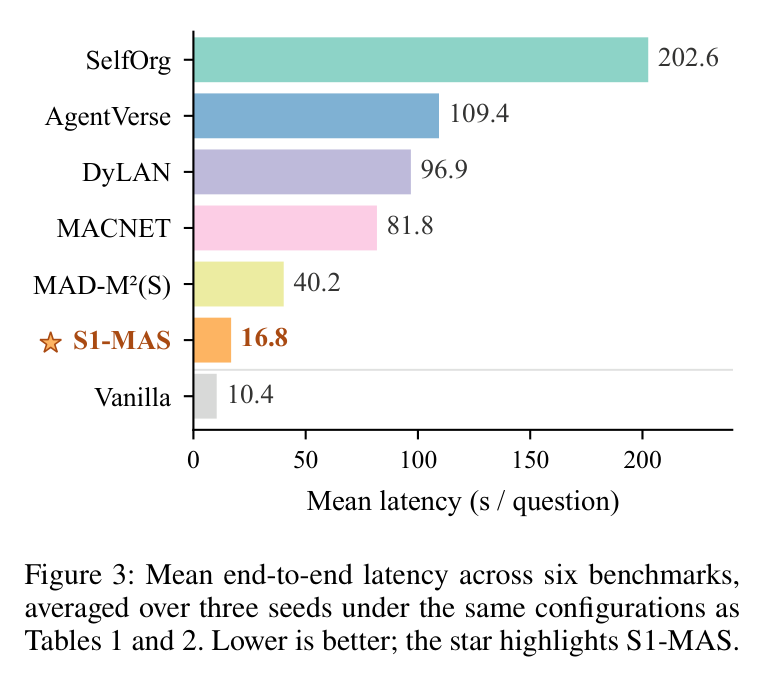
论文 Figure 3(6 基准平均端到端延迟,星号为 S1-MAS)。 S1-MAS 16.8 s/题,介于最重的 SelfOrg(202.6 s)与裸 Vanilla(10.4 s)之间,相对 5 MAS 基准降 58.2–91.7%。延迟下降的机理:自适应停止限制 worker 执行数,交付直接返回归档响应、不再额外调 GPT 做评判或综合,从而减少串行 GPT 生成。
5.3 消融:谁在起作用 #
论文 Table 3(GPT-4o-mini,3 seed 均值)。 三条关键对照:
5.4 Web 问答泛化 #
论文 Table 4(WebSRC,GPT-4o,纯 HTML 无视觉输入)。 S1-MAS EM 90.11% 为最高、延迟 9.47 s 为最低,token 比 AgentVerse/DyLAN/SelfOrg 省 51.2–85.0%。说明"先定位证据再协调"的机制在需要从结构化网页定位信息的任务上同样成立,支撑了结论里"可扩展、低成本 agentic Web"的主张。
6. 论证链 #
| # | 论证步骤 | 依据(本文内部) |
|---|---|---|
| 1 | 协调操作本质有界(选任务/判检查/判停止),不需无约束生成 | §1 Para 3 观察 + §3 把协调形式化为 $S_t$ 上的决策 |
| 2 | 因此可用非生成式 System One(Laya)在类型化菜单 $W_t$ 上打分完成协调 | §4.2;$W_t=\text{Compile}(S_t,\chi_t)$ 保证有界动作空间 |
| 3 | 但 System One 需 grounding → 用亚十亿阅读器(Qwen3-0.6B)定位证据 $\ell_t$,绕开 LLM 前向 | §4.1;Eq 4 $\ell_t=R(q,\chi_t)$ |
| 4 | 只把 Eq 5 这唯一一次 LLM 调用用于实质推理,交付不再调 LLM | §4.3 Eq 5 + §4.4 Algorithm 1 "No extra LLM call" |
| 5 | 该分工在 6 基准上精度全胜(93.97%)且 token/延迟大降 | §5.2 Table 1/2 + Fig 3 |
| 6 | 消融证明收益源自 System One 决策质量(vs 随机)与阅读器(vs 去阅读器),且优于把协调交回 GPT | §5.3 Table 3 三条对照 |
| 7 | 机制泛化到结构化网页 QA | §5.4 Table 4 |
7. 实现 cross-reference #
[实现未公开] — 论文未给出公开代码仓库链接;以下为据文本可定位的关键实现细节与引用。
核心技术壁垒(展开) #
真正难复现的不是"用小模型做路由"这个口号,而是让一个非生成式 System One 控制器在没有 LLM grounding 的情况下可靠做协调所需的接口设计:状态 $S_t$ 必须把档案、检查账本、剩余预算压成控制器可消化的结构;检查查询 $\chi_t$ 必须把"检查什么"(选 $C(q)$ 的句子)与"检查哪个答案"(当前候选响应)绑定;证据 $\ell_t$ 必须由 0.6B 阅读器以字符偏移 + verbatim 片段精确回填,既供控制器决策又作 worker 的注意力高亮。四者缺一,System One 要么盲决、要么退化回需要 LLM 读历史。消融里 w/o Reader 掉 1.76 pp、w/ GPT 贵 4 倍却不更准,正是这条接口链不可替代的实证。
关键实现细节(易漏) #
组件与引用映射 #
| 组件 | 实例化 | 引用 |
|---|---|---|
| System One 控制器 | Laya | Convai Innovations 2026, HF convaiinnovations/laya |
| 轻量阅读器 | Qwen3-0.6B(greedy, non-thinking) | Yang et al. 2025, arXiv:2505.09388 |
| LLM worker | GPT-4o(主)/ GPT-4o-mini(消融),temp=1.0 | — |
| 超参 | $B_{out}=2048$, $B_{src}=2048$, $T_{max}=4$, 3 seeds | §5.1 |
| 基准 | MMLU/GSM8K/AQuA/MultiArith/SVAMP/HumanEval/WebSRC | §5.1 |