Introducing AMD CDNA 5 Architecture: Enabling the Future of Frontier AI With the AMD Helios Rackscale Solution
Introducing AMD CDNA 5 Architecture — MI455X / Helios #
AMD | 2026-08 | https://www.amd.com/content/dam/amd/en/documents/products/technologies/cdna/amd-cdna5-whitepaper.pdf Category: hardware | Tags: gpu-architecture, chiplet, mi455x, cdna5, wave32, hbm4, ualink, rackscale Read: 2026-08-12 · 24 pages · 12 figures · 2 endnotes · 0 equations · 0 measured benchmarks
0. 证据分级 #
这是一份厂商白皮书。全篇 24 页没有任何实测数字,两条 endnote 都明确写着
"AMD Performance Labs calculations … compared to published specifications"。
因此本条目对每个非平凡结论标注来源,四类:
| 标记 | 含义 |
|---|---|
| 白皮书 | 文档正文或规格表的原话 / 原始数值 |
| 图像转录 | 从图片栅格读出、但不在 PDF 文本层里的内容(文本层抓取时丢失) |
| 推导 | 由白皮书自身数字算出的一致性检查或推论,文档本身未陈述 |
| ISA 手册 | 与 CDNA5 ISA 参考手册(AMD, 2026-07-27, 823 页)交叉验证;白皮书从未提及这些内容 |
最后一类是本条目价值最高的部分:白皮书宣称"新指令"却不说是哪些,而 ISA 手册
显示矩阵指令集发生了完全的不连续。凡标注 ISA 手册的结论都不得当作白皮书的
陈述来引用。
1. TL;DR #
CDNA 5 把部署单元从 8-GPU 节点抬到 72-GPU 单跳交换共享内存 pod:256 个 WGP 以
Wave32 + 双倍 SIMD 宽度换来 MXFP4 40.26 PF、432 GB HBM4 @ 23.3 TB/s、每 GPU
3.6 TB/s UALoE。24 页零实测。两处高代价的静默变更:MXFP6 从与 MXFP4 同速掉到与
MXFP8 同速;MFMA 全族被 WMMA 取代。
2. 三问 #
Q1 痛点 #
白皮书的问题陈述不是"算力不够",而是部署粒度不对。三条论据:
- 单 token 的代价:LLM 参数进入万亿级后,每输出一个 token 需要"trillions of
- MoE 改变了配比:MoE"总参数多、每 token 只访问一小部分",直接改变
- 8-GPU 一次性部署已经不够:客户"can no longer meet the demands … by deploying
- 计算单元换血:每 XCD 的 32 个 Active CU"被同等数量的 Work Group Processor
- 数值格式下探到可训练的 FP4:共享 scale 的 block 可以是 16 或 32 元素,
- 带宽放大:12 stack HBM4(接口位宽 1024→2048 bit/stack)、192 MB L2 @
- 把机架变成一台机器:36 条 400 Gb/s UALoE 链路 + 12 台以太网交换机全连接,
- 层级实例数:GPU Private (1) → GL2 Private (2) → XCD Private (8) →
- 每 SIMD 128 KB Vector Register + 8 KB Scalar Register(正文只给了
- Broadcast Arbitrator:夹在 WGP 私有存储与 L2 之间的独立部件,与寄存器、
- L2 侧标注 "L2 Cache 96 MB" 与 "27 TB/s/L2",配合 "GL2 Private (2)" 正好是
- FP32 的代际增益(157.3 → 315 TF)全部来自向量 lane 翻倍(16,384 → 32,768
- 既不能 pack、也不能配对的 FP32 代码只能拿到一半峰值(157 TF),**但这在 MI355X
- VOPD 的真实价值不在头条数字,而在于它为无法表达成 packed pair 的代码提供了
- 图 7(图像转录):每 SIMD 128 KB vector register。
- 白皮书:单 wave 可寻址 1,024 reg/thread,前代 MI355X 为 256。
- ISA 手册:
AccVGPR在 823 页中零出现,累加器寄存器文件不再存在。 - INT8 与 INT4 是支持的,但它们既不在 p21 性能表里、也不在 endnote 1 的
- "新增的 MXFP4 分数 scale"被这张图解码了:mxfp4 行的 shared exponent 字段
- "block N × 16/32" 括号确认了两种 block size,与 ISA 手册中同时存在
- accumulator 与操作数现在争同一个寄存器池。AccVGPR 消失(ISA 手册)意味着
- TDM 的 descriptor 从 SGPR 加载并做边界检查。这意味着 tiling 描述符是标量
- 手写矩阵 kernel 必须重写,不是重编译。 MFMA/SMFMAC/AccVGPR 三者同时消失
- async-first 的 kernel 结构第一次在 CDNA 上可行。 TDM(descriptor 从 SGPR
- FP32 向量代码有两条到达峰值的路,且移植不会变差。 315 TF 需要每 lane 每
- 寄存器预算重做。 1,024 reg/thread 的上限意味着满分配 = 每 SIMD 1 个 wave;
- 量化配方要重评(本代对软件影响最大的一条)。 MXFP6 不再与 MXFP4 同速,
- FP64 GEMM 需要新的落地方案,而向量路径同时被加强了。 矩阵 FP64 指令消失
- 通信库简化,但拓扑假设要改。 split DMA 让 RCCL 一类库不必感知 UALoE 拓扑
- 部署与调度软件要认识 vPod。 故障隔离单元是 vPod(若干 Compute Tray,
- 多租户推理有新的隔离面。 boot 时 1/2/4/8 分区 + SR-IOV + fabric 细分 +
- p23 结论把 scale-up/scale-out 的协议写反了:"UALink over Ethernet for
- p17 Compute Tray 段把 scale-out 写成 scale-up:段落在描述 back-end/
- p14 把 N3P 分配给 "FCD 和 MID chiplets",而同段与图 8 的 die 清单只有
- Vulcano NIC 数量不闭合:2 块板 × "four or six" NIC = 8 或 12,而 4 个 GPU
- 图 10 的 per-GPU scale-out 标注与头条数字对不上(图像转录 + 推导):
- UALoE 链路有三种计数口径:正文"36 links × 2 lanes"、图 2"72 lanes"、
- "node" 有两个尺度:图 12 与 §15 的 node = 一个 Compute Tray(4 GPU +
- 一切性能数字均未被独立验证。 本篇无实测,本条目也没有硬件可测;所有 PF /
- 能效无法评估:无 TDP、无瓦数、无 perf/W。第 7 项创新在本篇内不可证伪。
- "sustained throughput"(§8)与 dispatch 延迟改善(§6)没有任何数字,
- Infinity Cache 层级的去向不明(§8.2):本篇既不提它、也不解释 192 MB
- scale-out 的实际可用带宽存疑(§12 第 5 条),43 TB/s 的前置条件未被文档
- INT8/INT4 与 FP64 向量的吞吐未知:格式支持见图 4,但规格表与 endnote 都
- 图 1、图 9、图 11 未在本条目中引用:分别是产品渲染图、机架前后视图与交换
- MI430X 完全在本篇范围之外:文档只以"参见 MI400 系列网页"提及该系列,
- ISA 手册的交叉验证覆盖面:仅覆盖指令/寄存器/opcode 的存在性(MFMA 与
computations and hundreds of billions of DRAM requests"(白皮书;无模型规模、
无 batch size、无 endnote,属于量级修辞而非规格)。
compute:memory-bandwidth 的典型关系(白皮书)。这是文档里唯一一处点名的
workload 结构性变化。
GPUs one system at a time",性能取决于 compute / memory / network / power /
cooling / software / operations 作为一个机架级系统协同工作(白皮书)。
代际对照说得很直白:MI355X 的机架是多个 8-GPU 系统用 RDMA over Ethernet 拼成的
scale-out 集群;MI455X 的机架是一个 72-GPU 的 scale-up 共享内存 pod。
推理收益被明确限定在"models that don't fit within an 8-GPU node"。
Q2 方法 #
七项"key architectural innovations" + CoWoS-L 封装,后续每节 1:1 对应:
| # | 创新 | 载荷数字(白皮书) | 是否有 endnote |
|---|---|---|---|
| 1 | AI 算力 | MXFP4/MXFP8 峰值 FLOPS 4x MI355X | 有(MI400-006) |
| 2 | 计算资源利用率 | "dozens of internal improvements",无数字 | 无 |
| 3 | 内存子系统 | 432 GB HBM4(1.5x),带宽 ~2.9x | 有(MI400-008) |
| 4 | scale-up | 3.6 TB/s,36 条 UALoE,72-GPU pod | 无 |
| 5 | scale-out | 600 GB/s per GPU,6x MI355X | 无 |
| 6 | CPU 耦合 | 256 GB/s Infinity Fabric,cache-coherent | 无 |
| 7 | 能效 | 无任何数字 | 无 |
机制上真正做了四件事:
取代",Wave64 换成 Wave32,每 WGP 4 个 32 线程 SIMD + 4 个标量单元,每时钟可
发起一个新的 32 线程操作。
且 MXFP4 新增分数 scale;白皮书的原话是"Block-level fractional scaling
enables practical FP4 training, reducing quantization error vs. full-tile
scaling"——这是全文唯一一处把新格式与训练(而非仅推理)绑定的论断。
54 TB/s、96 MB LDS,加上两个减流量机制——读多播到多个 WGP、TDM 直接
LDS↔DRAM 传输(不经中间寄存器)。
任意两 GPU 恰好一跳;split DMA 让通信库无需感知 UALoE 拓扑。
核心技术壁垒:不是任何单项峰值,而是 **UALoE 的取舍——用放弃通用网络语义
换来能在封装内摆 36 条链路的紧凑控制逻辑与缓冲区**。白皮书对此异常坦白:UALoE
"isn't intended for general-purpose networking, but only for GPU-to-GPU memory
transactions across short links",所以控制逻辑与数据缓冲比完整以太网 NIC
"much more compact"。这条取舍是 72-GPU 共享内存域在物理上成立的前提,也是最难
被追赶的部分——它要求同时握有 GPU 封装、fabric 协议(Infinity Fabric over
Ethernet lanes)、交换机与整机架设计。详见 §7。
Q3 结果 #
单 GPU 与机架级峰值(白皮书,全部为 peak theoretical):
| 层级 | 数字 |
|---|---|
| MXFP4 | 40.26 PF / GPU;2.9 EF / 机架 |
| MXFP6 = MXFP8 = FP8 | 20.13 PF / GPU |
| Matrix FP16 / BF16 | 5.03 PF / GPU |
| Vector FP16、Matrix/Vector FP32 | 315 TF / GPU |
| HBM4 | 432 GB @ 23.3 TB/s;31 TB @ 1.7 PB/s per rack |
| scale-up | 3.6 TB/s per GPU;260 TB/s per rack |
| scale-out | 600 GB/s per GPU;43 TB/s per rack |
| TDP / perf-per-watt | 全篇不存在 |
必须与峰值同时记住的一句话:文档内没有一个实测数字。§8 声称"significant
improvement in the sustained throughput of a single shared-memory pod",而
文中每一个数字都是 peak 或按公开规格表计算的结果(§5 详述)。
3. 架构图 #
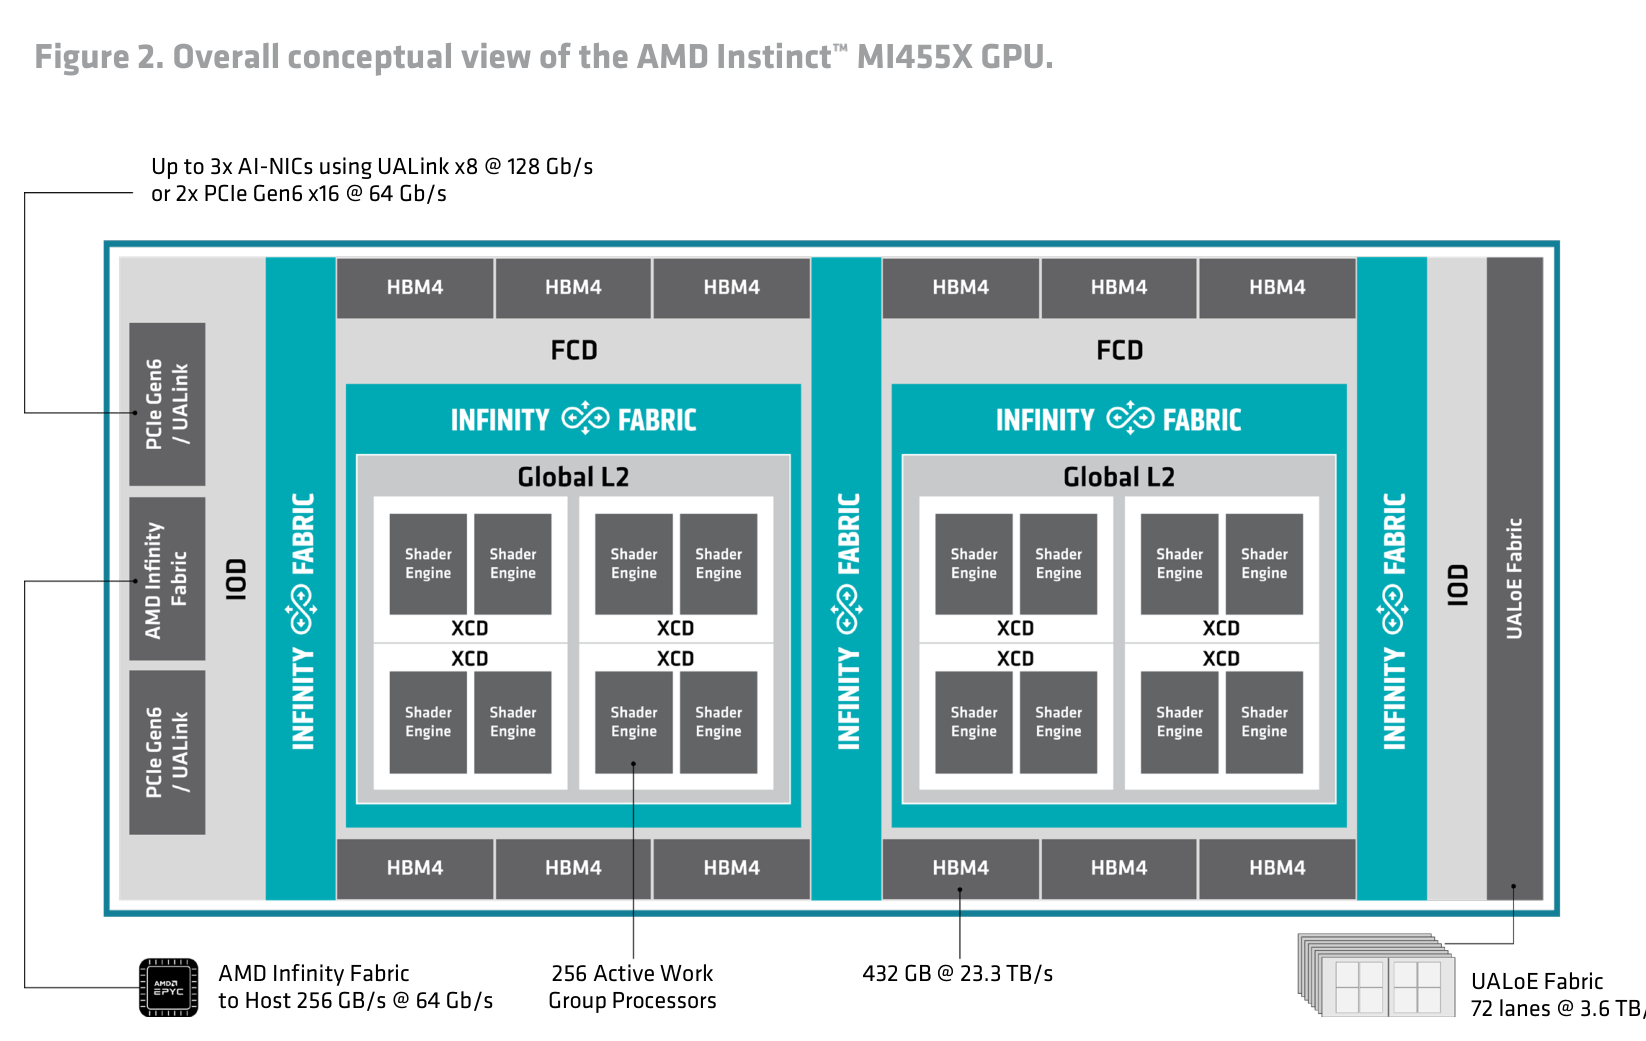
*Paper's Figure 2, verbatim (caption: "Overall conceptual view of the AMD Instinct
MI455X GPU.")*
这张图给出的封装拓扑比正文更清楚,而且多出一个正文没说的层级(图像转录):
8 个 XCD 不是直接挂在 IOD 上,而是**每 4 个 XCD 坐在一个 FCD 上,每个 FCD 自带
一块 "Global L2" 与 6 个 HBM4 stack**;两个 IOD 分列封装左右,左侧承载
2× PCIe Gen6/UALink 与主机 Infinity Fabric,右侧紧邻 UALoE Fabric 列
(72 lanes @ 3.6 TB/s)。每个 XCD 画成 2 个 Shader Engine,与正文的
"2 SE × 16 WGP" 吻合。注意 L2 的归属变了:CDNA 3/4 的 L2 是 per-XCD
(4 MB × 8 = 32 MB),CDNA 5 的 L2 是 per-FCD 的 Global L2(96 MB × 2 =
192 MB)——同一个"L2"名字下换了一级层次结构,白皮书只说容量从 32 MB 变 192 MB,
没提这件事。
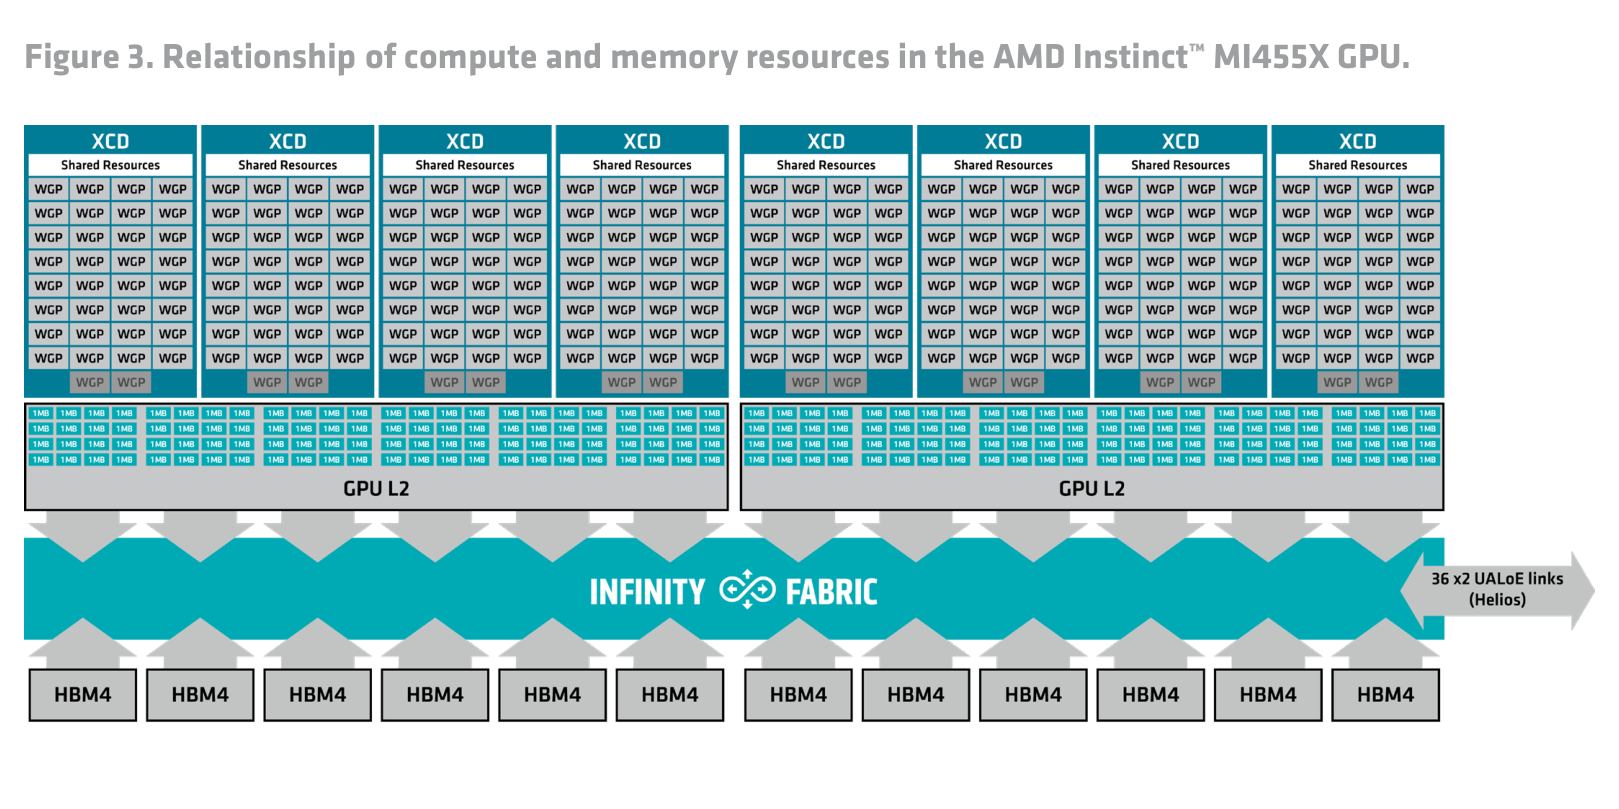
*Paper's Figure 3, verbatim (caption: "Relationship of compute and memory resources
in the AMD Instinct MI455X GPU.")*
放大后每个 XCD 的 WGP 阵列可以数清(图像转录,PDF 文本层无此内容):
8 行 × 4 = 32 个正常色 WGP,下方还有 2 个灰化的 WGP。也就是每 XCD 物理上有
34 个 WGP、开启 32 个,全片 272 物理 / 256 Active——这解释了白皮书为何一律
写 "256 Active Work Group Processors" 和 "32 Active Compute Units",
"Active" 是有内容的词而非修饰。良率裁剪比例 32/34 = 94.1%。图中另外可见:每
XCD 顶部有一条 "Shared Resources" 带(前端/调度资源),L2 画成两组、每组由一
排排 "1MB" 小块组成(对应正文"每个 FCD 96 个 1 MB 块"),底部 12 个 HBM4,
右侧箭头标注 "36 x2 UALoE links (Helios)"。
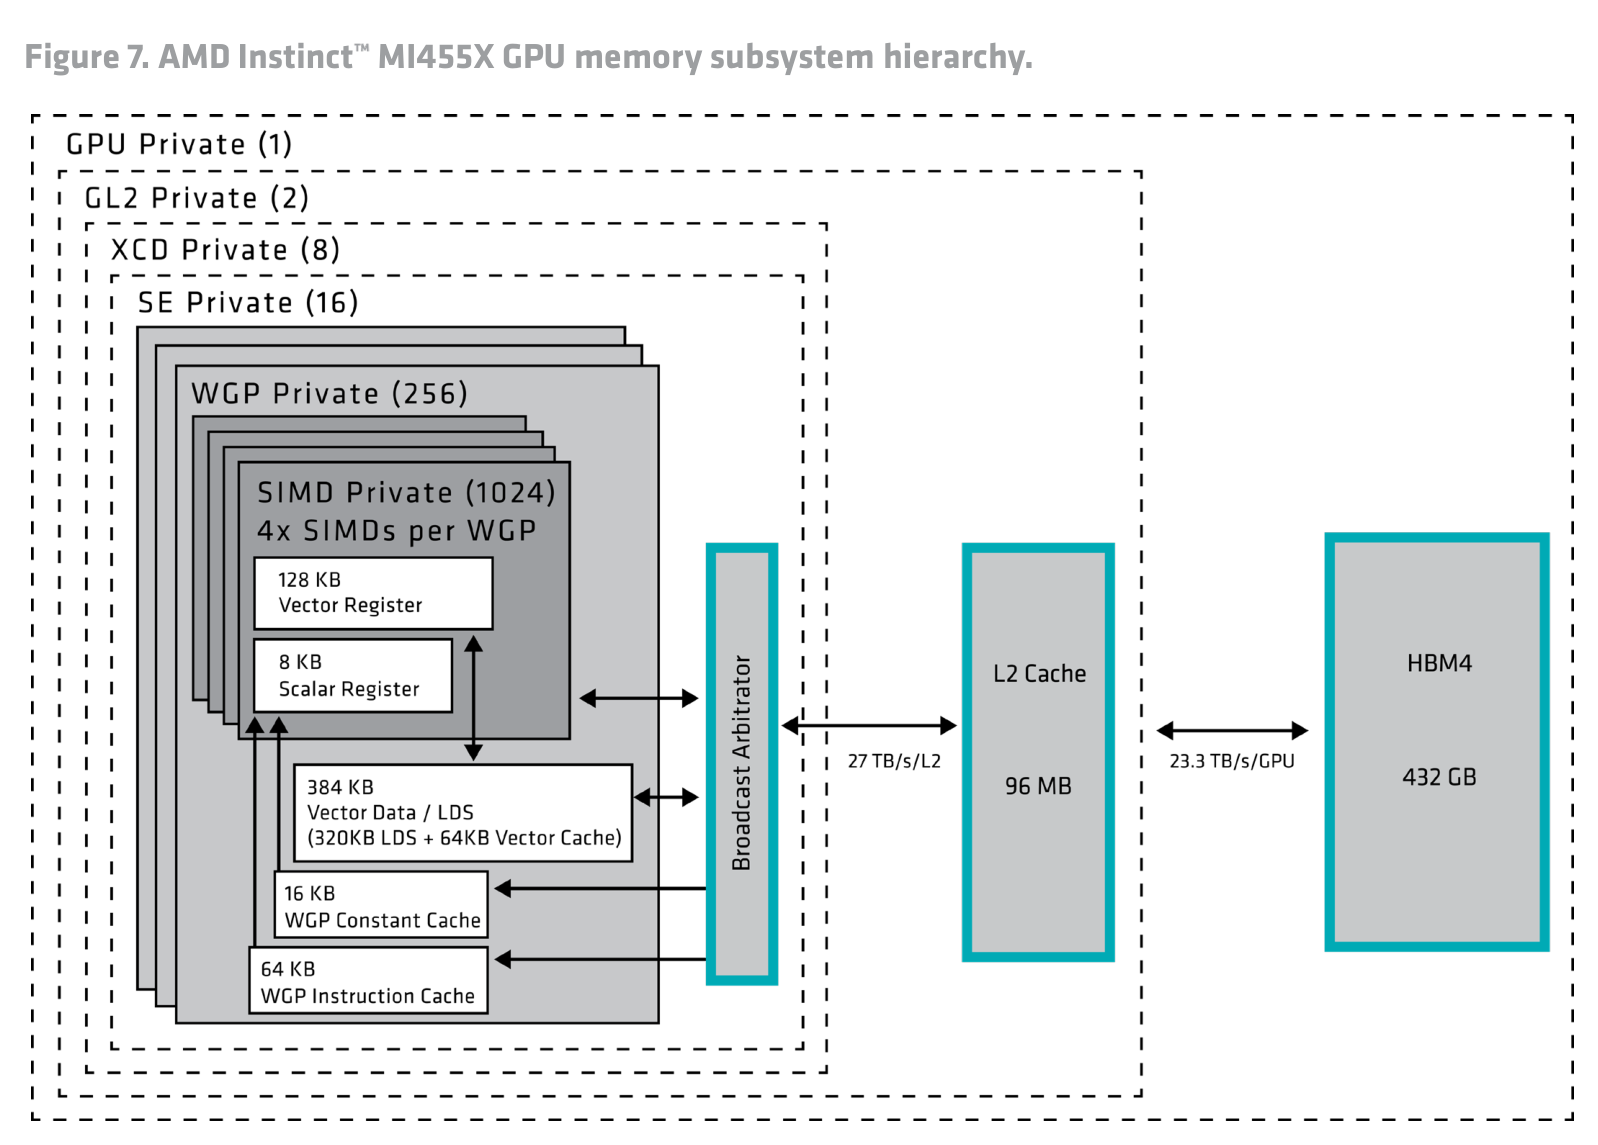
*Paper's Figure 7, verbatim (caption: "AMD Instinct MI455X GPU memory subsystem
hierarchy.")*
这张图是全篇信息密度最高的一张,而它的内容完全不在 PDF 文本层里(图像转录)。
它给出了正文没有的两个数字和一个部件:
SE Private (16) → WGP Private (256) → SIMD Private (1024), 4x SIMDs per WGP。
"1,024 registers per thread" 与 "8 KB per SIMD",没给 VGPR 的 KB 数)。
384 KB LDS 双向连接,并单向填充 16 KB constant cache 与 64 KB instruction
cache。这就是正文所说"一次读操作多播给多个 WGP"的硬件落点,正文从未命名它。
正文的 192 MB / 54 TB/s;HBM4 侧 "432 GB" 与 "23.3 TB/s/GPU"。
顺带提醒一个易混点:96 MB 在本篇里有两个不同含义——每 FCD 的 Global L2 是
96 MB,全片 LDS 聚合也是 96 MB。
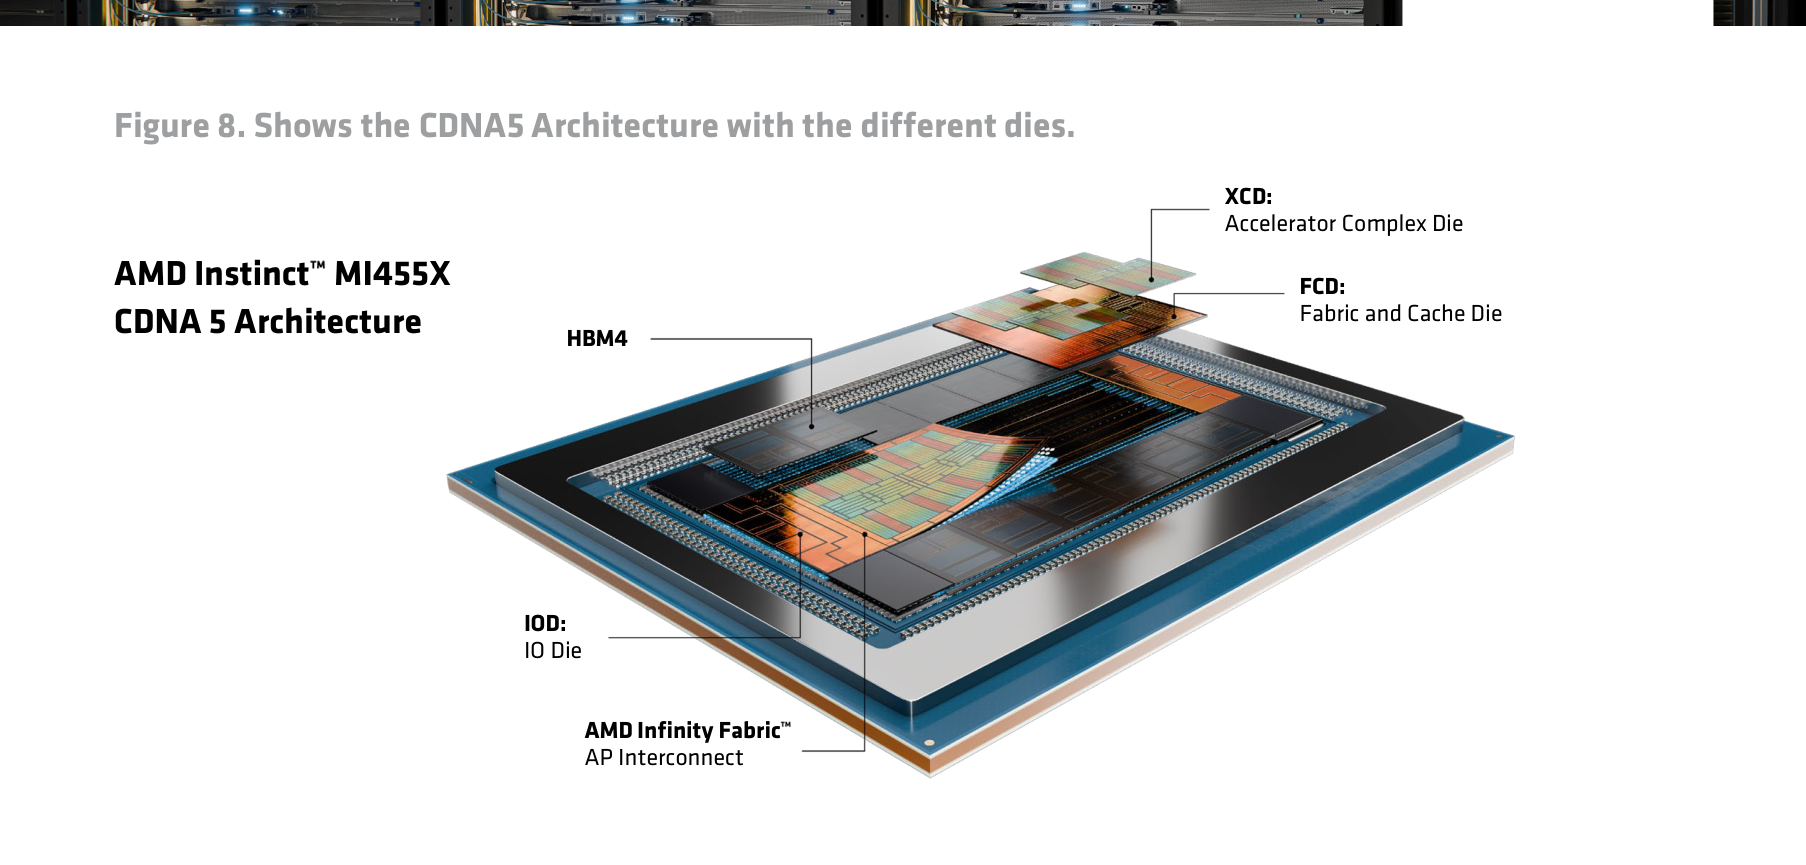
*Paper's Figure 8, verbatim (caption: "Shows the CDNA5 Architecture with the
different dies.")*
封装 die 清单:8 XCD + 2 FCD + 2 IOD + 12 HBM4 stack,CoWoS-L 封装,
die 间标注为 "AMD Infinity Fabric / AP Interconnect"。工艺是分裂的:XCD 用
TSMC N2(2 nm GAA),FCD 用 N3P(3 nm FinFET)。这是 CDNA 线第一次出现 FCD 这
个 die 类型——CDNA 3/4 是 XCD + IOD 两类,缓存与内存控制器在 IOD 上;CDNA 5 把
"fabric + cache" 拆成独立的 FCD,IOD 只剩 I/O。注意 p24 的法务页致谢了 UCIE
商标,但正文对 die-to-die 接口只用 "Infinity Fabric / AP Interconnect" 两个名
字,UCIe 是否被用在封装里无法从本文判定。
上图把三个不同的域画在一起,因为本篇最容易混淆的正是这三者的归属:**UALoE 是
scale-up(共享内存、封装内链路、经交换托盘);RDMA over Ethernet 经 AI-NIC 是
scale-out(pod 间、消息传递、不共享内存);Infinity Fabric 是主机链路**。
p23 的结论段把前两者写反了(§12)。
3.1 WGP 内部与寄存器预算 #
| 层级 | CDNA 5(白皮书 / 图像转录) | 推导出的含义 |
|---|---|---|
| WGP | 4× SIMD32 + 4 标量单元(共享 constant cache) | 每 WGP 128 条 vector lane,是 CDNA 4 每 CU 4× SIMD16 = 64 lane 的 2 倍 |
| 发射 | 每时钟可起一个新的 32 线程操作 | wave32 单周期发射,取代 wave64 的 4 周期节拍 |
| VGPR | 每 SIMD 128 KB;单 wave 可寻址 1,024 reg/thread | $1024 \times 32 \times 4\,\text{B} = 128\,\text{KB}$,即满寄存器分配的 wave 独占整个 SIMD 寄存器堆 |
| 驻留 wave | 每 WGP 64(每 SIMD 16) | 满占用时每线程 $1024/16 = 64$ 个 VGPR |
| SGPR | 每 wave 128 × 4 B → 8 KB/SIMD → 32 KB/WGP | $8\,\text{KB}/(128 \times 4\,\text{B}) = 16$ wave/SIMD,与 64 wave/WGP 自洽 |
| LDS + vector cache | 384 KB/WGP(320 + 64),全片 96 MB | LDS 本身 160 → 320 KB 恰好 2x;白皮书"twice that of the previous generation"要成立,前代须按 160 KB LDS + 32 KB 向量缓存 = 192 KB/CU → 48 MB 计(推导,见下) |
| constant / instruction cache | 16 KB / 64 KB per WGP | 每 WGP 独占 |
4. 作者证明 #
无形式化作者证明 — 仅广告数字。全文 0 个公式、0 个性能投影模型、0 个实测
点。因此本节做的是白皮书唯一可被证伪的东西:规格表的内部自洽性。下面的
推导全部只用白皮书自身的数字(外加两处 ISA 手册交叉验证),任何读者可复算。
4.1 符号 #
| 符号 | 含义 | 值(白皮书) |
|---|---|---|
| $N_{\text{WGP}}$ | 每 GPU 的 Active WGP 数 | 256 |
| $N_{\text{SIMD}}$ | 每 WGP 的 SIMD 数 | 4 |
| $W_{\text{lane}}$ | 每 SIMD 的 lane 宽 | 32 |
| $f$ | 峰值引擎时钟 | 2.4 GHz |
| $W_{\text{stack}}$ | HBM4 每 stack 接口位宽 | 2,048 bit |
| $N_{\text{stack}}$ | HBM4 stack 数 | 12 |
峰值的物理意义只有一条乘法链——单元数 × 每单元每时钟操作数 × 时钟:
$$\text{Peak} = N_{\text{WGP}} \times \left(\frac{\text{FLOP}}{\text{clk}\cdot\text{WGP}}\right) \times f$$
4.2 Vector FP32 的 2 倍缺口 —— 两代共有的口径,不是本代新增的坑 #
规格表给 Matrix/Vector FP32 = 315 TF。按"每 lane 每时钟一个 FMA"算:
$$256 \times 4 \times 32 \times 2\ \frac{\text{FLOP}}{\text{FMA}} \times 2.4\,\text{GHz} = 157.3\ \text{TFLOP/s}$$
正好是标称值的一半。反解每 WGP 每时钟的 FP32 吞吐:
$$\frac{315\ \text{TF}}{256 \times 2.4\,\text{GHz}} = 512\ \frac{\text{FLOP}}{\text{clk}\cdot\text{WGP}} = 2 \times (4 \times 32 \times 2)$$
也就是说标称峰值要求每 lane 每时钟 2 个 FP32 FMA。ISA 手册里有两条路都能达到
这个上限,二者通向同一个天花板、不叠加:
| 路径 | opcode | 代次 | 约束性质 |
|---|---|---|---|
| packed | V_PK_FMA_F32 / V_PK_MUL_F32 / V_PK_ADD_F32 | CDNA 3 起,本代仍然存在 | 数据布局:两个 FP32 要能凑成一对操作数 |
| VOPD 双发射 | 26 条 V_DUAL_* | 本代新增 | 调度:编译器要找到两条互相独立、操作数/寄存器 bank 兼容的 VALU 指令 |
关键在于这个 2 倍不是本代才引入的假设:前代 Vector FP32 = 157.3 TF 同样出自
每 CU 256 FLOP/clk ÷ 64 lane(4× SIMD16)= 每 lane 每时钟 2 个 FMA,与本代每 WGP
512 FLOP/clk ÷ 128 lane 是同一个口径。由此三条结论:
lane),没有任何新指令的贡献。
上同样成立**——移植不会让情况变差,它不是本代新增的陷阱,而是读这一行规格时
两代通用的口径问题。
第二条通往同一上限的路:调度路线而非数据布局路线。这是货真价实的新增能力,
只是与 315 TF 的可达性无关。
白皮书对 packed 与 dual-issue 两者都没有提过一个字,所以"每 lane 一个 FMA"的朴素
读法会把 FP32 峰值算少一半。Vector FP16 也是 315 TF,与 FP32 同速,说明向量侧
没有额外的 FP16 打包收益可用。
4.3 一致性检查表 #
| # | 检查 | 算式 | 结果 |
|---|---|---|---|
| 1 | WGP 计数 | $8\ \text{XCD} \times 2\ \text{SE} \times 16$ | 256 ✓ 与规格表一致 |
| 2 | Vector FP32 | 见 §4.2 | 需每 lane 每时钟 2 个 FMA:packed(CDNA 3 起)或 VOPD(本代新增);前代同口径,代际增益全来自 lane 翻倍 |
| 3 | Matrix FP16 | $5.03\,\text{PF}/(256 \times 2.4\,\text{GHz}) = 8{,}192$ FLOP/clk/WGP | ✓ 恰为 CDNA 4 的 4,096 FLOP/clk/CU 的 2 倍,与"other types 2x"吻合 |
| 4 | MXFP4 | $40.26\,\text{PF}/(256 \times 2.4\,\text{GHz}) = 65{,}536$ | ✓ 为 CDNA 4 的 16,384 的 4 倍,与 4x 宣称吻合 |
| 5 | MXFP6 的降级 | MXFP8 涨 4x ⇒ 前代 5.03 PF;MXFP6 本代 20.13 PF 属"2x 桶"⇒ 前代 10.07 PF | ✓ 与 CDNA 4 规格表的 16,384 FLOP/clk/CU = 10,066 TF 精确吻合,故"前代 MXFP6 = MXFP4"是既成事实而非推断(见 §4.4) |
| 6 | HBM4 每 pin 速率 | $R = 23.3 \times 8/(2048 \times 12)$ | 7.59 Gb/s,低于 HBM4 的 8 Gb/s 基线(见 §4.5) |
| 7 | L2 容量 / 带宽 | $96 \times 1\,\text{MB} \times 2 = 192\,\text{MB}$;$27 \times 2 = 54\,\text{TB/s}$ | ✓ 图 7 的 "96 MB / 27 TB/s/L2" + "GL2 Private (2)" 独立佐证 |
| 8 | LDS 聚合 | $256 \times 384\,\text{KB} = 96\,\text{MB}$ | ✓ |
| 9 | VGPR 堆容量 | $1024 \times 32 \times 4\,\text{B} = 128\,\text{KB}$ | ✓ 等于图 7 的每 SIMD 128 KB;见 §4.6 |
| 10 | SGPR | $128 \times 4\,\text{B} \times 16\ \text{wave} = 8\,\text{KB/SIMD}$,$\times 4 = 32\,\text{KB/WGP}$ | ✓ 与图 7 一致 |
| 11 | 机架三件套 | $72 \times 432\,\text{GB} = 31.1\,\text{TB}$;$72 \times 23.3 = 1.68\,\text{PB/s}$;$72 \times 40.26 = 2.90\,\text{EF}$ | ✓ 全部闭合 |
| 12 | 交换 fabric | $216 \times 400\,\text{Gb/s} = 10.8\,\text{TB/s}$ 单向 → 21.6 双向;$12 \times 21.6 = 259.2$ | ✓ ≈ 260 TB/s;且 $12\ \text{switch} \times 3\ \text{link} = 36$ ✓ |
| 13 | scale-out 机架值 | $72 \times 600\,\text{GB/s} = 43.2\,\text{TB/s}$ | ✓ 数值闭合,但前提是每 GPU 都配满 3 个 NIC(见 §5.4) |
| 14 | 驻留线程数 | 本代 $16\ \text{wave} \times 32 = 512$/SIMD;前代 $8 \times 64 = 512$/SIMD | ✓ 每单元驻留 work-item 数未变(见 §4.6) |
| 15 | LDS "翻倍" | $96\,\text{MB}/2 = 48\,\text{MB} \Rightarrow 192\,\text{KB}$/单元 | ✓ 但须把前代记作 160 KB LDS + 32 KB 向量缓存;只比 LDS 则是 $160 \to 320$ KB,同样是 2x,两种读法都成立 |
4.4 MXFP6 失去了"免费精度"地位(本篇最高代价的静默变更) #
前代 MXFP6 与 MXFP4 同为 10 PF,于是"能用 MXFP6 就别用 MXFP4"是免费的精度
升级——这是 CDNA 4 时期最好用的一条量化经验。本代规格表里
MXFP6 = MXFP8 = 20.13 PF,只有 MXFP4 = 40.26 PF。
用白皮书自己的两条宣称即可反推前代:4x 只适用于 MXFP4 与 MXFP8,其余数据类型是
"up to 2x",MXFP6 不在 4x 名单里 ⇒ 前代 MXFP6 = 20.13/2 = 10.07 PF = 前代 MXFP4。
这个反推与 CDNA 4 规格表直接给出的每时钟数字精确吻合,因此不是推断而是事实:
| 类型 | CDNA 4 FLOP/clk/CU | CDNA 4 峰值 | CDNA 5 峰值 | 倍数 |
|---|---|---|---|---|
| Matrix FP16 / BF16 | 4,096 | 2,516 TF | 5.03 PF | 2x |
| Matrix FP8 / MXFP8 | 8,192 | 5,033 TF | 20.13 PF | 4x |
| Matrix MXFP6 | 16,384 | 10,066 TF | 20.13 PF | 2x |
| Matrix MXFP4 | 16,384 | 10,066 TF | 40.26 PF | 4x |
结论:MXFP6 从"与 FP4 同速"掉到"与 FP8 同速"。 本代选 MXFP6 要付 2 倍吞吐的
代价,而它相对 MXFP8 不再带来任何速度好处——只省内存足迹与带宽。前代那条
"MXFP6 是严格甜点"的结论在本代失效:现在的甜点结构是"要吞吐就 MXFP4(且有了
分数 scale,见 §5.3),要精度就 MXFP8",MXFP6 被挤成一个只在内存受限时才划算的
中间档。
这是本篇对软件影响最大、而白皮书完全没有提示的一处变更:它不体现为任何数字的
下降(MXFP6 的绝对吞吐仍然翻倍了),只体现为格式之间相对次序的重排,因此
只看"每一项都涨了"的读者会完全错过它。CDNA 4 时期基于"MXFP6 免费"建立的量化
配方必须重新评估。
4.5 HBM4:位宽 3 倍,带宽只有 2.9 倍 #
接口位宽从 $8 \times 1024 = 8{,}192$ bit 涨到 $12 \times 2048 = 24{,}576$ bit,
正好 3.0 倍;带宽只有 23.3/8 ≈ 2.91 倍。差额来自每 pin 速率:
$$R_{\text{pin}} = \frac{23.3\,\text{TB/s} \times 8}{24{,}576\ \text{bit}} \approx 7.59\ \text{Gb/s}$$
而前代 8 stack × 1024 bit × 8 Gb/s = 8.192 TB/s(AMD 对外写 8 TB/s)。**若本代
也跑 8 Gb/s,峰值应是 24.58 TB/s。(推导)也就是说 HBM4 这一代是用位宽换
速率**,per-pin 信号速率相对 HBM3E 略有回退,白皮书只强调"位宽翻倍"而没提这
一点。这对功耗有利、对延迟中性,但意味着"HBM4 = 更快的 pin"是错误直觉。
4.6 寄存器堆:容量守恒,AccVGPR 消失 #
白皮书说 VGPR 重组是"while preserving the overall register file capacity"。
把三个来源拼起来正好闭合:
前代每 SIMD 的可寻址寄存器是 256 VGPR + 256 AccVGPR = 512 条 × 64 lane × 4 B =
128 KB;本代是 1,024 条 × 32 lane × 4 B = 128 KB。**容量确实守恒,代价是
accumulator 不再有独立寄存器堆**(推导 + ISA 手册)。对 kernel 的直接后果:
WMMA 的累加器现在与操作数争夺同一个 VGPR 池,前代靠 AccVGPR 免费拿到的一半寄
存器空间没有了,累加器重的矩阵 kernel 需要重新做寄存器预算。
另一个反直觉的结论(推导):每单元驻留 work-item 数没有增加。前代每 SIMD
8 个 wave64 = 512 个 work-item,本代 16 个 wave32 = 512 个。全片
$256 \times 4 \times 512 = 524{,}288$ 个 work-item,两代相同。Wave32 的收益是
粒度(更少的分支分歧浪费、更细的寄存器配额、单周期发射),不是更多的线程级
并行度——白皮书列的三项收益(instruction latency、branch divergence、register
pressure)恰好都是粒度收益,措辞是准确的,但"twice as many resident waves"容易
被误读成 latency-hiding 能力翻倍。
5. 实验与数据 #
5.1 本篇没有实验 #
| 项目 | 数量 |
|---|---|
| 实测 benchmark | 0 |
| 性能投影模型 | 0 |
| 公式 | 0 |
| MFU / achieved utilization 数字 | 0 |
| endnote | 2,均为"按公开规格表计算" |
| 出现过 "sustained" 的宣称 | 1(§8 pod 吞吐),无数字、无 endnote |
两条 endnote 的原文都写明是 AMD Performance Labs 2026 年 6 月的
calculations … compared to published specifications:MI400-006 覆盖 4x
MXFP4/MXFP8 峰值、2x 其他类型、2x 超越函数吞吐;MI400-008 覆盖 1.5x 容量与
~2.9x 带宽。没有 endnote 的宣称是:6x scale-out 带宽、全部能效宣称、
dispatch 延迟/利用率改善、"sustained throughput"、以及 "far beyond the reach of
many competing solutions"。
第 7 项创新是能效,但全篇没有 TDP、没有瓦数、没有 perf-per-watt——一个没有
分母的效率宣称。可核查的只有结构性事实:N2 用于 XCD、N3P 用于 FCD、320 billion
晶体管、12 die + 12 HBM4 stack、液冷、50V DC 母线。而"increase the fraction of system power devoted to computation rather
than moving and managing data"这句话本身是可信的机制描述(多播、TDM、更大的
片上缓存都确实减少数据移动),只是无法被验证。
5.2 唯一的定量图 #
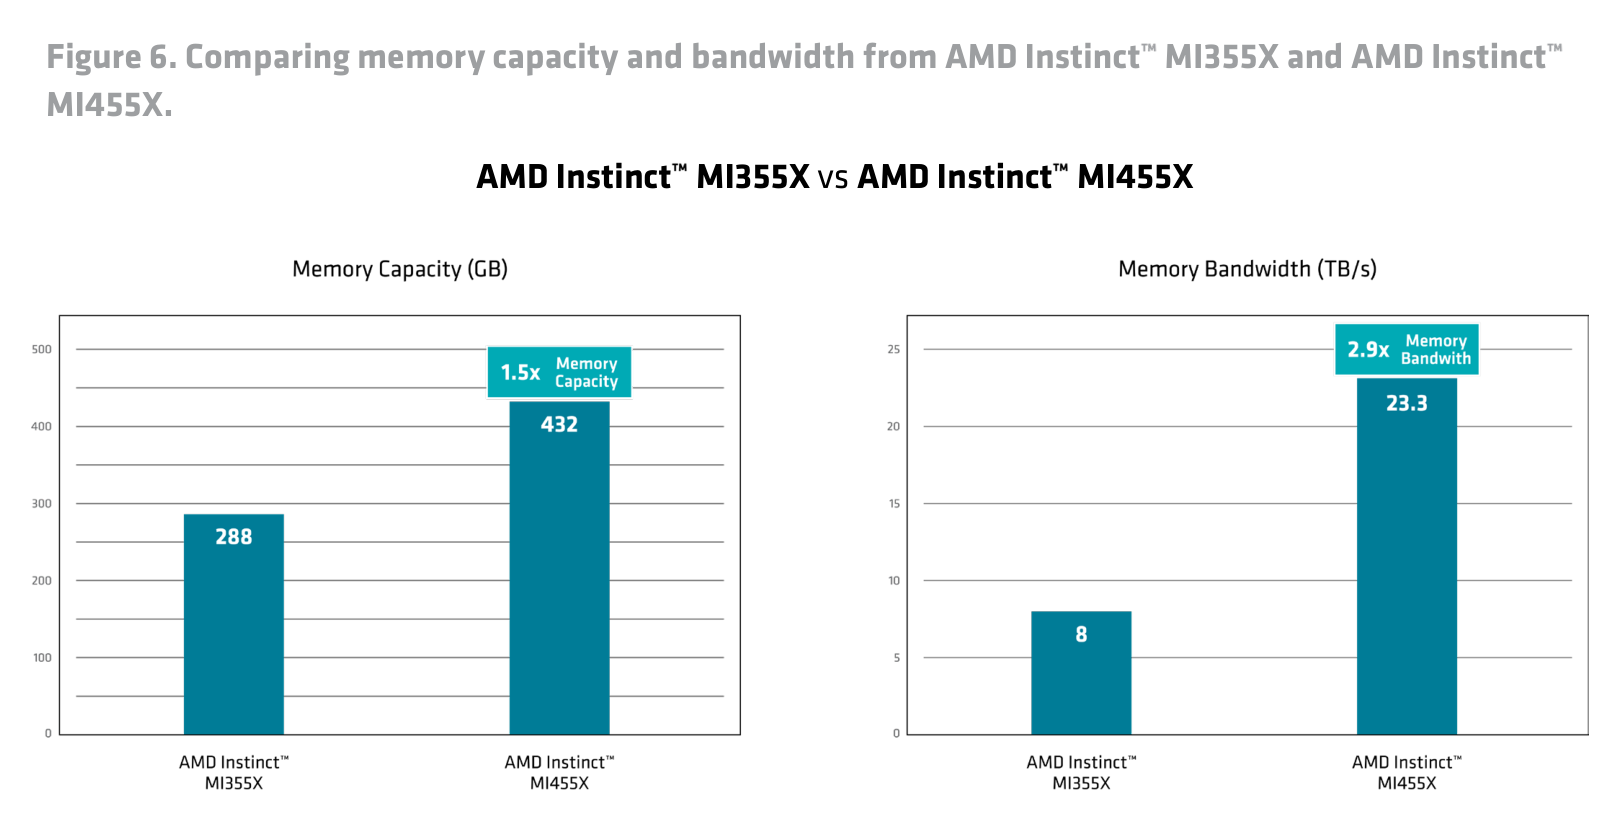
*Paper's Figure 6, verbatim (caption: "Comparing memory capacity and bandwidth from
AMD Instinct MI355X and AMD Instinct MI455X.")*
全篇 12 张图里唯一带坐标轴的一张,两组柱:容量 288 → 432 GB(标注 1.5x)、带宽
8 → 23.3 TB/s(标注 2.9x)。柱值与正文完全一致,没有截断坐标轴或视觉夸大。
值得注意的是它比较的是同一厂商的前后两代而非竞品,且两个倍数都挂着
MI400-008——即"按双方公开规格表算"。换句话说这张图不是实验结果,而是把规格表
画成了柱状图。
5.3 数据格式全表(本图的内容不在文本层里) #
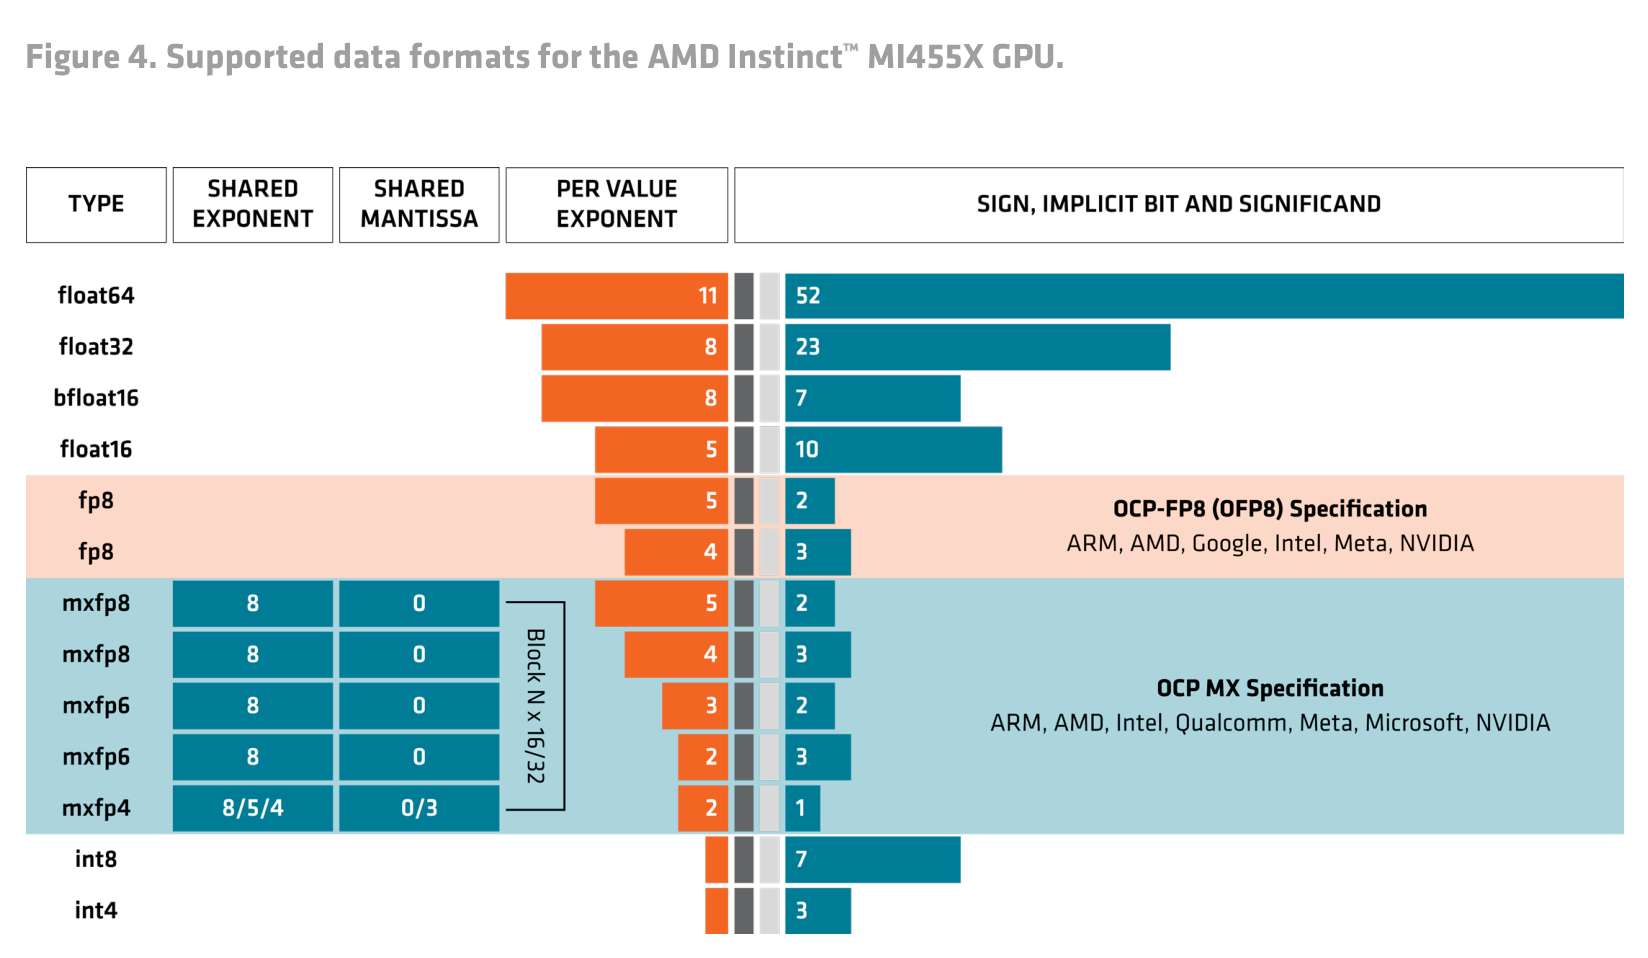
*Paper's Figure 4, verbatim (caption: "Supported data formats for the AMD Instinct
MI455X GPU.")*
这张图的表格内容在 PDF 文本层中丢失,而它是全篇唯一完整的格式枚举。逐行
转录(图像转录):
| TYPE | SHARED EXPONENT | SHARED MANTISSA | PER VALUE EXPONENT | SIGN + IMPLICIT + SIGNIFICAND | 规范分组 |
|---|---|---|---|---|---|
| float64 | — | — | 11 | 52 | — |
| float32 | — | — | 8 | 23 | — |
| bfloat16 | — | — | 8 | 7 | — |
| float16 | — | — | 5 | 10 | — |
| fp8 | — | — | 5 | 2 | OCP-FP8 (OFP8) |
| fp8 | — | — | 4 | 3 | OCP-FP8 (OFP8) |
| mxfp8 | 8 | 0 | 5 | 2 | OCP MX,block N × 16/32 |
| mxfp8 | 8 | 0 | 4 | 3 | OCP MX,block N × 16/32 |
| mxfp6 | 8 | 0 | 3 | 2 | OCP MX,block N × 16/32 |
| mxfp6 | 8 | 0 | 2 | 3 | OCP MX,block N × 16/32 |
| mxfp4 | 8/5/4 | 0/3 | 2 | 1 | OCP MX,block N × 16/32 |
| int8 | — | — | — | 7 | — |
| int4 | — | — | — | 3 | — |
三个只有这张图才能得到的结论:
格式列表里,因此本篇没有给出任何整数吞吐数字。INT4 在 CDNA 线上是新面孔。
float64 仍在支持列表内(作为数据类型),这与 ISA 手册中"不存在 FP64 矩阵指令"
并不矛盾——向量 FP64 与矩阵 FP64 是两件事。
宽度是 "8/5/4"、shared mantissa 是 "0/3"。即 block scale 除了标准 OCP MX 的
E8M0(纯 2 的幂)之外,还可以取带 3 位尾数的形式——scale 本身变成了分数,
而不再只能是 2 的整数次幂。这正是正文那句"a new fractional scale is available
for MXFP4 … enables practical FP4 training"的物理含义:block scale 能更精确地
贴合 block 内的动态范围,量化误差比整幂次 scale 小。
V_WMMA_SCALE_ 与 V_WMMA_SCALE16_ 两族 opcode 对应(ISA 手册)。
另外,本篇规格表没有 sparsity 一栏,全篇也从未出现 sparsity 字样——而 ISA
手册里稀疏矩阵指令 V_SWMMAC_* 是存在的(ISA 手册)。因此:能力仍在,但
本篇引用的全部 PF 数字都应按稠密理解;与 CDNA 4 时代常被引用的"含 2:4 稀疏"
数字对比时必须先对齐口径(本篇 4x 是稠密对稠密)。
5.4 计算与带宽的失衡(推导) #
算力涨 4x(MXFP4/MXFP8),HBM 带宽只涨 2.91x,于是**微缩放格式的 ridge point
被推高了 37%**。以 FLOP per byte of HBM traffic 计:
| 格式 | CDNA 4 ridge | CDNA 5 ridge | 变化 |
|---|---|---|---|
| MXFP4 | 1,258 | 1,728 | 1.37x 更难喂饱 |
| MXFP8 / FP8 | 629 | 864 | 1.37x 更难喂饱 |
| MXFP6 | 1,258 | 864 | 0.69x 更容易 |
| Matrix FP16 / BF16 | 315 | 216 | 0.69x 更容易 |
| Vector FP32 | 19.7 | 13.5 | 0.69x 更容易 |
规律很干净:$4/2.91 = 1.37$、$2/2.91 = 0.69$——落在 4x 桶里的格式变得更
bandwidth-hungry,落在 2x 桶里的格式反而更平衡。白皮书对这个缺口的回答是
"bandwidth amplification"(192 MB L2 @ 54 TB/s、96 MB LDS、读多播、TDM 直连),
但从不给出结果配比。若以 L2 带宽为分母,MXFP4 的 ridge 降到
$40.26\,\text{PF}/54\,\text{TB/s} = 745$ FLOP/byte,仍然很高——**MXFP4 峰值实际
上只对能长驻 LDS/L2 的大 GEMM 有意义**,decode 阶段的 GEMV 与 attention 依然由
23.3 TB/s 决定。
三个域的算力:带宽配比(推导,均为每 GPU、双向):
| 域 | 带宽 | FLOP(MXFP4) per byte | 相对前代 |
|---|---|---|---|
| HBM | 23.3 TB/s | 1,728 | 1.37x 更紧 |
| scale-up | 3.6 TB/s | 11,183 | 1.19x 更紧 |
| scale-out | 0.6 TB/s | 67,100 | 0.67x 更宽松 |
| host | 0.256 TB/s | 157,266 | 1.4x 更紧 |
scale-out 是唯一相对算力变宽松的域(6x vs 4x),这与文档把 MoE 与
expert-parallel 通信当作主要 motivation 是一致的。
5.5 故障域与优雅降级 #
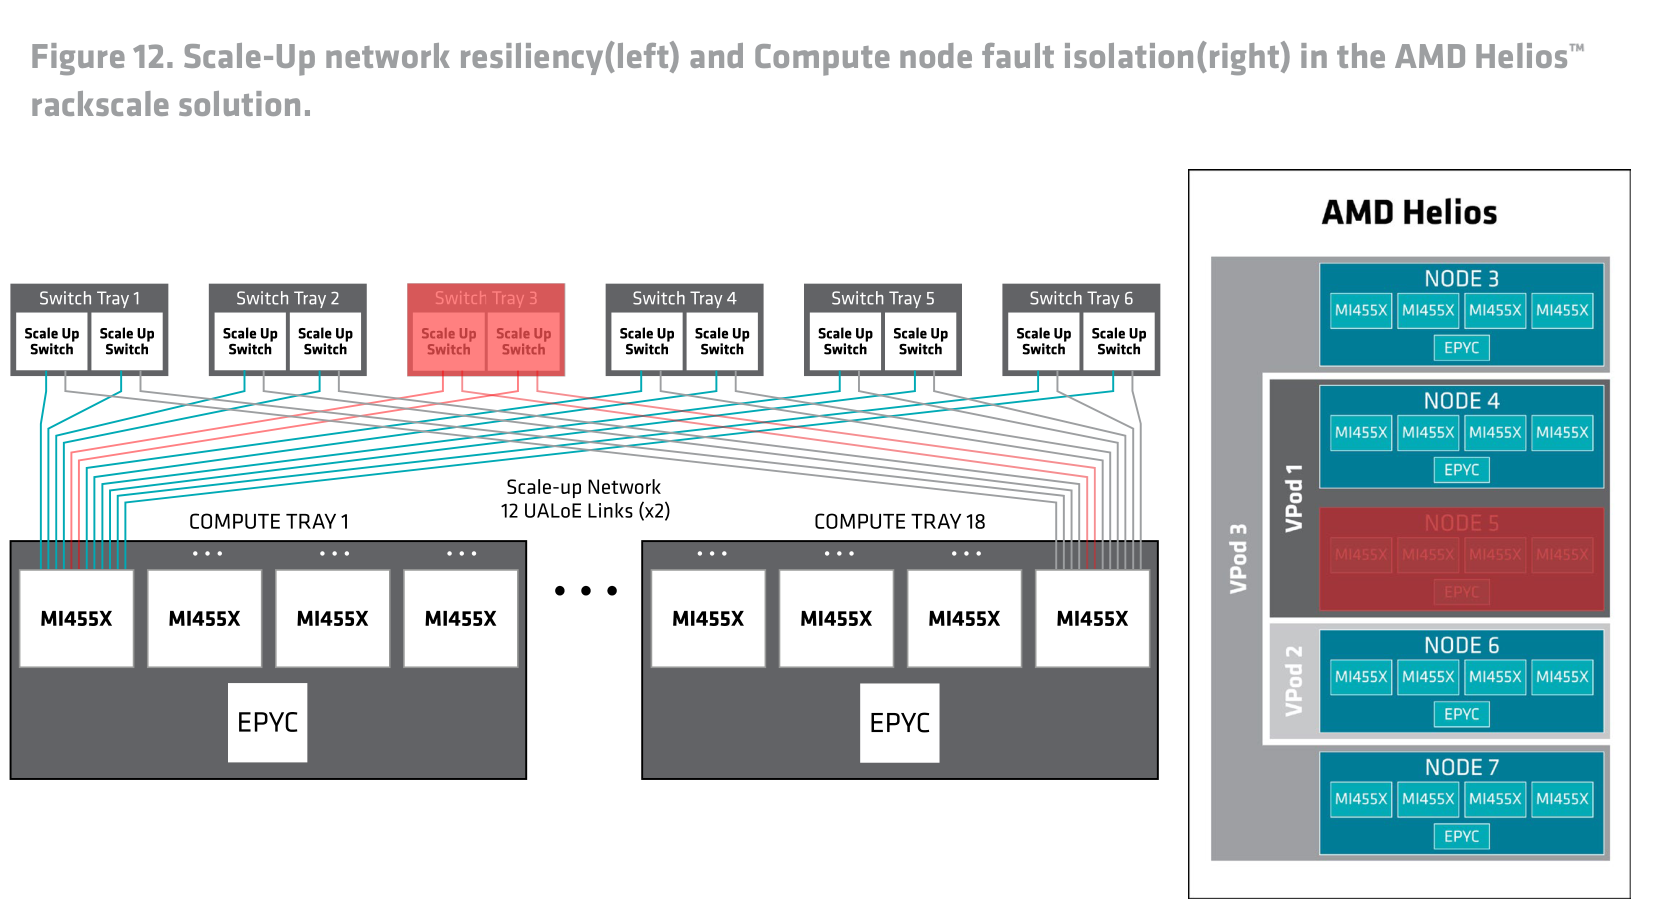
*Paper's Figure 12, verbatim (caption: "Scale-Up network resiliency(left) and Compute
node fault isolation(right) in the AMD Helios rackscale solution.")*
这张图澄清了正文留下的一个歧义(图像转录):**右图里的 "NODE" 就是一个 Compute
Tray**——每个 NODE 画成 4 个 MI455X + 1 个 EPYC。所以正文"node 5 is contained to
vPod 1"说的是一整个托盘(4 GPU)失效,而不是单个 GPU;vPod 则是若干 NODE 的
分组,图中 VPod 1 含 NODE 4–5、VPod 2 含 NODE 6、VPod 3 覆盖外层若干 NODE,
分组大小不等。**故障爆炸半径 = 4 个 GPU + 1 个 CPU,收敛到所属 vPod,可能需要
回滚到 checkpoint**(后半句是正文原话)。
左图画的是 Switch Tray 3 整托盘失效(红色)时链路的重新分布。由此可以算出一个
文档没给的数字(推导):一个交换托盘 = 2 台交换机 = 每 GPU 6 条 UALoE 链路,
失效后每 GPU 剩 30/36 条 → 3.0 TB/s(83.3%),机架从 260 TB/s 降到约
216 TB/s,且因为每台交换机都直连全部 72 个 GPU,**剩余 10 台交换机仍然保持
任意两 GPU 一跳可达**。这是全连接交换拓扑相对 mesh 的实际价值:降级是带宽的
线性损失,不是拓扑的结构性破坏。
6. 论证链 #
严格按文档自身的推理顺序(不含质疑):
| # | 步骤 | 依据(白皮书) |
|---|---|---|
| 1 | AI 需求正在成为史上最大的算力驱动,单 token 需万亿次计算与千亿次 DRAM 请求 | §1 |
| 2 | MoE 让"总参数多、每 token 只用一部分",改变 compute:bandwidth 的典型关系;多模态与专用模型进一步加剧 | §1 |
| 3 | 因此瓶颈不再是"更多算力",而是 compute/memory/network/power/cooling/software/ops 作为一个机架级系统协同 → 部署单元必须是机架 | §1 |
| 4 | 机架级要成立,必须先有一个大的共享内存域:72 GPU 一个 pod,31 TB、1.7 PB/s、2.9 EF | §2、§8 |
| 5 | 大共享内存域需要每 GPU 极多的低延迟链路 → UALoE 放弃通用网络语义,换取紧凑的控制逻辑与缓冲,于是 36 条链路能进封装 | §8 |
| 6 | 全部 scale-up 流量走交换而非直连 mesh,理由有三:单条路由可拿 100% 带宽、软件不必区分快慢路径、所有连接享有同等容错 | §14 |
| 7 | 12 台交换机 × 每 GPU 3 条链路 = 36 条,任意两 GPU 恰好一跳,最小化延迟/功耗/成本 | §14 |
| 8 | 拓扑感知从通信库下沉到硬件:split DMA 前端拆分请求、后端分发到最优链路 | §8 |
| 9 | 单 GPU 算力须同步抬升:Wave32 WGP + 新矩阵指令 + 16/32 元素 block scale + MXFP4 分数 scale,得到 4x(MXFP4/MXFP8)与 2x(其余) | §5、§6 |
| 10 | 算力抬升后数据供给必须跟上:12 stack HBM4(位宽翻倍)、192 MB L2 @ 54 TB/s、96 MB LDS、读多播、TDM 直连 LDS↔DRAM | §7 |
| 11 | 上述每一项都同时减少数据移动 → 系统功耗中用于"算"的比例上升 → 这就是第 7 项创新(能效) | §11 |
| 12 | 最后把它装进可运维的物理形态:OCP ORW 44 OU 机柜、18+6 托盘、盲插铜缆盒、液冷、vPod 故障隔离 | §12–§15 |
7. 实现 cross-reference #
[实现未公开] — 微架构 RTL 与 ROCm 侧的具体实现不随白皮书发布,本篇也没有任何
代码、伪代码或 API。可公开核对的最近表面是指令集本身;下表为与 CDNA5 ISA 参考
手册(AMD, 2026-07-27)交叉验证的结果,白皮书对其中任何一项都没有提及。
| 白皮书的说法 | ISA 手册里的对应物 | 差异性质 |
|---|---|---|
| "adds new instructions"(未列举) | MFMA / SMFMAC / AccVGPR 零出现;矩阵指令为 V_WMMA_ / V_SWMMAC_ | 不是新增,是替换 |
| 未提及 | 不存在 FP64 矩阵指令(前代有 V_MFMA_F64_16X16X4_F64) | 能力删除 |
| 未提及 | 矩阵 tile 只有 16×16(外加一个 32×16 的 FP4 形状);前代 32×32 tile 无后继 | 能力删除 |
| "Wave32 offers improved flexibility for implementing various tile sizes" | 与"只剩 16×16"互为因果:$16 \times 16 = 256 = 8 \times$ wave32 宽度 | 措辞成立但代价未言明 |
| "block scale of 16 or 32 elements" | V_WMMA_SCALE_ 与 V_WMMA_SCALE16_ 两族 | ✓ 一致 |
| Matrix/Vector FP32 = 315 TF | V_PK_FMA_F32 等 packed 指令仍在(CDNA 3 起),另新增 26 条 V_DUAL_* | 峰值需每 lane 2 FMA,两条路皆可;前代同口径(§4.2) |
| "TDM … descriptors loaded from the SGPR … executed asynchronously" | TENSOR_LOAD_TO_LDS / TENSOR_STORE_FROM_LDS(VIMAGE 196/197)、GLOBAL_LOAD_ASYNC_TO_LDS_B{8,32,64,128}、CLUSTER_LOAD_ASYNC、DS_ATOMIC_ASYNC_BARRIER_ARRIVE_B64 | ✓ 一致,且比白皮书描述的更完整 |
| 未提及 | workgroup clusters:最多 16 个 workgroup 组成 cluster,支持 cluster 级 barrier 与 multicast load | 全新编程模型,白皮书零字 |
| LDS 320 KB/WGP + 64 KB WGP$ | 64 bank × 4 B | ✓ 与"384 KB per WGP"一致 |
核心技术壁垒(承接 §2 Q2):UALoE 那条取舍之所以难复制,不在协议本身,而在
它要求同一家把四层同时改掉——GPU 封装里要塞 36 条链路的 PHY 与紧凑控制逻辑;
fabric 要把 Infinity Fabric 的内存语义跑在以太网 lane 上;交换机侧要有 216 端口
× 400 Gb/s 的以太网芯片;机架侧要有盲插铜缆盒把 72×36 条链路无人工插拔地接通。
任何一层缺失,"72 GPU 单跳共享内存"就退化成普通的 scale-out 集群。这也是为什么
文档标题里 Helios 与架构名并列——芯片单独卖的话,第 4/5/6 三项创新有一半兑现
不了(§5.4 的 scale-out 配置问题就是一个具体例子)。
关键实现细节(容易被漏掉的两处):
前代 MFMA kernel 免费拿到的那 128 KB/SIMD 累加器空间没有了;本代 1,024
reg/thread 的上限用满就是每 SIMD 只剩 1 个 wave(§4.6)。移植 WMMA kernel
时寄存器预算必须重算,否则占用率会静默掉到 1/16。
资源(每 wave 128 SGPR,8 KB/SIMD 的预算内),而不是 VGPR;把 5 维 tiling 参数
放进 SGPR 的 kernel 才能真正用上异步直连 LDS↔DRAM 通路。边界检查是硬件强制的,
越界不会静默读到邻居数据。
8. 代际 delta — 增 / 删 / 改 / 增强 #
vs CDNA 4(MI355X)。CDNA 4 一侧的数字优先取本白皮书自己给出的前代值
(32 MB L2、288 GB HBM3E / 8 TB/s / 8 stack / 1,024 bit、每 XCD 32 Active CU、
256 reg/thread、7 条 153 GB/s Infinity Fabric = 1.07 TB/s、单个 400 Gb/s NIC);
其余前代峰值由本篇的 4x / 2x 宣称反推(见 §4.3),少数纯结构参数
(SIMD16 宽度、160 KB LDS、per-XCD 4 MB L2、N3P、185 B 晶体管、36 造/32 开)
取自 CDNA 4 的公开规格,本篇未复述。
8.1 增 #
| 新增 | 内容 | 来源 | 为什么重要 |
|---|---|---|---|
| FCD die 类型 | 2 个 Fabric and Cache Die,N3P,各含 96 MB Global L2 | 白皮书 + 图 2/8 | die 类型从 2 种变 3 种,缓存层级换了归属 |
| VOPD 双发射 | 26 条 V_DUAL_* opcode,含 5 条 FP64(V_DUAL_FMA_F64/ADD_F64/MUL_F64/MAX_NUM_F64/MIN_NUM_F64,限 VOPD3 X slot) | ISA 手册 | 为无法 packed 的代码提供第二条到达同一上限的路;packed FP32 仍在,故不是峰值前提(§4.2)。FP64 那 5 条像是对删除 FP64 矩阵路径的补偿 |
| workgroup clusters | 最多 16 workgroup/cluster,cluster barrier、multicast load | ISA 手册 | CDNA 首次具备 Hopper 式协作组模型 |
| 异步拷贝指令族 | TENSOR_LOAD_TO_LDS、GLOBAL_LOAD_ASYNC_TO_LDS_B*、CLUSTER_LOAD_ASYNC、异步 barrier | ISA 手册 | 与 TDM 一起构成 async pipeline 编程范式 |
| Tensor Data Mover | 每 WGP 一个,理解至多 5 维 tiling,descriptor 来自 SGPR,边界检查,异步执行,支持多播;可 LDS↔DRAM 直连不经寄存器 | 白皮书 | 免去寄存器中转,是"带宽放大"的一半 |
| Broadcast Arbitrator | 位于 WGP 私有存储与 L2 之间的多播仲裁部件 | 图 7 | 读多播的硬件落点 |
| MXFP4 分数 scale | shared exponent 8/5/4 bit + shared mantissa 0/3 bit | 图 4 | 使 FP4 训练可行的关键 |
| 16 元素 block | block N × 16 或 32 | 白皮书 + 图 4 + ISA 手册 | 更细的 scale 粒度 |
BF16 向量原生 + tanh + 新转换指令 | — | 白皮书 | activation/softmax 路径 |
| INT4 | 4 bit 整数(3 bit significand) | 图 4 | 本篇无任何整数吞吐数字 |
| split DMA | 前端拆请求、后端分发到最优链路;额外后端用于片内搬移 | 白皮书 | 通信库不再需要感知拓扑 |
| UALoE + 12 交换机 fabric | 36 × 400 Gb/s,一跳全连接,AES-256-GCM 线上加密,fabric 可细分隔离 | 白皮书 | 72-GPU 共享内存域 |
| 3× AI-NIC scale-out | Vulcano 800,UALink x8 或 PCIe Gen6 x16 挂载 | 白皮书 | 6x(无 endnote) |
| 主机相干 | 16 lane Infinity Fabric,256 GB/s,CPU 可相干缓存访问 GPU 内存,点名 KV cache 共享 | 白皮书 | 全篇唯一把相干性绑定到具体推理数据结构之处 |
| 硅信任根 + SPDM + TEE/Trusted I/O | — | 白皮书 | 多租户与受监管行业 |
| 静态图像解码 | JPEG/MJPEG 40 core | 白皮书 | 前代仅列 4 组视频解码 |
8.2 删 #
| 删除 | 证据 | 影响 |
|---|---|---|
| MFMA 整个指令族 | MFMA/SMFMAC 在 823 页中零出现(ISA 手册) | 所有手写/内联 MFMA kernel 必须重写为 WMMA;这是本代最大的移植成本 |
| AccVGPR 寄存器堆 | 零出现(ISA 手册) | 累加器与操作数共用 VGPR 池(§4.6、§7) |
| FP64 矩阵指令 | 前代有 V_MFMA_F64_16X16X4_F64,本代不存在(ISA 手册) | FP64 GEMM 只能走向量路径;同代新增 5 条 FP64 双发射 opcode 作为补偿(§11 第 6 条) |
| FP64 的规格数字本身 | 前代规格表明确列 Vector FP64 = Matrix FP64 = 78.6 TF;本代 p21–22 规格表没有 FP64 行(图 4 仍列 float64 为支持格式) | 从"报"到"不报"。前代把 FP64 matrix 减半已被读作 AI-first 的信号,本代把 FP64 从对外口径里整体拿掉,完成了这条弧线——FP64 不再是这条产品线宣传面的一部分 |
| 32×32 矩阵 tile | 本代只有 16×16(含一个 32×16 FP4 形状)(ISA 手册) | 按 32×32 调优的 tile/流水需重新分块 |
| Wave64 | 白皮书明说被 Wave32 取代 | 依赖 wave64 内隐式 lane 布局的代码需改 |
| Infinity Cache 层级 | 白皮书从未出现该词;L2 对比只写 32 MB → 192 MB | 前代 IOD 上的 memory-side LLC 层在本篇中无对应物;是被 FCD Global L2 合并还是并存,无法从本文判定 |
| sparsity 口径 | 规格表无稀疏列,全篇无 sparsity 字样;但 ISA 有 V_SWMMAC_*(ISA 手册) | 能力在、数字不在;跨代比较须先对齐稠密/稀疏口径 |
8.3 改 #
| 变更 | CDNA 4 | CDNA 5 | 备注 |
|---|---|---|---|
| 计算单元 | 32 Active CU/XCD,4× SIMD16 = 64 lane | 32 Active WGP/XCD,4× SIMD32 = 128 lane | 白皮书写"an equal number",数量相同但每单元向量宽度翻倍——不是改名 |
| 物理 / 开启单元 | 36 造 / 32 开 | 34 造 / 32 开(图 3 有 2 个灰化 WGP) | 良率裁剪 94.1% |
| L2 归属 | per-XCD 4 MB × 8 = 32 MB | per-FCD Global L2 96 MB × 2 = 192 MB @ 54 TB/s | 换了一级层次,白皮书只报容量 |
| 寄存器可寻址 | 256 VGPR + 256 AccVGPR | 1,024 统一 VGPR,无 AccVGPR | 容量守恒(128 KB/SIMD) |
| XCD 工艺 | N3P | N2(2 nm GAA) | FCD/IOD 留在 N3P |
| die 清单 | 8 XCD + 2 IOD | 8 XCD + 2 FCD + 2 IOD | CoWoS-L |
| HBM | 8 stack HBM3E,1,024 bit/stack,8 Gb/s | 12 stack HBM4,2,048 bit/stack,≈7.6 Gb/s(推导) | 位宽换速率(§4.5) |
| scale-up | 7 条 Infinity Fabric @ 153 GB/s = 1.07 TB/s,8-GPU 全连接 | 36 条 UALoE @ 400 Gb/s = 3.6 TB/s,72-GPU 单跳交换 | 域规模 9x,带宽 ≈3.4x |
| scale-out | 1 NIC @ 400 Gb/s | 至多 3 NIC @ 800 Gb/s | 6x(无 endnote,且见 §5.4) |
| NUMA 粒度 | 2 IOD → NPS 2 上限 | 2 内存侧 die → NPS 2 上限(未变) | 见下方 NPS 解释 |
| 机架形态 | 19" 机架,8-GPU UBB | OCP ORW 1.2 m × 1.3 m,44 OU,18+6 托盘 | 1 OU = 48 mm |
为什么 DPX/QPX/CPX 全是 NPS 2(推导;文档只给表不给解释):NPS 域数由**内存侧
die 的数量**决定,与 stack 和 XCD 的比例无关。这条在 CDNA 4 上有明确记载——NPS 域
就是 "1 per IOD":CDNA 3 的 4 个 IOD 支持到 NPS 4,CDNA 4 并到 2 个 IOD 后上限即
降为 NPS 2(每 IOD 挂 4 个 HBM stack)。CDNA 5 仍是 2 个内存侧 die,所以 NPS 上限
仍是 2。这不是本代新增的代价,而是 CDNA 4 就已确立的形态:XCD 分区可细到 8 份,
内存交织域却停在 die 边界,于是 1-XCD 的 CPX 分区与 4-XCD 的 DPX 分区看到的是同一个
NPS 2 内存视图。
两点需要澄清,因为它们看似成立但都不对:其一,12 stack / 8 XCD = 1.5 的非整数比
不构成障碍——NPS 4 只需 12/4 = 3 个 stack 一域,是整数,并不存在"切开半个 stack"
的问题;其二,前代 8 stack / 8 XCD 虽是 1:1 的整数比,同样只到 NPS 2,可见比例
不是决定因素。另需注意,白皮书从未把 HBM stack 绑定到具体 FCD(Figure 2 只标
432 GB @ 23.3 TB/s),"每 FCD 6 stack"是按 12/2 推的,不是原文。
8.4 增强 #
| 项目 | CDNA 4 | CDNA 5 | 倍数 |
|---|---|---|---|
| MXFP4 峰值 | 10.07 PF | 40.26 PF | 4x(endnote) |
| MXFP8 / FP8 | 5.03 PF | 20.13 PF | 4x(endnote) |
| MXFP6 | 10.07 PF(推导) | 20.13 PF | 2x(相对 MXFP4 降级,§4.4) |
| Matrix FP16/BF16 | 2.52 PF | 5.03 PF | 2x |
| Vector FP32 | 157.3 TF | 315 TF | 2x(全部来自 lane 翻倍;每 lane 2 FMA 的口径两代相同,§4.2) |
| 超越函数吞吐 | 基线 | 2x | endnote |
| HBM 容量 / 带宽 | 288 GB / 8 TB/s | 432 GB / 23.3 TB/s | 1.5x / 2.91x |
| L2 容量 | 32 MB | 192 MB | 6x |
| LDS(含向量缓存)每单元 / 聚合 | 192 KB/CU / 48 MB | 384 KB/WGP / 96 MB | 2x / 2x |
| 驻留 wave 每单元 | 32 | 64 | 2x(work-item 数不变,§4.6) |
| 单 wave 可寻址寄存器 | 256/thread | 1,024/thread | 4x |
| scale-up 每 GPU | 1.07 TB/s | 3.6 TB/s | ≈3.4x |
| scale-up 域 | 8 GPU | 72 GPU | 9x |
| 晶体管 | 185 B | 320 B | 1.73x |
9. 完整规格表 #
| 分类 | 参数 | 值 |
|---|---|---|
| 架构 | 架构 / 产品 | AMD CDNA 5 / Instinct MI455X(MI430X 本篇未涉及) |
| die 清单 | 8 XCD + 2 FCD + 2 IOD + 12 HBM4 stack,CoWoS-L | |
| 工艺 | XCD:TSMC N2(2 nm GAA);FCD:N3P(3 nm FinFET);IOD 未明说 | |
| 晶体管 | 320 billion | |
| 计算 | Active WGP | 256(8 XCD × 2 SE × 16 WGP;物理 34/XCD,图 3) |
| 每 WGP | 4× SIMD32 + 4 标量单元 + 1 TDM | |
| wave | Wave32,每时钟可发起一个 32 线程操作 | |
| 峰值时钟 | 2,400 MHz | |
| 峰值(稠密) | MXFP4 | 40.26 PF |
| MXFP6 / MXFP8 / FP8 | 20.13 PF | |
| Matrix FP16 / BF16 | 5.03 PF | |
| Vector FP16 | 315 TF | |
| Matrix/Vector FP32 | 315 TF(需每 lane 每时钟 2 个 FMA:packed 或 VOPD) | |
| INT8 / INT4 | 支持(图 4),无吞吐数字 | |
| FP64 | 向量支持(图 4);无矩阵指令(ISA 手册) | |
| 内存 | HBM4 | 432 GB,2,048 bit × 12 stack,23.3 TB/s(≈7.6 Gb/s per pin,推导) |
| L2 | 192 MB = 96 × 1 MB × 2 FCD,54 TB/s(27 per FCD) | |
| LDS + vector cache | 384 KB/WGP(320 + 64),聚合 96 MB | |
| VGPR / SGPR | 128 KB / 8 KB per SIMD(图 7);1,024 reg/thread;128 SGPR/wave | |
| constant / instruction cache | 16 KB / 64 KB per WGP | |
| 驻留 wave | 64 per WGP(16 per SIMD) | |
| 互联 | scale-up | 36 UALoE 链路 × 2 lane,400 Gb/s each,3.6 TB/s 双向 |
| scale-up 机架 | 12 交换机 × 216 链路 = 21.6 TB/s each;260 TB/s;任意两 GPU 一跳 | |
| scale-out | 2× PCIe Gen6 x16 @ 64 Gb/s 或 3× AI-NIC via UALink x8 @ 128 Gb/s;每 NIC ≤800 Gb/s = 200 GB/s;600 GB/s per GPU;43 TB/s per rack | |
| 主机 | Infinity Fabric x16,256 GB/s 双向,cache-coherent | |
| 虚拟化 | 分区 | SPX/DPX/QPX/CPX = 1/2/4/8 分区,8/4/2/1 XCD,432/216/108/54 GB;boot 时配置 |
| NUMA | SPX 为 NPS 1,其余全为 NPS 2 | |
| SR-IOV | 是 | |
| 安全 | — | 硅信任根 + DMTF SPDM;TEE + Trusted I/O;UALoE AES-256-GCM(可选);TDM descriptor 边界检查;fabric 细分隔离 |
| RAS | — | RAS 支持、page retirement |
| 媒体 | — | 4 个视频解码引擎(HEVC/H.265、AVC/H.264、VP9、AV1);40 个 JPEG/MJPEG core |
| 封装/供电 | 形态 | Enhanced Accelerator Module,液冷 |
| TDP / perf-per-watt | 本篇不存在 | |
| 机架 | Helios | ORW 1.2 m × 1.3 m,44 OU(1 OU = 48 mm);18 Compute Tray(4 GPU + 1 EPYC 9G76 96C + 1 TB DDR5 + 5× E1.S)+ 6 Switch Tray(2 交换机 + Ryzen + M.2)+ 4 铜缆盒;50V DC;盲插液冷 |
| Helios 聚合 | 72 GPU、18 CPU、31 TB HBM4、1.7 PB/s、2.9 EF MXFP4、260 TB/s scale-up、43 TB/s scale-out |
10. 竞争定位 #
本篇没有点名任何竞品,也没有给出任何对比数字;"far beyond the reach of many
competing solutions"(p3)既无 endnote 也无对照件,按文档自身无法评估。因此这里
只做一处口径明确的结构性对照,其余留给跨篇层:
| 轴 | MI455X / Helios(本篇) | 说明 |
|---|---|---|
| scale-up 域规模 | 72 GPU 单跳交换共享内存 | 与当前业界机架级单元同量级;这是本代追平的主要方向 |
| scale-up 每 GPU 双向带宽 | 3.6 TB/s | 按同一口径(每 GPU 双向 × 72),NVLink5 一代为 1.8 TB/s ⇒ 本代约 2x(外部公开规格,非本篇内容) |
| 单 GPU HBM 容量 | 432 GB | 容量优势是 AMD 从 CDNA 3 起延续的差异点 |
| 协议路线 | UALoE / UALink + 标准以太网交换机 + ORW + OCP 数据格式 | 文档反复强调"开放、无专有锁定",把这当作与专有互联并列的产品属性 |
需要提醒的是:跨厂商 FLOPS 对比在本代特别容易出错,因为本篇全部数字是稠密
口径且不提 sparsity(§5.3),而竞品与前代常引用含 2:4 稀疏的数字。对比前必须
先对齐稠密/稀疏与 peak/sustained 两个口径。
11. 硬件 → 软件的前向影响 #
按"因为这代硬件,可以/必须写什么新软件"排列:
(ISA 手册),矩阵路径改为 V_WMMA_/V_SWMMAC_,tile 只剩 16×16。
受影响最重的是按 32×32 MFMA 手工排流水的库(CK、rocBLAS 的汇编内核、
Triton 的 AMD 后端 lowering、以及一切内联 __builtin_amdgcn_mfma_* 的代码)。
白皮书那句"exposed to developers through ROCm … without requiring
application-specific optimizations"对框架用户成立,对写 kernel 的人不成立。
加载、异步、多播、LDS↔DRAM 直连)+ GLOBAL_LOAD_ASYNC_TO_LDS_B* +
CLUSTER_LOAD_ASYNC + 异步 barrier + 最多 16 workgroup 的 cluster
(ISA 手册),构成一套 producer/consumer 流水的完整原语。这意味着
Hopper 风格的 warp-specialized GEMM/attention 结构可以移植过来,而 CDNA 4
上只能用 L1→LDS 直读近似。
时钟 2 个 FMA,可走 packed(V_PK_FMA_F32,CDNA 3 起,本代仍在)或 VOPD 双
发射(本代新增);两者通向同一上限、不叠加,两条都走不通就只有 157 TF——而这
在 MI355X 上同样成立(§4.2)。本代真正多出来的是一条不依赖数据布局的路:
凑不成 pair 的两条独立 FMA 链现在可以靠调度配对。
AccVGPR 没了,累加器占用操作数同池(§4.6、§7)。占用率与 tile 大小的
trade-off 曲线整条移位,auto-tuner 的搜索空间必须重设。
前代 16,384 FLOP/clk/CU 的并列关系被打破(§4.4),"免费的 6 bit"消失;
反过来 MXFP4 拿到分数 block scale 与 16 元素 block(图 4),FP4 训练从
"精度不够"变成"值得试"。框架侧需要支持带尾数的 block scale 编码,这不是
标准 OCP MX E8M0 的编码路径。
(ISA 手册),只剩向量 FP64;依赖 FP64 MFMA 的 HPC 库要么退回向量路径,要么
走精度补偿算法。值得注意的是 ISA 同代新增了 5 条 FP64 双发射 opcode
(V_DUAL_FMA_F64 / ADD_F64 / MUL_F64 / MAX_NUM_F64 / MIN_NUM_F64,
均限于 VOPD3 的 X slot)——矩阵路被删的同一代,向量路拿到了吞吐机制,这读起来
像是刻意的补偿而非巧合。
(白皮书),同时 72-GPU 单跳全连接使"任意两 GPU 等距"成为可依赖的前提——
ring/tree 的拓扑感知优化在 pod 内失去意义,all-to-all(MoE expert 路由)成为
一等公民。跨 pod 仍是 RDMA over Ethernet,两套语义的边界正好落在 pod 边界上。
每 Tray 4 GPU + 1 CPU,图 12),且可能需要 checkpoint 回滚;调度器与
checkpoint 策略应按 4-GPU 托盘粒度对齐,而不是单 GPU 粒度。
可选 AES-256-GCM + guest VM 安全域跨 GPU 透明扩展(白皮书),使
"一个物理机架切给多个租户"在硬件层面成立;但 NPS 停在 2(§8.3)意味着
CPX 的 8 个分区在内存交织视角上并不各自独立。
12. 源文档缺陷 #
按对读者的危害排序,均简述:
scale-out, RDMA over Ethernet for scale-up"——正文 §2/§8/§9 一致地是相反的
(UALoE = scale-up,RDMA over Ethernet = scale-out)。结论句是孤例。
scale-out 网络与 Vulcano NIC 板,末句却说"provide the scale-up ports for
the four GPUs"。scale-up 从不经 NIC。
XCD/FCD/IOD/HBM4。MID 要么是 IOD 的内部代号,要么是一个从未给出数量的第四种
die。
× 至多 3 NIC = 12。只有 12 的情形才支撑 600 GB/s per GPU 与 43 TB/s per rack;
文档不说 Helios 用的是哪一种。这是全篇唯一以区间给出的部件数量。
Compute Tray 图标注 "UALink128: 256 GB/s (Bi-Dir) per GPU",即每 GPU 一条
x8 UALink128 挂载($8 \times 128\,\text{Gb/s} \times 2/8 = 256$ GB/s);而
600 GB/s 的头条需要 3 个 NIC、按 §9 的挂载方式需要 3 条 x8 UALink(768 GB/s
的挂载带宽)。若 Helios 每 GPU 只有一条 x8,则机架 scale-out 上限约
$72 \times 256\,\text{GB/s} = 18.4$ TB/s,而非 43 TB/s。也可能图中只画/标了
一条代表性链路。**这恰好落在唯一没有 endnote 的头条倍数(6x scale-out)上,
是按此文档做集群规模设计前必须向厂商确认的第一个数字。**
图 12"12 UALoE Links (x2)"。前两者等价;图 12 的 12 与每 GPU 36 条链路
(12 交换机 × 3)无法直接对上,很可能是每 GPU 每交换机只画一条代表线的简化。
1 CPU);p23 却把整个 72-GPU 机架称作"a single node"。
13. 未能验证的部分 #
TB/s 都是"AMD 声称的峰值",§4 只能证明它们内部自洽,不能证明可达。
无法与峰值对齐。
Global L2 是否吸收了它,聚合 LLC 容量是升还是降无法判定。
确认。
不含它们。FP64 的情况尤其明确——规格表连一行都没有,而前代是明确列出
78.6 TF 的(§8.2)。
托盘照片,其文字标注已在结构与规格表中体现,图片本身不再承载额外信息。
所有架构陈述都针对 MI455X。
AccVGPR 的缺席、FP64 矩阵指令的缺席、WMMA 与 scale 族的存在、TDM 与 cluster
指令、VOPD 计数与其中 5 条 FP64、packed FP32 三条指令的留存、LDS bank
结构)。未验证任何延迟、吞吐或 tile 的时序数字——这类数字既不在白皮书里,
也不是 ISA 手册的内容。特别地,packed 与 VOPD 两条路各自的实际可达效率
(编译器配对率、bank 冲突)无法从任何一份文档判定。